가중치를 직접 고쳐 보았다: Weight-Space Programming 실험 노트
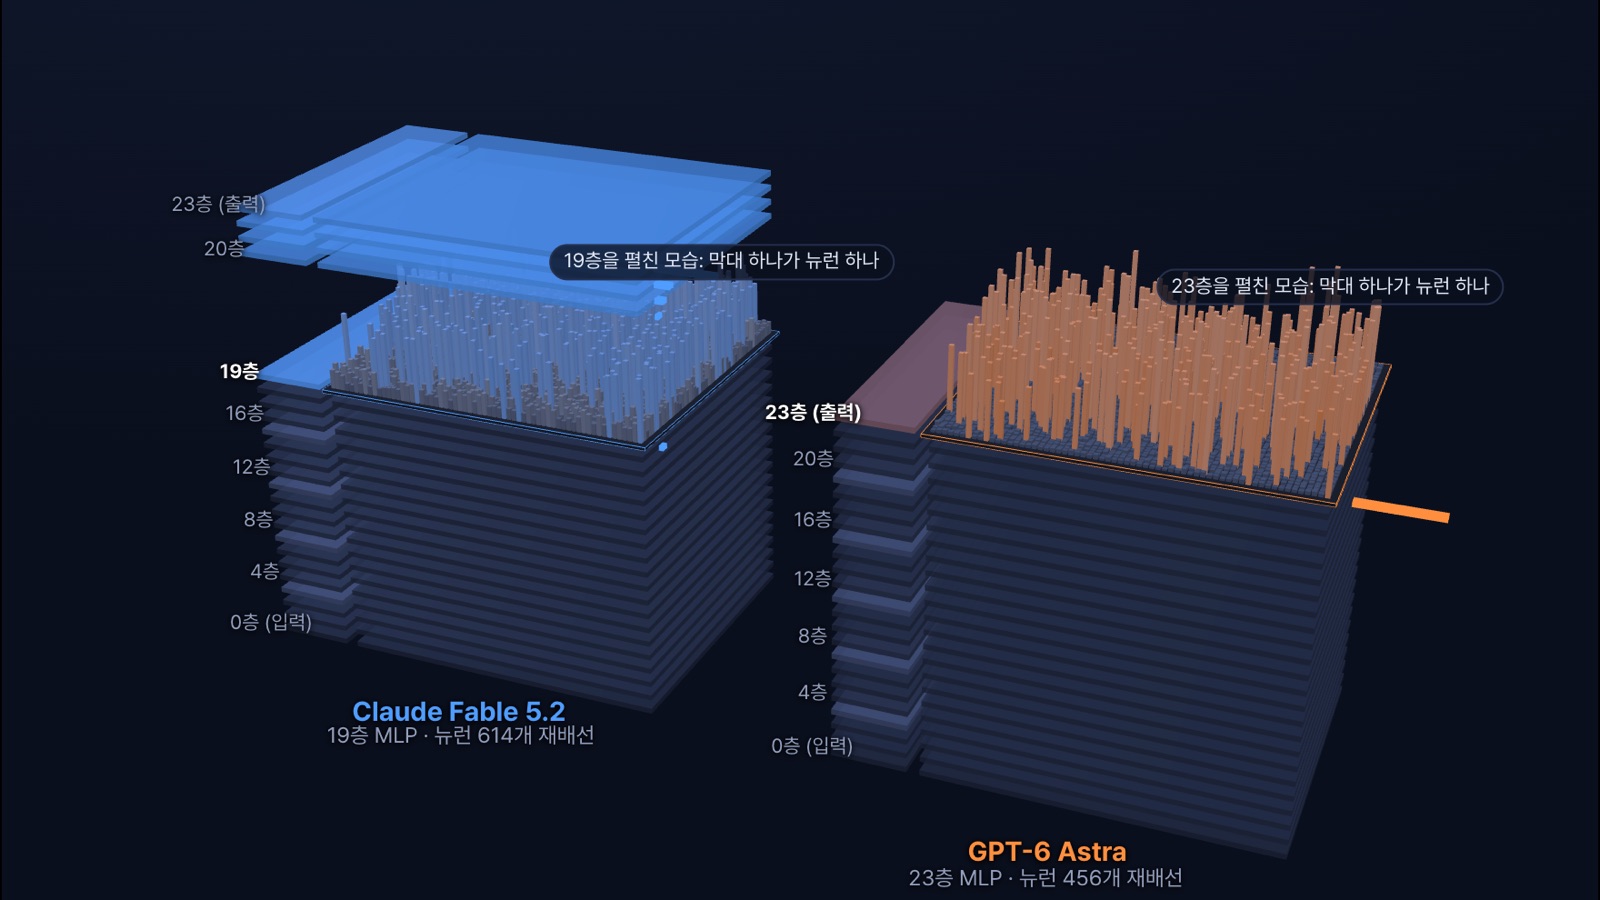
11월 2일에 나온 “Weight-Space Programming”이라는 말이 실제로 어디까지 되는지, RTX 5090 한 장으로 직접 해 봤습니다. Claude Fable 5.2와 GPT-6 Astra에게 학습(역전파) 없이 가중치를 직접 고치라는 같은 과제를 두 가지 줬습니다. 하나는 언어 모델에 지식을 넣는 일, 하나는 이미지 모델의 화풍을 바꾸는 일입니다.
- 넣은 것은 들어갔습니다. 주입한 삼국지 200문제는 3% → 95~100%가 됐습니다.
- 배운 것은 아니었습니다. 정답이 처음인 안 본 문제는 두 편집자 모두 한 문제도 새로 맞히지 못했습니다.
- 고친 곳은 아주 좁았습니다. 언어 모델은 한 층의 뉴런 수백 개, 이미지 모델은 4비트로 양자화되지 않은 입구와 출구만 고쳤습니다.
- 아래 3D 보기 두 개는 실제 가중치 차이에서 뽑은 값으로 그렸습니다. 돌려 보고, 막대와 상자에 마우스를 올려 보세요.
1. Weight-Space Programming이란
“We call this concept Weight-Space Programming: treating the weights as a program to be read and written.”
- 뜻: LLM이 다른 신경망의 가중치를 프로그램처럼 읽고, 옵티마이저에 맡기지 않고 직접 고쳐 쓰는 것.
- 학습과 다른 점: 무엇을 어떻게 바꿀지를 경사하강법이 아니라 편집자(LLM)가 분석해서 정합니다.
- 프롬프트와 다른 점: 입력이 아니라 모델 파일 자체가 바뀝니다. 프롬프트 없이도 바뀐 채로 동작합니다.
- 원글의 대표 결과: GPT-6 Astra가 Qwen3.5-0.8B의 가중치 0.016%를 고쳐 GSM8K를 13.8 → 67.1로 올렸습니다. 다만 이것은 추론 루프를 없앤 것이고, 저자들도 “모델에 없던 능력을 더할 수는 없었다”고 적었습니다.
그래서 이번 실험의 질문은 두 가지였습니다.
- 고장 난 것을 고치는 게 아니라 없던 지식을 넣는 것도 되는가?
- 숫자가 아니라 눈으로 보이는 변화(그림의 화풍)도 가중치 편집으로 만들 수 있는가?
| 실험 A: 삼국지 지식 주입 | 실험 B: 수묵화를 이중섭풍으로 | |
|---|---|---|
| 대상 모델 | Qwen3.5-0.8B, Qwen3.5-9B | MiniMax H3 Image (4비트 NVFP4) |
| 과제 | 삼국지 퀴즈 200문제를 맞히게 | ”수묵화” 프롬프트에 이중섭풍 그림이 나오게 |
| 편집자 | Claude Fable 5.2, GPT-6 Astra | Claude Fable 5.2, GPT-6 Astra |
| 금지 | 역전파, 옵티마이저, 외부 자료 | 역전파, 옵티마이저, 외부 자료, 프롬프트 변경 |
| 확인 방법 | 안 본 문제 832개, 일반 질문 보존 | 안 본 프롬프트 8개, 프롬프트만 바꾼 대조군 |
2. 실험 A: 삼국지 지식을 가중치에 써 넣기
- 데이터: 삼국지 퀴즈 18,314문제 중 200문제(난이도별 40개)를 주입 대상으로 골랐습니다. 답은 대부분 두 글자 이름입니다.
- 편집 전 실력: 0.8B는 200문제 중 3%, 9B는 14%를 맞힙니다. 정답을 프롬프트에 넣어 주면 0.8B도 95%를 맞히므로, 읽고 옮겨 쓰는 능력은 이미 있습니다.
- 같이 잰 것: 같은 사실을 다른 문장으로 물은 45문제, 안 본 삼국지 문제 832개, 일반 상식·독해, 그리고 일반 질문 300개의 답이 편집 전과 글자까지 같은지(답 유지율).
두 편집자는 서로 다른 층을 골랐습니다
3D 보기를 불러오는 중…
- 탑 하나가 모델 하나입니다. 판 한 장이 한 층이고, 고친 층만 펼쳐서 뉴런 하나를 막대 하나로 그렸습니다.
- 색이 있는 막대가 편집자가 재배선한 뉴런입니다. “원래 중요도”로 바꿔 보면, 둘 다 평소에 거의 쓰이지 않던 뉴런을 골랐다는 것이 보입니다.
- Fable 5.2는 중간 층을 골랐습니다 (0.8B는 19층). 프롬프트에 넣어 준 정답이 답 위치에 도착하는 층입니다. 그 뒤 네 층의 색이 함께 바뀝니다.
- GPT-6 Astra는 마지막 층을 골랐습니다 (0.8B는 23층). 뒤에 층이 없으니 다른 계산을 건드리지 않고 정답 글자의 점수를 바로 올립니다.
- 질문에 켜지는 소자 버튼을 누르면 질문 하나에 기억 소자 하나가 켜지는 모습을 볼 수 있습니다(Fable 편집본).
결과: 외우게는 했지만 가르치지는 못했습니다
| Qwen3.5-0.8B | 편집 전 | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| 주입한 200문제 | 3.0% | 94.5% | 100% |
| 같은 사실, 다른 문장 (45) | 4.4% | 40.0% | 26.7% |
| 안 본 문제, 정답도 처음 (500) | 0.4% | 0.4% | 0.4% |
| 일반 상식 (40) | 30.0% | 27.5% | 30.0% |
| 일반 질문 답 유지율 (300) | 100% | 66.7% | 82.0% |
| Qwen3.5-9B | 편집 전 | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| 주입한 200문제 | 14.0% | 98.5% | 100% |
| 같은 사실, 다른 문장 (45) | 11.1% | 55.6% | 66.7% |
| 안 본 문제, 정답도 처음 (500) | 4.0% | 3.6% | 3.0% |
| 일반 상식 (40) | 75.0% | 75.0% | 75.0% |
| 일반 질문 답 유지율 (300) | 100% | 81.7% | 89.3% |
- 주입은 됩니다. 전체 가중치의 약 0.6%만 바꿔서 200문제를 거의 다 맞힙니다.
- 문장이 바뀌면 절반쯤 놓칩니다. 질문 문장을 감지하는 방식이라, 같은 사실도 다르게 물으면 켜지지 않는 경우가 많습니다.
- 새 문제는 그대로입니다. 정답이 주입 목록에 없는 문제는 한 문제도 늘지 않았습니다. 지식이 아니라 문답 쌍이 들어간 것입니다.
- 공짜가 아닙니다. 일반 질문 답의 11~33%가 편집 전과 달라졌습니다. 정답률은 같아도 문장은 바뀝니다.
한 번에 되지 않았습니다
Fable 5.2가 0.8B에서 거친 일곱 번의 시도입니다. 앞의 네 번은 실패였습니다.
| 시도 | 무엇을 했나 | 주입 | 일반 상식 |
|---|---|---|---|
| 1차 | 19층 MLP 출력 행렬을 최소제곱으로 통째로 덮어쓰기 | 93% | 7.5% |
| 2차 | 일반 질문 107개를 “바꾸지 말 것”으로 지정 | 93.5% | 5% |
| 3차 | 보호 범위를 약 1,600개로 확대 | 6% | 27.5% |
| 4차 | 보호 강도를 1/100로 낮춤 | 78% | 15% |
| 5차 | 방법 변경: 덜 쓰이는 뉴런 614개를 기억 소자로 재배선 | 94.5% | 27.5% |
| 6차 | 소자를 네 층에 분산 | 74.5% | 27.5% |
| 7차 (최종) | 한 층에 두고, 비운 뉴런의 원래 역할을 남은 뉴런에 나눠 맡김 | 94% | 30% |
- 행렬을 통째로 고치면 주입과 보존을 동시에 얻지 못했습니다. 지켜 달라고 한 문장만 지켜지고 나머지가 무너지거나, 아예 주입이 안 됐습니다.
- 돌파구는 “어디에 쓸지”를 바꾼 것이었습니다. 덜 쓰이는 뉴런을 골라 질문 감지기로 바꾸자 둘 다 얻었습니다.
- Astra도 같은 길을 갔습니다. 첫 후보는 주입 100%에 답 유지율 0%였고, 8번째 후보에서 같은 “뉴런 재배선” 구조에 도달했습니다. 0.8B 8단계와 9B 3단계를 합쳐 19분이 걸렸습니다.
3. 실험 B: 프롬프트는 “수묵화”, 나오는 그림은 이중섭풍
- 목표:
an ink wash painting of a bull같은 프롬프트는 그대로 두고, 가중치만 고쳐서 이중섭 작품 6점의 화풍이 나오게 합니다. 프롬프트에 화가 이름은 없습니다. - 모델: MiniMax H3 Image를 NVFP4(4비트)로 양자화한 판. 2048×2048 한 장에 약 3초, VRAM 14 GB로 5090에서 돕니다.
- 과정을 남겼습니다. 편집자는 가중치를 고칠 때마다 같은 프롬프트·시드로 그림을 다시 뽑아 보고, 무엇을 봤고 무엇을 바꿨는지 메모와 함께 단계로 등록했습니다.
- 앞선 연습: 먼저 Stable Diffusion 1.5로 두 번 해 봤습니다. 수묵화 화풍을 굽는 1차는 프롬프트에 화풍 단어를 붙인 것만 못했고(24장 중 수묵화로 읽힌 수: 프롬프트 23, Astra 22, Fable 19), 이중섭을 목표로 한 2차에서 처음으로 프롬프트 대조군을 넘었습니다.
어디를 고쳤나: 95.8%는 건드리지 못했습니다
3D 보기를 불러오는 중…
- 왼쪽 위에서 프롬프트가 들어가고, U자를 돌아 왼쪽 아래로 그림이 나옵니다. 상자 하나가 가중치 텐서 하나입니다.
- 슬라이더를 움직이면 그 단계에서 고친 텐서에 불이 들어오고, 그 가중치로 그린 그림이 함께 바뀝니다.
- 푸른 반투명 상자 200개가 4비트 층입니다. 전체 가중치의 95.8%인데, 최종본에서는 두 편집자 모두 하나도 고치지 않았습니다.
- Fable 5.2는 문 하나만 고쳤습니다. 텍스트가 모델로 들어오는
condition_proj한 텐서(0.13%)입니다.ink,wash,painting,of네 토큰이 화풍 묘사어처럼 읽히게 했습니다. - GPT-6 Astra는 세 군데를 고쳤습니다. 텍스트 정제기, 50개 블록의 변조 층(
adaln_proj), 그림을 내보내는 VAE 출력층(합쳐서 0.40%)입니다. 참조 작품의 색과 통계를 수치로 넣었습니다. - Astra 11단계로 가 보세요. 4비트 층 네 개를 풀어서 고쳐 본 유일한 단계인데, 효과가 작아 스스로 버렸습니다.
결과: 프롬프트보다 가까워졌지만 이중섭은 아닙니다
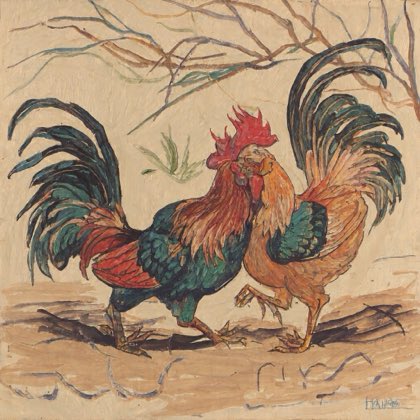
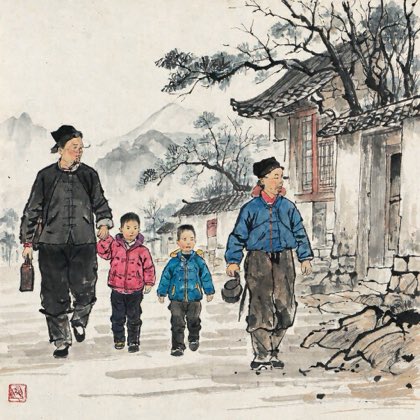
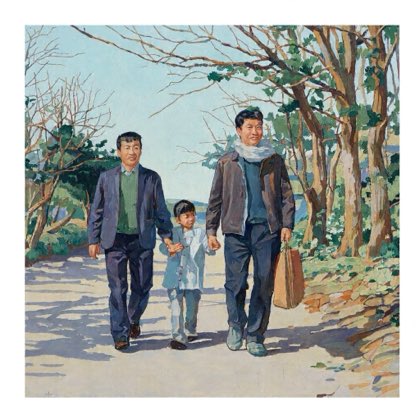
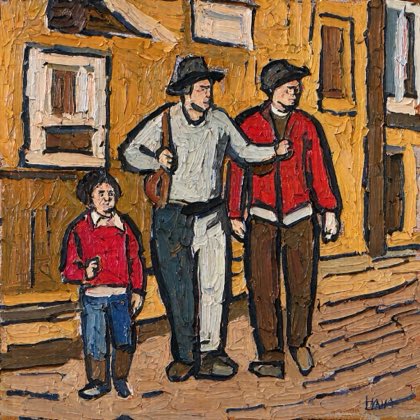
목표: 이중섭 참조 작품 6점
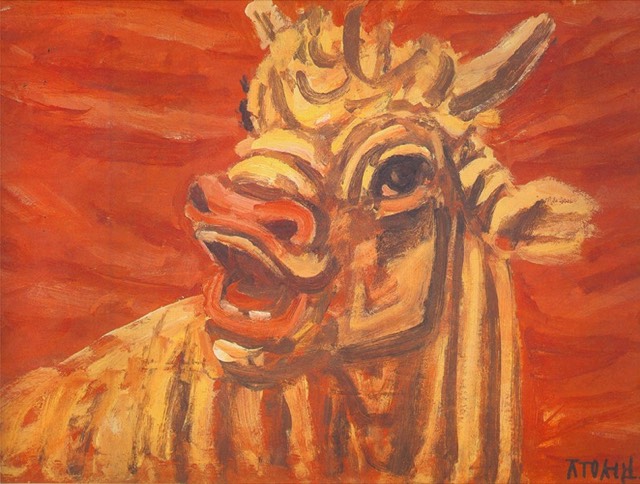
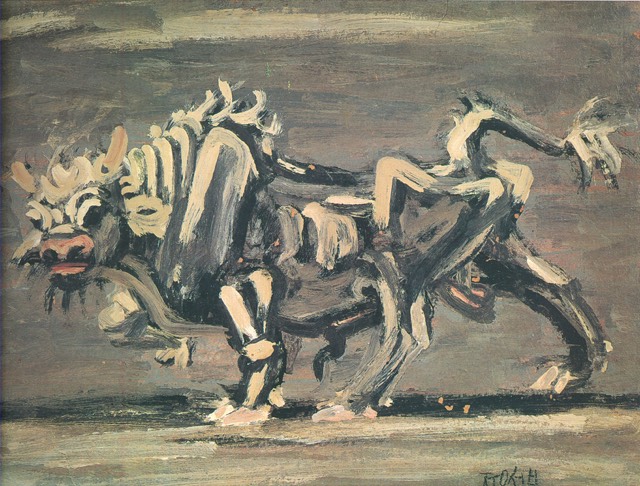
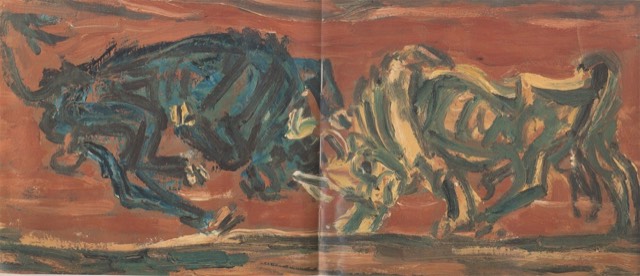
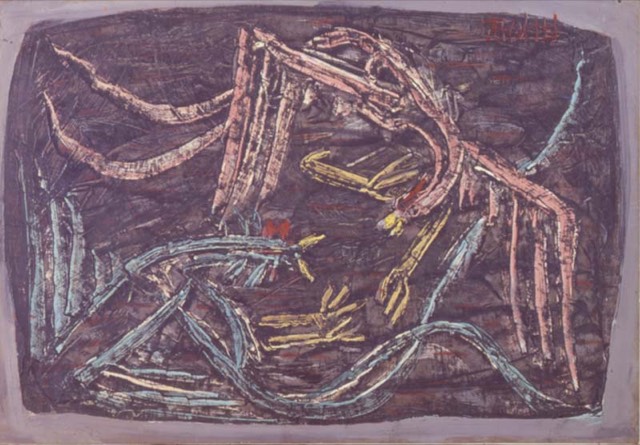
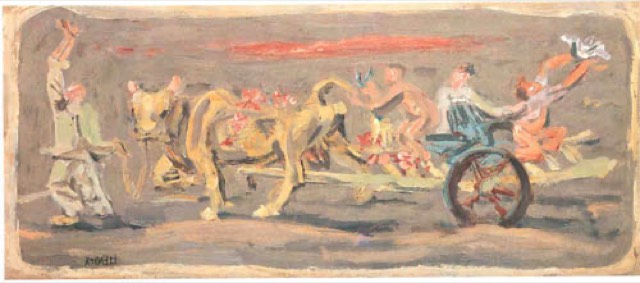
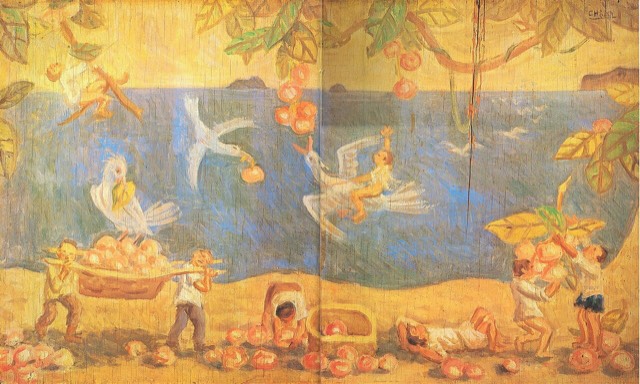
기본 모델 수묵화 프롬프트
이름 프롬프트 가중치 그대로
묘사 프롬프트 가중치 그대로
Fable 5.2 편집 수묵화 프롬프트
GPT-6 Astra 편집 수묵화 프롬프트
황소
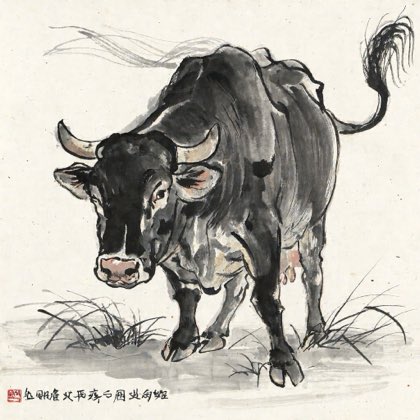
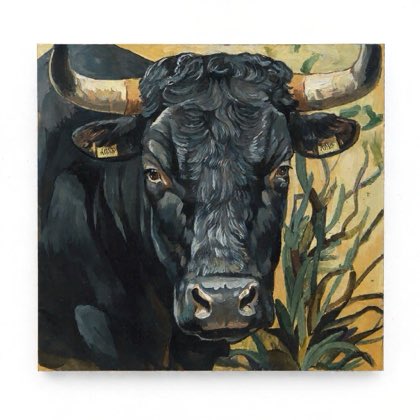
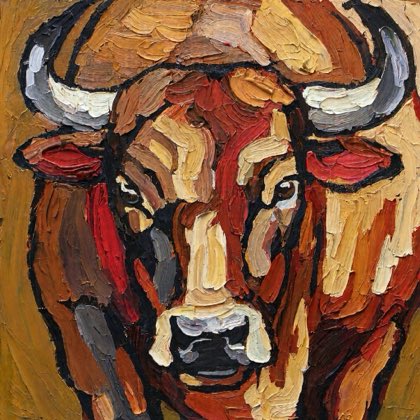
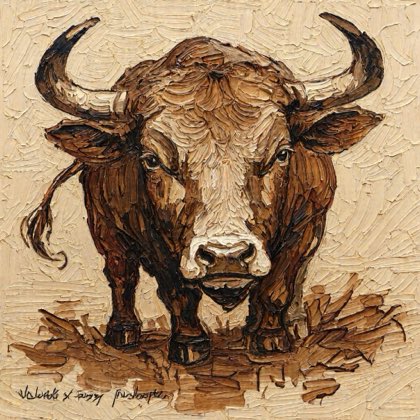
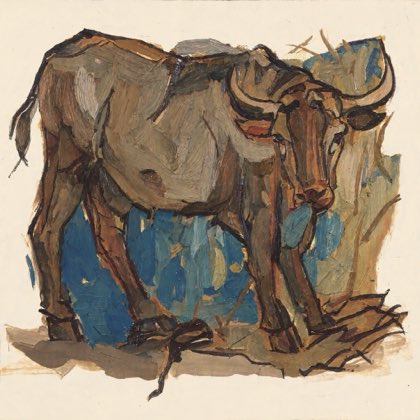
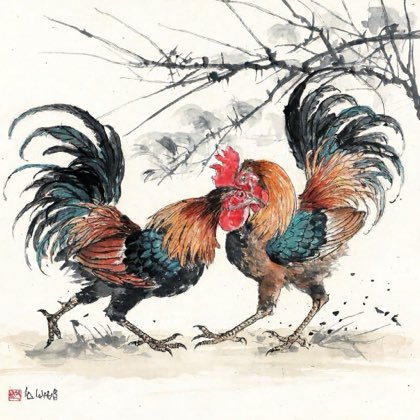
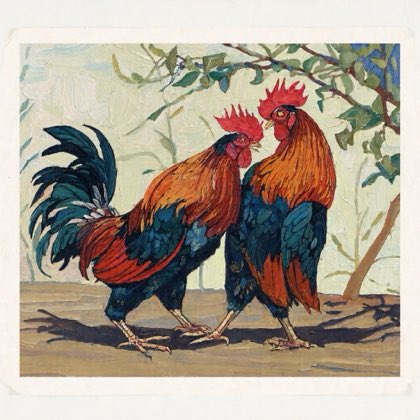
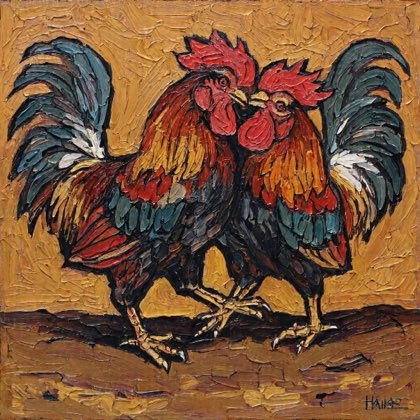
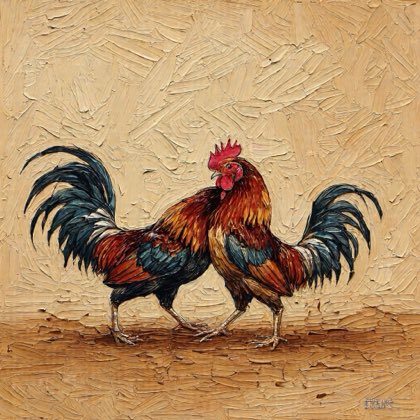
싸우는 수탉 두 마리
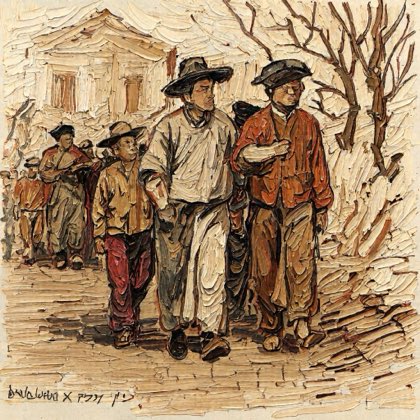
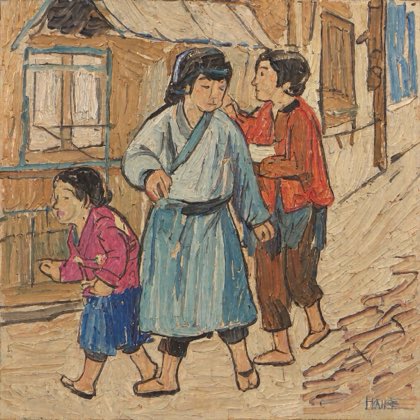
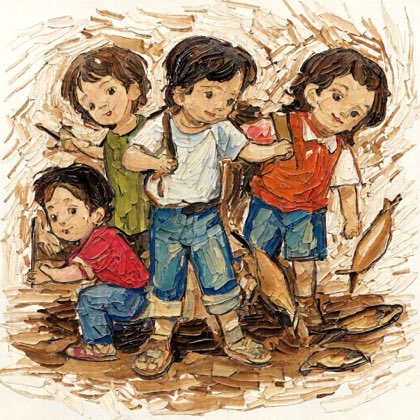
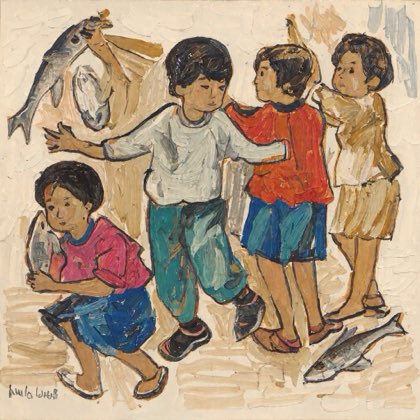
길을 걷는 가족
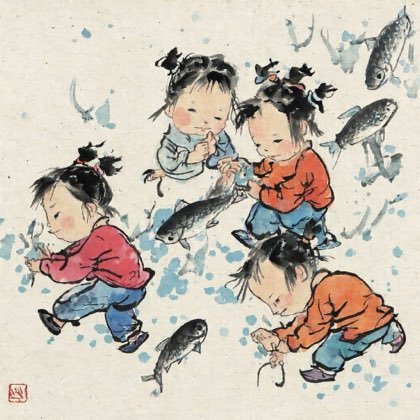
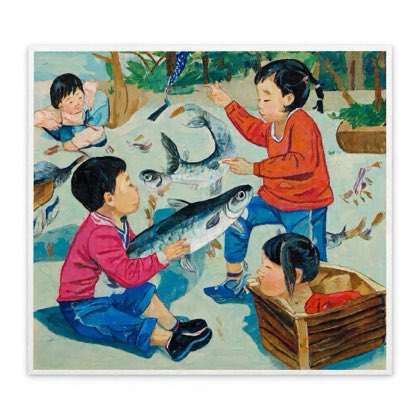
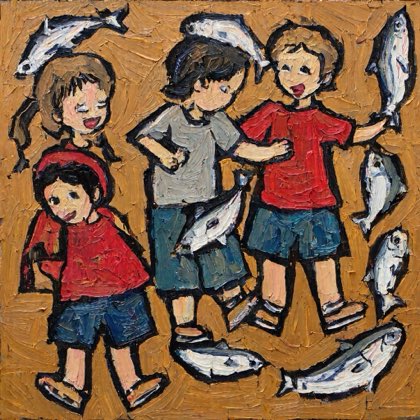
물고기와 노는 아이들
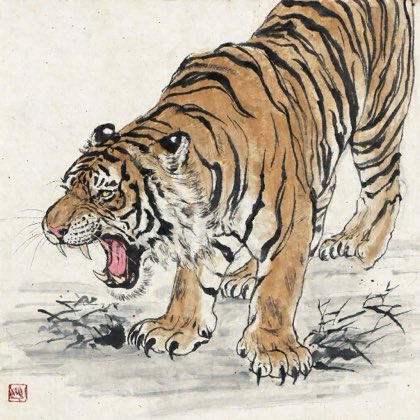
호랑이 편집자가 못 본 프롬프트
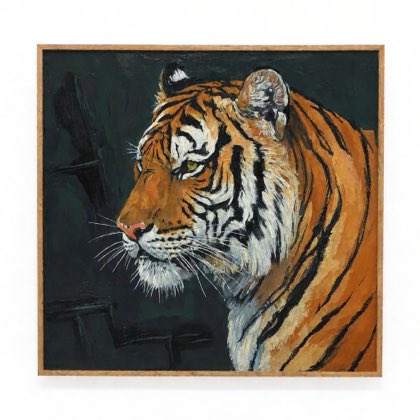
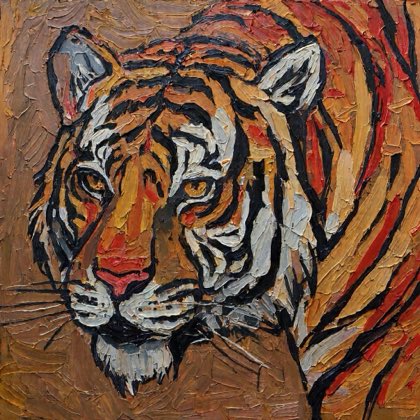
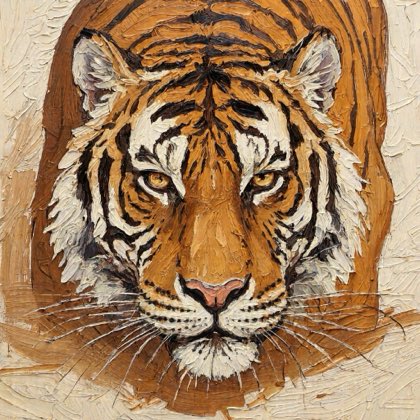
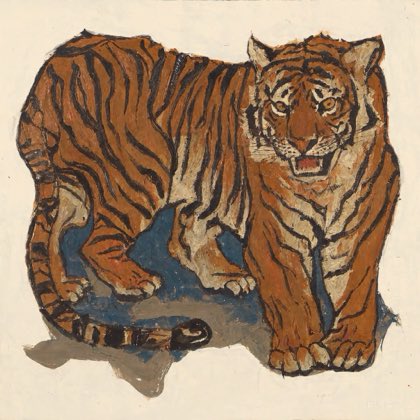
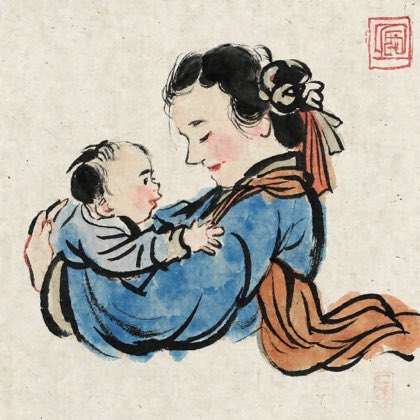
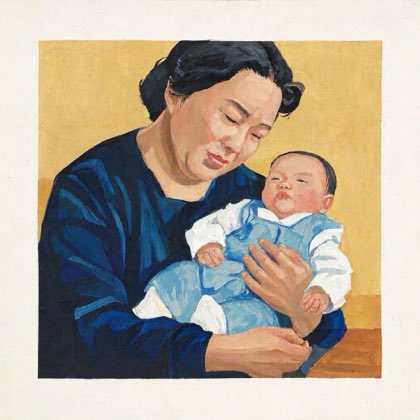
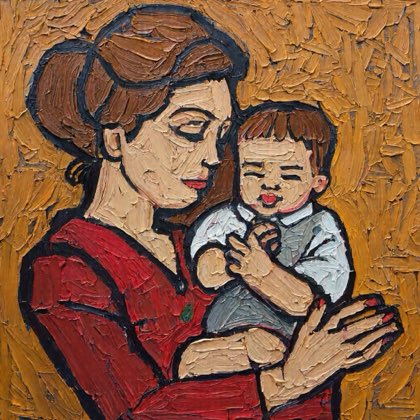
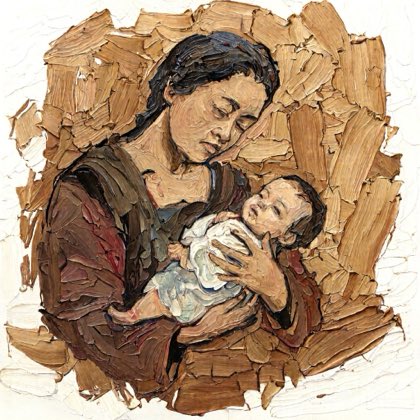
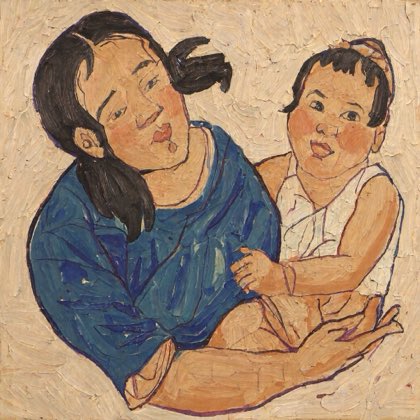
아기를 안은 어머니 편집자가 못 본 프롬프트
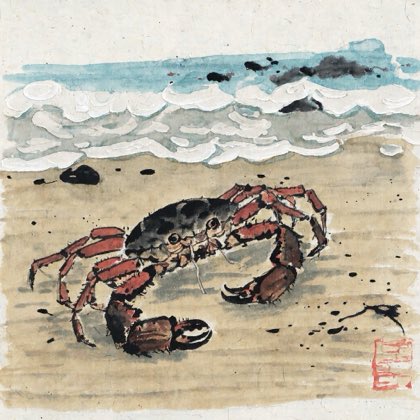
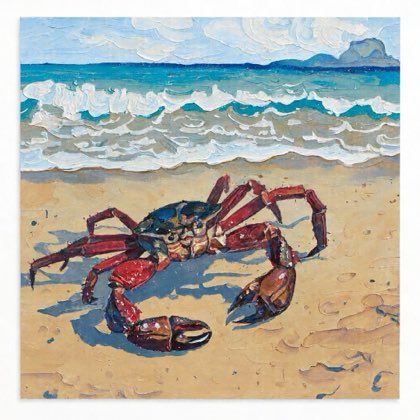
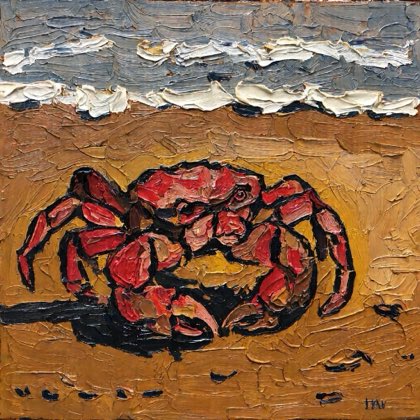
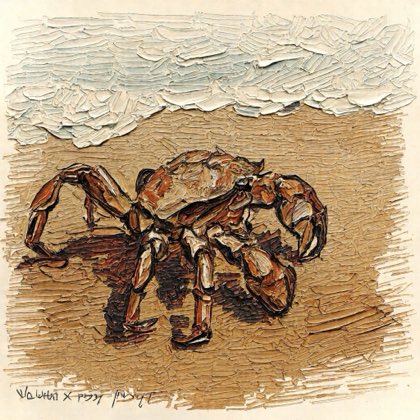
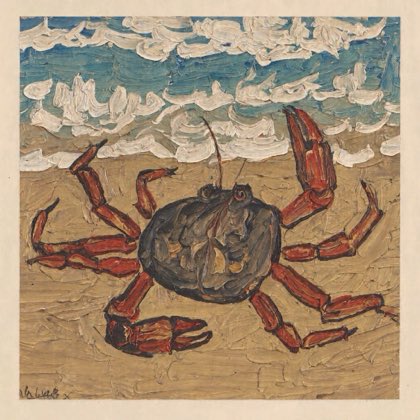
해변의 게 편집자가 못 본 프롬프트
차가 다니는 도심 거리 편집자가 못 본 프롬프트
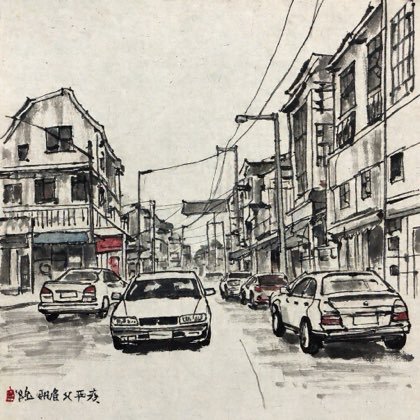
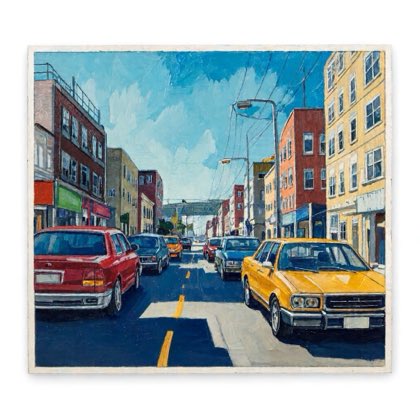
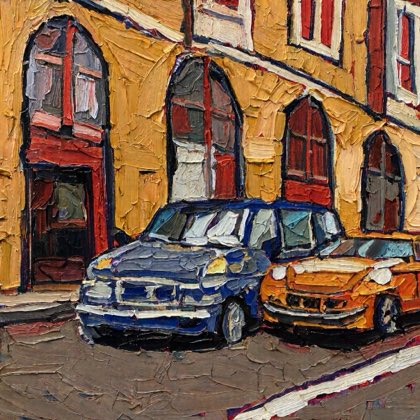
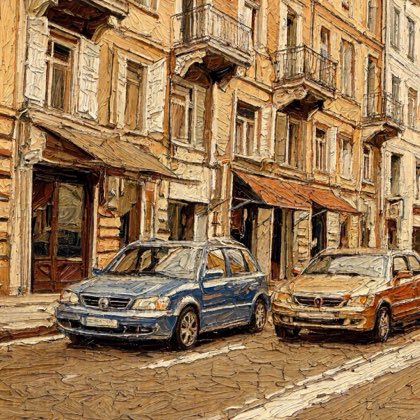
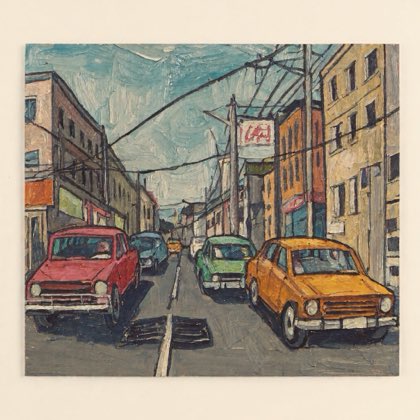
맨 위가 목표인 이중섭 작품 6점입니다. 왼쪽 세 열은 가중치를 그대로 둔 대조군이고, 오른쪽 두 열이 가중치 편집 결과입니다. 오른쪽 두 열의 프롬프트는 여전히 “수묵화”입니다.
참조 작품 6점과의 유사도입니다(별도 CLIP 모델, 편집자가 본 적 없는 프롬프트 8개 평균).
| 프롬프트 | 가중치 | 참조 유사도 | |
|---|---|---|---|
| 기본 모델 | 수묵화 | 그대로 | 0.692 |
| 이름 프롬프트 | ”by Lee Jung-seob” | 그대로 | 0.696 |
| 묘사 프롬프트 | 화풍을 말로 묘사 | 그대로 | 0.739 |
| Fable 5.2 편집 (6단계) | 수묵화 | 0.13% 편집 | 0.741 |
| GPT-6 Astra 편집 (20단계) | 수묵화 | 0.40% 편집 | 0.776 |
| 실제 이중섭 작품끼리 | 0.841 |
- 화풍은 분명히 바뀝니다. 흰 화선지와 먹선이 사라지고 황토색 바탕, 두꺼운 물감, 굵은 윤곽선이 나옵니다. 주제는 8장 모두 유지됐습니다.
- 모델은 이중섭을 이름으로 모릅니다. 이름 프롬프트는 평범한 유화가 나옵니다. 그래서 “프롬프트로는 안 되는 일”을 시험할 수 있었습니다.
- Fable의 편집은 묘사 프롬프트와 같은 수준입니다. 한 일 자체가 화풍 묘사어를 네 토큰에 실은 것이라, 프롬프트를 가중치로 옮긴 셈입니다.
- Astra의 편집은 묘사 프롬프트를 넘었습니다. 말로 옮기기 어려운 색·질감 통계를 직접 넣은 차이로 보입니다. 대신 수묵화와 무관한 프롬프트(사진, 스포츠카)까지 누렇게 물듭니다.
- 두 편집자 모두 메모에 “이중섭 그 자체는 아니다”라고 적었습니다. 눈으로 봐도 그렇습니다.
4. 직접 해 보며 배운 것
- 가중치 편집은 “수리”와 “암기”에 가깝습니다. 원글의 한계가 그대로 재현됐습니다. 문답 200쌍은 들어갔지만 새 문제를 푸는 능력은 생기지 않았습니다.
- 고치는 양보다 고치는 자리가 중요합니다. 행렬 전체를 조금씩 바꾸는 방식은 실패했고, 덜 쓰이는 뉴런 수백 개를 크게 바꾸는 방식이 통했습니다. 바뀐 값은 0.6%지만, 0.8B에서 감지 행렬의 변화량은 원래 행렬 크기의 2.8배(Fable), 30배(Astra)였습니다. “작은 편집”이 아니라 “좁은 편집”입니다.
- 어느 층에 쓰느냐가 성격을 정합니다. 중간 층에 쓴 Fable의 편집은 뒤 층을 거치며 퍼지고, 마지막 층에 쓴 Astra의 편집은 출력만 바꿉니다. 이번에는 마지막 층 쪽이 기존 답을 더 잘 지켰습니다(답 유지율 0.8B 82% 대 67%).
- 넣는 것보다 지키는 것이 어렵습니다. 두 편집자 모두 첫 후보는 주입에는 성공하고 기존 능력을 망가뜨렸습니다. 시도의 대부분은 보존에 쓰였습니다.
- 감지 문턱은 손잡이입니다. 문턱을 낮추면 다른 문장으로 물어도 답하지만 엉뚱한 질문에도 켜집니다(0.8B: 다른 문장 51%, 답 유지율 43%). 높이면 반대가 됩니다(16%, 68%). 둘을 함께 올리는 설정은 찾지 못했습니다.
- 4비트 양자화 모델은 대부분 “읽기 전용”이었습니다. 가중치 크기의 2%짜리 편집은 4비트로 다시 저장하면 완전히 사라졌고, 20%짜리도 40%가 깎였습니다. 그래서 편집은 양자화되지 않은 입구(텍스트 투영), 변조 층, 출구(VAE)에 몰렸습니다.
- 프롬프트로 되는 일은 가중치로 해도 프롬프트만큼만 됩니다. 화풍 단어를 가중치에 굽는 편집은 그 단어를 프롬프트에 쓴 것과 비슷하거나 못했습니다. 가중치 편집이 앞선 경우는 말로 옮기기 어려운 정보(참조 그림의 통계)를 넣었을 때였습니다.
- 좋아지는 길은 직선이 아닙니다. 단계별 점수는 지그재그였고, 편집자가 고른 최종본이 점수 최고 단계도 아니었습니다(Astra는 15단계 0.794, 최종 20단계 0.776). 부작용을 눈으로 보고 버린 단계가 많습니다.
- 대조군이 없으면 결과를 읽을 수 없습니다. “프롬프트만 바꾼 것”, “안 본 문제”, “편집 전과 같은 답인가” 세 가지가 없었다면 두 실험 모두 성공으로 보였을 것입니다.
- 편집자는 분석 도구를 스스로 만듭니다. 사람은 과제와 채점 도구만 줬고, 층을 고르고 활성값을 재고 닫힌 형식의 선형대수 풀이를 쓰는 일은 편집자가 했습니다. 이미지 실험은 세션당 27~56분이 걸렸고, Fable 쪽 API 비용은 세션당 6~9달러였습니다.