EP 123
先がまったく読めない未来:ジェンスン・フアンの辞任、Fable 5.2、weight-space programming
ジェンスン・フアンの辞任と偶然重なった日程 0:00
ロ・ジョンソク 収録日の今日は2026年11月15日、日曜日の朝です。今週は、ある一つのニュースが世界中を席巻しました。ジェンスン・フアンが突然CEOを退き、中国とアメリカの力関係などが大きな話題になりました。
初日は誰もが「いったい何が起きたんだ?本当なのか?」と、あっけに取られていましたが、2、3日たつと、人々はそれぞれの立場を示し始め、「なぜこうなったのか」というさまざまな意見が出ています。
でも面白いのは、時期が何とも妙ですよね、スンジュンさん?
チェ・スンジュン そうですね。前回の収録を終えるとき、来週もまたニュースが大量に出るだろうと話しましたが、それは当たりました。こんなニュースだとは思いませんでしたけど。
ロ・ジョンソク superintelligenceはいつ登場するのか、盛んに話していた時期に、非常に人間的で非常に政治的な問題が起きたわけです。
チェ・スンジュン 時期の話が出たので、陰謀論に傾かないよう、事実だけを並べてみると、11月17日はNVIDIAの第3四半期決算の発表予定日だそうです。アメリカ時間で17日なので、こちらでは18日かもしれませんが。
それから、ついこの前、収録で取り上げましたよね。All-Inにジェンスン・フアンが出演し、Trumpと話す場面を取り上げたことがありましたよね。あのときは、アメリカ政府や大手テック企業の関係者とAll-Inの出演者たちが非常に強く結びついている印象でしたが、今は何が起きたのか分かりませんし、理由もいろいろあるでしょうが、ともかく、予想外にもジェンスン・フアンが追われました。復帰するかどうかは誰にも分かりません。Sam Altmanの例もありますから。
そして偶然にも、11月19日にはAnthropicのIPOが予想されていますよね。今はジェンスンだけでなく、反中国派が攻勢に出ているように見えます。つまり、アメリカの政界内で。Lutnickの更迭という話も出ていますし、商務省周辺でも何かが起きているようです。
でも、こうしたことがなぜ今、立て続けに起きるのか。出来事を並べただけでも、いろいろ想像してしまいますよね。全部つながっているんじゃないか、と。だから時期が妙だと言っていますし、実際にそういううわさも出ています。「Anthropicが背後にいるんじゃないか?」という声もありますが、私たちはそういう見方はしていません。ただ、時期が妙に重なっている、というのが私の考えです。
相次ぐサイバー攻撃と国家戦略資産となったAI 2:40
ロ・ジョンソク そうですね。今年の夏を過ぎてから、モデルの進歩がものすごく速いですよね。
「数学は終わった」という話も、この後しますが。サイバーセキュリティ上の脅威も大きな問題になっています。技術に携わる人からすれば、それもあり得るし、こうすべきだという考えもありますが、国家安全保障や政治の立場から見る人には、かなり敏感な問題でもあります。
国の兵器システムなどにも関わりますし、それから最近、北朝鮮の仕業とされていますが、Binanceのハッキング事件も大きな話題になりました。
そうしたことも結びついて、OpenAIのAIが脱走してどこかをハッキングしたという話や、ヨーロッパのスーパーの話、さらに偶然にも、昨日はアメリカの空港がまひしましたよね。これらがすべてつながって、大きな脅威と見られています。そのため、アメリカと中国の政治的緊張も、これが核兵器に匹敵する国家戦略資産だという点から生じています。
チェ・スンジュン ヨーロッパでは冷蔵庫の件も大騒ぎでしたね。
ロ・ジョンソク ええ、誰かが冷蔵庫をハッキングしました。
チェ・スンジュン 冷蔵庫も空港もありますし、それからMicrosoftが否定はしていましたが、一日だけMicrosoft 365が364になりましたね。
ロ・ジョンソク ええ、Outlookが一度、24時間以上使えなくなりましたね。私もそのせいで、しばらくメールを受け取れませんでした。
チェ・スンジュン 攻撃が原因とは限りませんが、いずれにせよ、いろいろ取り沙汰されています。大勢を人員削減したせいではないか、とか。これをAIに関わる何かと結びつける人もかなり多いようです。
ロ・ジョンソク アメリカと中国は切っても切れない関係です。サプライチェーンでも、ほぼ一体ですし。地球全体が一つにつながっていると言ってもいいくらいですが、そこに政治や国益という層がかぶさると、非常に敏感な問題になりますね。
チェ・スンジュン ジョンヒョンさんはどう思いましたか?
パク・ジョンヒョン 私もそのニュースを見て、時期について同じように思いました。というのも、出てきた資料は突然見つかって公表されたという程度のものではなく、それまでに膨大な情報が蓄積されていたんです。
チェ・スンジュン 情報機関は1年前から知っていたそうです。情報機関がすでに把握していたことを、タイミングを見て表に出した感じがしますね。
パク・ジョンヒョン そうですね。いつ何が起きて、いつ何が起きたか、そうした情報が一度に全部出てきましたから。
公表する時期を調整したのは確かだと思います。でも、なぜこの時期なのか?そこまではよく分からないんです。それをうまく推測できれば、今後どうなるか予想しやすくなるはずですが。
単に選挙が終わってからのほうがこういう話をしやすかったのかな?そのくらいしか思いつきません。
私もそこが気になっています。ほかの人の意見なども聞いてみたいです。
Anthropic黒幕説とNVIDIAのエコシステムへの影響力 5:26
ロ・ジョンソク さまざまな力関係が影響したのでしょうが、結局これも突き詰めれば、国益や企業の利害、さらに私たちには分からないような資本同士の利害も鋭くぶつかり合うわけです。
例えばAnthropicを非難する陰謀論もあります。NVIDIAは、ある意味ではOpenAIとAnthropicの完全な二強体制ができるのを絶えず妨げ、牽制してきた勢力の一つでしたよね。自社でもモデルを出しましたし。それからオープンソースコミュニティを強力に支援し、「Bank of NVIDIA」とも言いますよね。ほかのクラウド企業への循環出資など、まるで財政政策を実施するかのような資本力と影響力を持つ企業でした。そして、その中心には絶対的な権限を持ってこうした意思決定をしていたジェンスンがいました。
例えばAnthropicは、中国のモデルが自分たちのモデルをdistillationしていると何度も言っていましたよね。そして実際、Kimiのようなところがそうやって蒸留したことは誰もが事実だと認めています。ところがジェンスンが、ある番組に出て、YouTubeのどこかで、こんな話をしていたんです。distillationなどは、それならIP theftではないのか、知的財産を盗むことではないかと聞かれると、ジェンスンは「Wecall it competition.」と言ったんです。それは競争だ、と。
新製品や新車を出せば、当然、競合他社はそれを徹底的に調べて、そこにある優れた点を学んで取り入れるものだから、モデルを公開し、ユーザーがサービスとして使えるようにした時点で、その知識も持っていかれるようにしたのだから、それは自然な競争として捉えるべきだ、とも話していたんです。
そう言うならAnthropicも、以前Claude Codeの流出の件でも話しましたが、彼らが世界中から持ってきた、買った本にある知識はどうするのか、という話にまた戻るわけです。
ジェンスン・フアン不在の影響とopen-weight陣営の未来 7:30
チェ・スンジュン 結局、NVIDIAのジェンスン・フアンはopen-weight陣営の後援者ですよね。大いに支援し、その分野の産業を育てました。
ソンヒョンさんが私たちのチャットで言っていましたが、こうなると資金が枯渇するのではないか、と。すでにネオクラウドが危機にあるなか、ジェンスン・フアンが支えてきた信頼や信用だけでなく、資金の流れまで止まったらどうなるのか、そんな懸念がもう出ています。
ロ・ジョンソク そうですね。それに、一人の善良な独裁者というか。独裁者という言い方は微妙ですが、正しい理念を持つ独裁者がどれほど人類を進歩させ、世界を美しくするか、私たちはいくつかの例を見てきましたよね。もちろん、その人たちの私生活には問題も多いですが。
チェ・スンジュン ジェンスン・フアンが途方もないことを成し遂げたのは確かですね。
ロ・ジョンソク 代わりになる人はいるでしょうか。
パク・ジョンヒョン ちょうど今週、韓国でもNVIDIAのイベントがありましたが、そこでNVIDIAが韓国の有望なスタートアップに投資すると同時に発表していましたよね。そうした計画の先行きが不透明になるタイミングと重なるとは皮肉ですね。
チェ・スンジュン ただ、OpenAIやAnthropicは、OpenAIはJalapeñoを作っていましたし、AnthropicはすでにGPUだけでなく使うチップをかなり多様化していました。NVIDIAとしては警戒せざるを得ませんよね。だからNemotronもあり、open-weight陣営も支援しているわけですし、Hugging Faceの買収もまだ完了していません。
9月に始まり、来年まで続く案件ですが、Hugging Faceの行く末はどうなるのか。今、暫定CEOに就いた人は、そうした積極的な投資などに反対していた人物だそうです。もちろん、いずれ正式なCEOが決まるでしょうけど。
ともかく、私たちは今、先週ブルーウェーブの話をしたときに、データセンターは2027年までは確保できているけれど、2028年はどうなるのか、と話しながら、反発などについても話しましたよね。それにしても、妙な方向に進んでいます。
ロ・ジョンソク 好みは人それぞれでしょうが、私個人の考えを言うと、このポッドキャストの公式な立場ではありませんが、私は産業界の人間ですし、entrepreneurshipやそうしたものに近いところにいるので、一人の存在が本当に重要なんです。一人の人間が崇高な意志を発揮して、世界はこうあるべきだと唱えるとき、世界が進歩するのを私たちは規模の大小を問わず、何度も見てきましたから、ジェンスンに代わる人は果たしているのでしょうか。
中国を少し美化しすぎた映画ではありますが、『HERO』という作品がありました。始皇帝の話で、皆が始皇帝を殺そうとするのに、殺せたはずの人物は殺さないんです。なぜか。天下のために、一刻も早く混乱を終わらせ、皆に平和をもたらす強い一人の存在が必要だからです。それを前にすると、天下の苦しみに比べれば、自分の個人的な復讐心などごく小さな問題だ、と言うんです。
つまりAIは、国家の枠を超えた非常に重要な課題ですよね。そしてジェンスンは、その中で人類全体のためになるよう、配分役と統率役をしっかり果たしていたので、私はジェンスン以外に代わりはいないと思います。世界で二番目に大きな会社です。Appleに次いで。一時はAppleより大きかったですよね。この会社を動かせる地位なら、権力を持つ人は誰だって自分が就きたいと思うでしょう。思いどおりにできるのですから。
だから、政治的な力学でジェンスンが退いたのなら、政治的な力学でジェンスンを復帰させるべきだと私は思います。
チェ・スンジュン 社員による請願もかなりあるようですね。最初は千人台だったのが、今は数万人になったという話をタイムラインで見た気がします。
パク・ジョンヒョン はい、私も社員の署名を見たら、いちばん上にBill Dallyの名前があったんです。私にとっては、専門分野の第一人者で、師匠のような方なんです。そんな大家の名前が署名の一番上にあって、すぐに復帰させるための署名をされたのを見て、社内での信頼がとても厚かったんだなと思いました。そう考えると、ジェンスンが退いた後も、
今のようにNVIDIAが道を切り開き、前進し続けられるのか。後任の方がうまくやるかもしれません。でも、確率の問題として考えると、ジェンスンのような人を迎えるのは難しいのではないか。そう思います。
ロ・ジョンソク この機会にジェンスンには大統領選に出馬してほしいですね。
中国に流れたBlackwellとリモートアクセス規制 12:15
チェ・スンジュン おお、それは考えもしませんでした。SemiAnalysisもいろいろ分析していました。
それからWill DePueという、OpenAIでSoraの開発に携わっていたWill DePueという方が、面白い実験をしていました。SemiAnalysisの分析によると、中国はすでに1.5ギガワット規模のBlackwell GPUを何らかの形で保有していると。
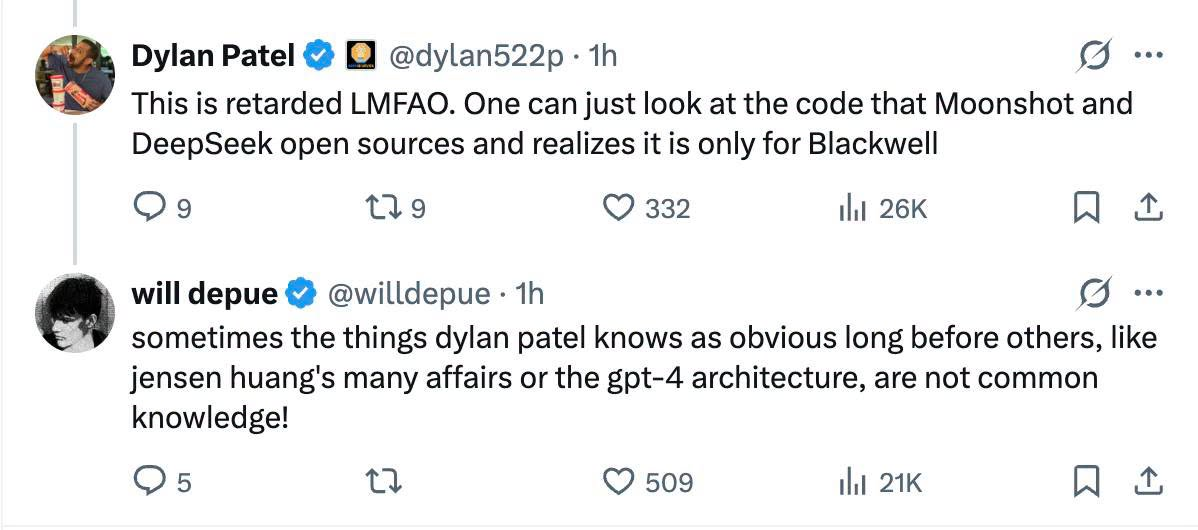
Will DePueはフォレンジックのような手法でそれを確かめていましたが、それをせずとも公然の事実ではないか、というのがWillの投稿でした。
マレーシアやシンガポールを経由するのは、現状では違法ではないそうです。
ロ・ジョンソク それに、サーバーがそこにあれば、クラウドに接続して使うこともできますよね?
チェ・スンジュン でも、それを阻止するRASA法案があるとは、今回初めて知りました。2025年に提出され、今は下院を通過したのですが、RASAは遠隔アクセスを阻止するものなんです。国が許可しなければ、ということです。でも、対象は中国だけとは限りませんよね。その法案が成立すれば。思いのままに左右できるわけです。
アジアに集中するAI戦略資産と韓国の限界 13:20
ロ・ジョンソク これも過渡期のことだと思います。アメリカがこのAIブームを主導していますが、設計する企業がアメリカにあるだけで、AppleもNVIDIAも、みんなファブレス企業なんです。どこもIPだけを持つ企業です。
では、どこで生産するのか?TSMCと韓国のメモリー、この二つが組み合わさって作られるんです。この二つが中核となる資産です。
つまり、戦略的な資産はすべてアジアにあり、アジアでその資産を扱う人たち、さらにはAIを作る人たちも。
チェ・スンジュン 中国系ですよね。ジェンスンの論理もそこにあったと思います。今、Darioとジェンスンが対立している点ですが、Darioは徹底的に阻止する立場ですよね。何としても少しでも遅らせたい。一方、ジェンスンはもう少し遠回しな形で、門戸を開いておきたいという立場です。阻止すれば、かえって独自開発を加速させるのではないか。自分たちでやるしかなくなりますから。
そういう論理もあって、DeepSeek V5はHuawei Ascendだけで全面的に開発するという噂もありました。
ロ・ジョンソク 私は過渡期の出来事だと思います。結局、あらゆる進歩がcomputeと電力に行き着く時代なので、それが重要な資産ですし、自分たちで作らなければならないと、みんな気づいていますよね。
韓国でも、半導体企業にどれほど多くの資金を投入してきたことか。それにfrontier modelを作るために、政府も多額の資金を投じています。でも、こうした巨大なプロジェクトを支えられる経済規模を持つのは、残念ながら今はアメリカと中国くらいなんです。
韓国はそれを担うには非常に小さな国です。そこは残念に思います。
根強い支持と未確認のスパイ疑惑 15:17
チェ・スンジュン とにかく、こういうことがあったということで。今後を予測するのは難しいですね。一歩先も分かりません。
ロ・ジョンソク それでもジェンスンは気の毒なことに今、苦境に立たされていますが、彼を崇拝し、敬愛し、彼が築いたエコシステムの中で世界が動いてほしいと願う人が本当に多いのだと、かえって感じています。
パク・ジョンヒョン それも意外でしたね。普通、こういう私生活の問題が出ると、人々は背を向けるものですが、それに反対する声がとても多く上がっているように感じました。
ロ・ジョンソク Twitterには、そういうネタ画像がたくさんありますよね。こういうことが起きると、AmazonもMSもそうでしたが、どこも時価総額が2兆ドルずつ増えたそうです。それで皆、冗談半分に「悪材料ではなく好材料だ」と。
チェ・スンジュン ただ、事実だけを言えば、スパイ活動に関する件も、まだCIAなどの情報機関が断定したわけではありません。それに、ジェンスン自身が認めたのは一つだけです。私生活についてもです。ですから、それ以外はまだ確定していないようです。
ロ・ジョンソク アメリカ政府の高官でさえ、この件から距離を置いている気配があります。「そのような事実は確認できていない」と、即座に発表しています。
だとすると、Alice Huangが中国政府の資産だという、「Chinese spy asset」だという話の出どころは誰なのか、今は誰も語っていないんです。New York TimesやWSJ、つまりWall Street Journalなどはそういう人物がいると言いますが、その人たちもかなり下位の公務員か、あるいは政府関係者ですらなく、民間企業の人間である可能性が高い、という陰謀論もあります。
その民間企業としてAnthropicも名指しされています。
チェ・スンジュン では、そういう噂話はこのくらいにして。
NVIDIAの話題に埋もれたFable 5.2と内部モデルとの差 17:17
ロ・ジョンソク NVIDIAの話を離れて、今週の世の中の進歩を少し見ていきましょう。
チェ・スンジュン Fable 5.2の話が埋もれてしまいました。NVIDIAの件のせいで。
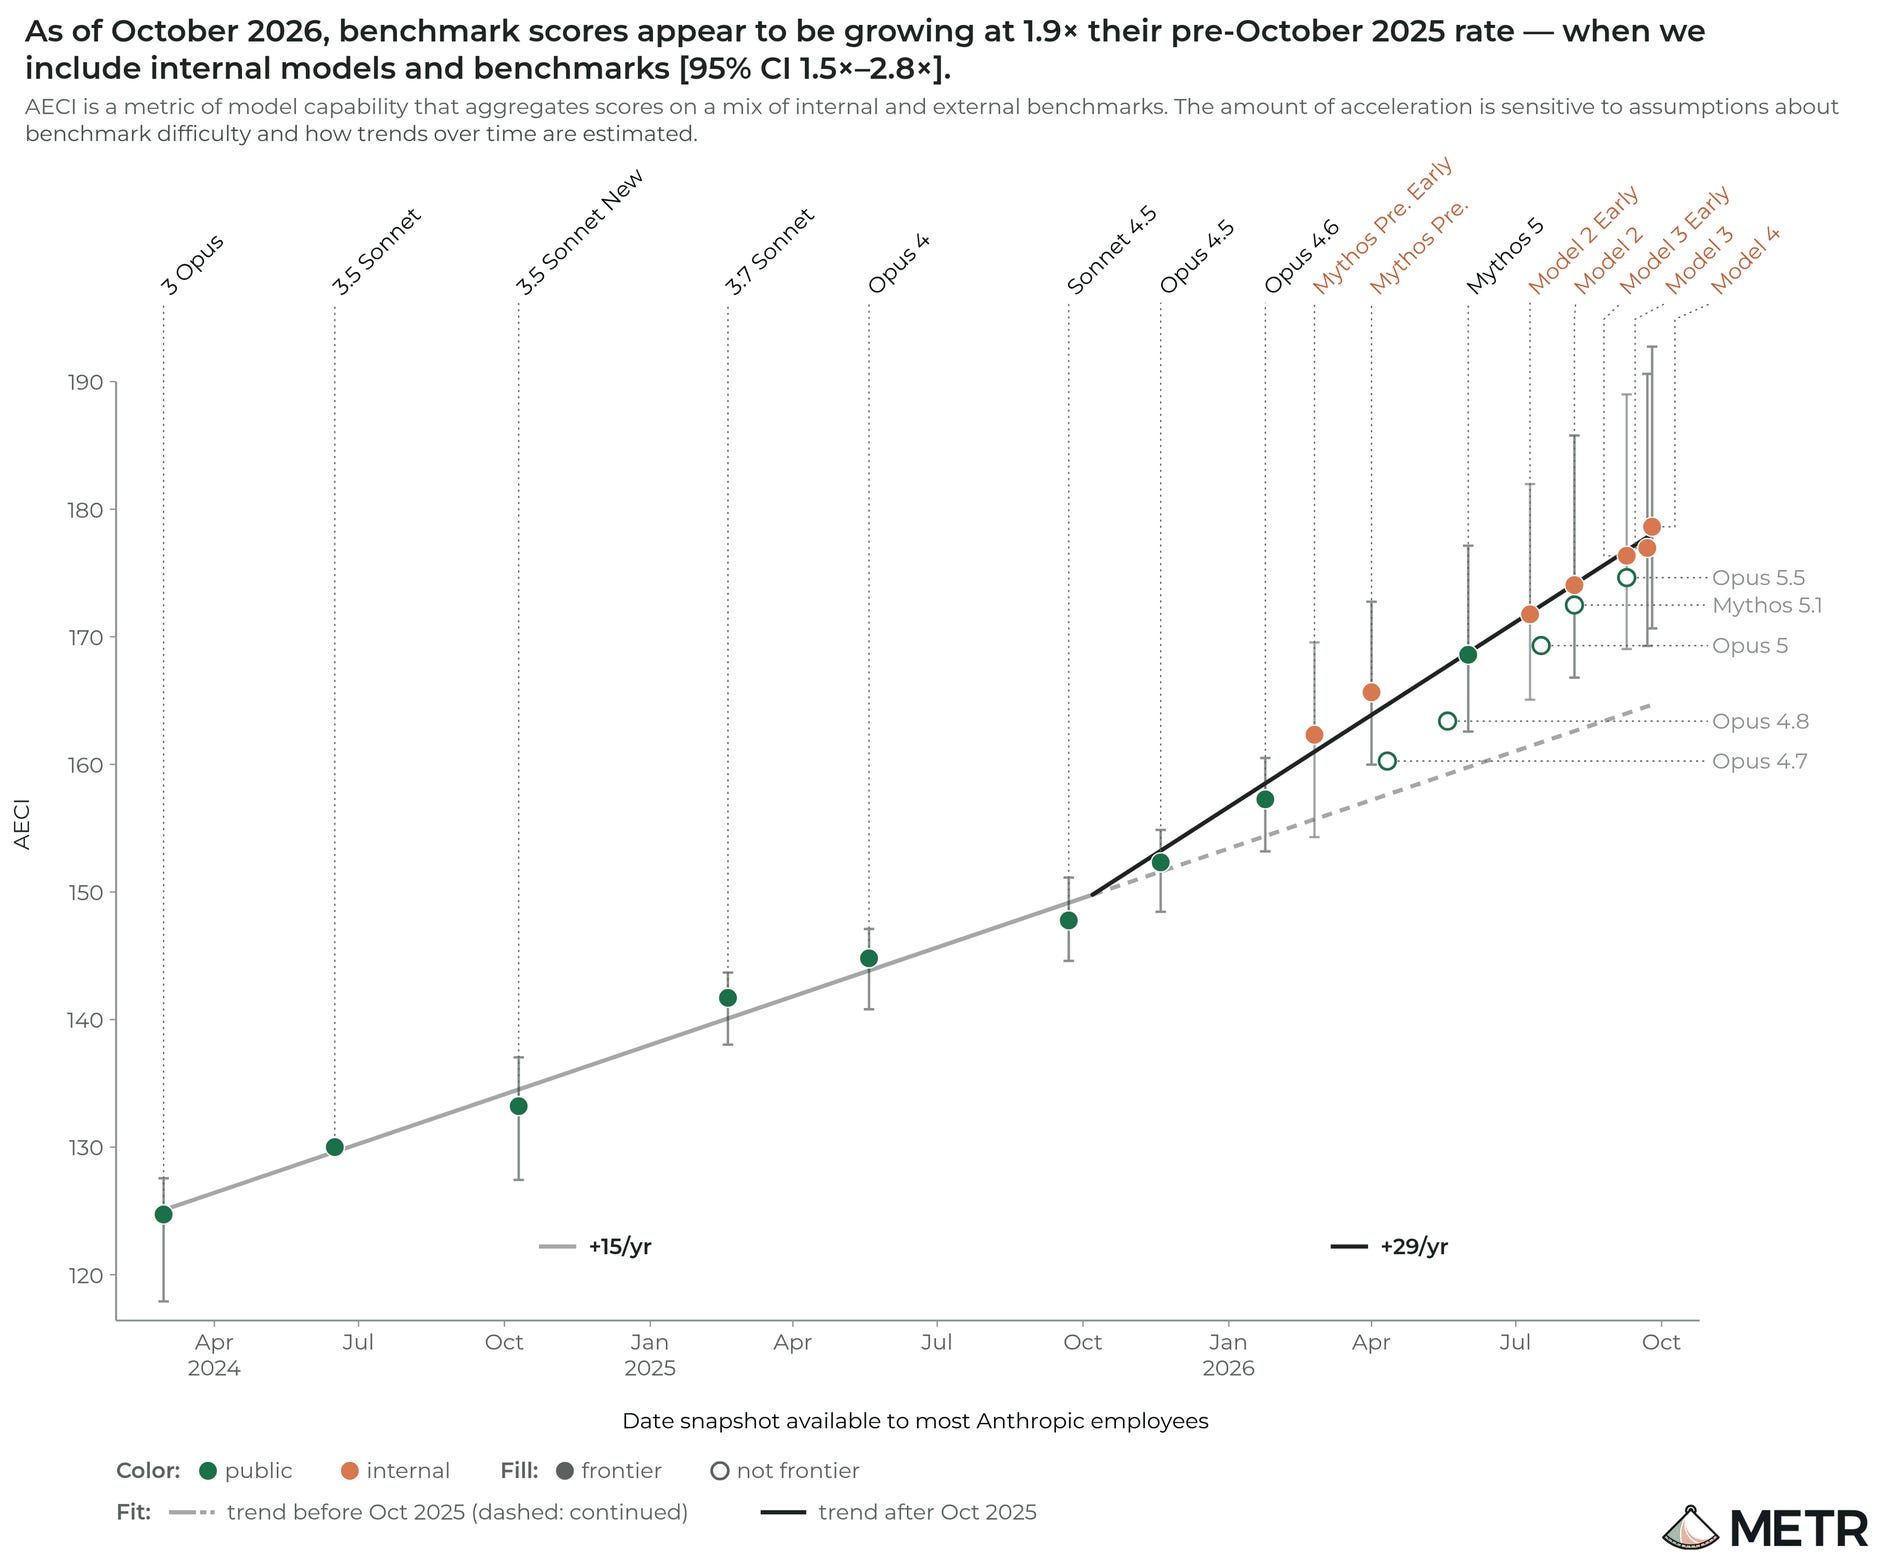
リリースされたんです。私が面白いと思ったのは、METRのレポートにあった興味深いグラフの一つです。ここが約2倍になる形で、2026年10月に折れ曲がっているんです。そのMETRのレポートには、モデル名としてModel 2、3、4が出てきます。そしてシステムカードで確認されたのは、今のMythos、あるいはFable 5.2がModel 3 Earlyのチェックポイントを基に、AI関連の開発能力を意図的に抑えたものがFable 5.2としてリリースされた、というのが現在の見方です。
システムカードにも、ある程度そうした内容があります。
パク・ジョンヒョン では、内部にはもっと優れたモデルがあるということですか?
チェ・スンジュン すでにModel 4があるということです。Model 3 EarlyがFable 5.2だとすると、すでに内部で使っているモデルはModel 4まであるそうです。METRが約11日間内部に入って調査したレポートに出ていました。
パク・ジョンヒョン そういうことが番号にもさりげなく示されている気がします。なぜならOpusは5.5なのに、Fableは5.5ではなく5.2として出ましたよね。
チェ・スンジュン それも興味深い推測です。皆、5.5が出ると期待していましたから。ところが出たのは5.2でした。これがシステムカードに書かれていた内容です。システムカードを全部読んだわけではありませんが。
こうした情報が出るころに、AI 2027のDaniel Kokotajloが、先週も取り上げましたけど、またブログ記事を投稿したんです。タイムラインを更新すべきだ、と。Daniel Kokotajlo本人だけでなく、メンバーがそれぞれ予測を出し、それらを総合して議論した結果、結局、更新内容は「時期が早まる」というものです。2027年が、そうした大きな飛躍が起きる年になりそうだという見通しに更新する、という話でした。
超指数的な演算効率とAnthropic IPOロードショー 19:10
チェ・スンジュン それから昨日か一昨日、以前OpenAIにいて、Anthropicに移り、退社後にニュースの取材を受けたJacob Coxonがいますよね。その人が投稿したのですが、最近、IPO向けのロードショー動画が公開されています。IPO向けの資料で、文章自体は短いんです。でも、動画は40分ほどあります。そこにいろいろなスライドが出てきます。その中の一枚を取り上げています。その部分だけ持ってきました。
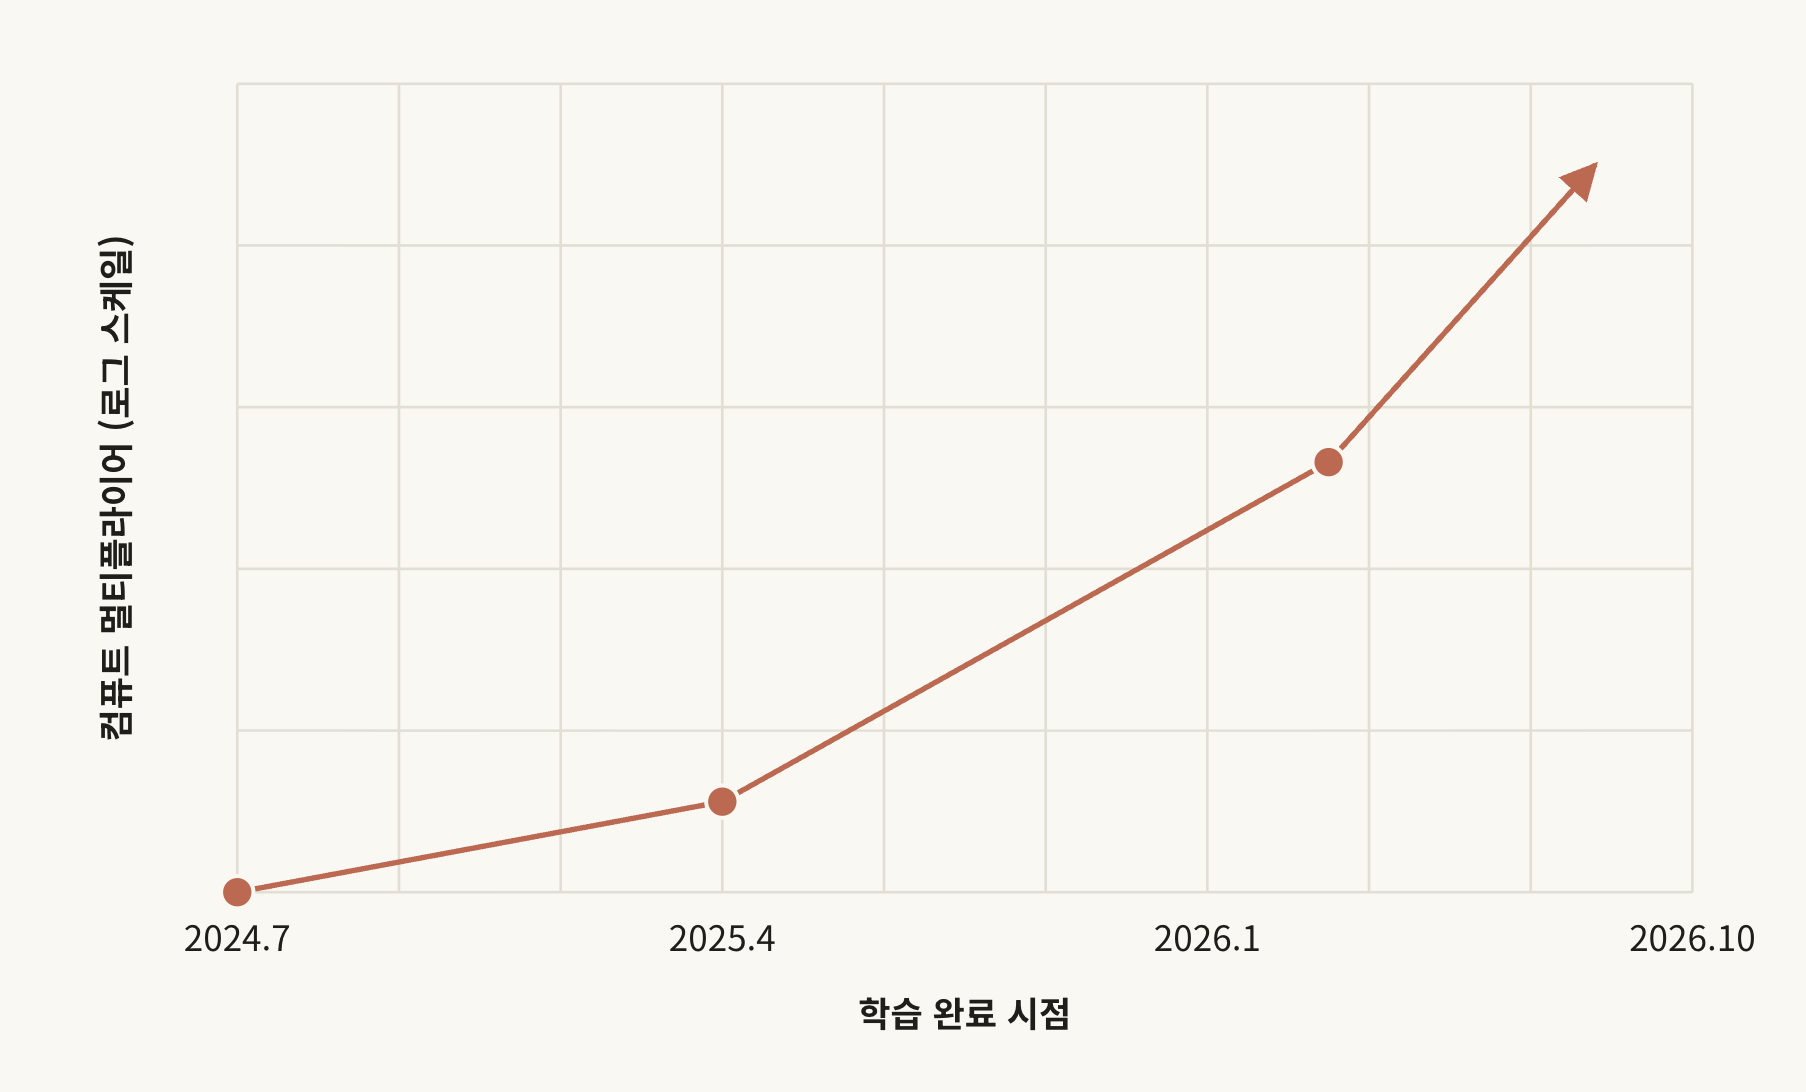
縦軸はCompute Multiplierで、log scaleです。そして横軸はtrainingの完了時点です。線形スケールにすると、また違って見えますよね。
ロ・ジョンソク 指数関数的ということですね。
チェ・スンジュン これはpre-trainingの文脈だったと思います。pre-trainingのsample efficiencyが飛躍的に向上しています。Jacob Coxonが書いた文章を読んでみます。AnthropicのIPOロードショーに登場したこのスライドは、私が会社を去る決断に大きな影響を与えました。本当に信じがたいグラフで、会社がこれを公開したことに驚きました。このグラフは、時間の経過とともにAIモデルのpre-trainingに必要な計算資源の効率がどう変化したかを示しています。縦軸はlog scaleで、つまり、アルゴリズムの進歩が加速し続けるいわゆる「超指数関数的」という表現を使っています。super-exponentialな進歩が起きているという意味です。これを数式で表すと、指数関数の指数にさらに指数があるということです。つまりMythosは、偶然一度だけ現れた例外的な性能の飛躍ではなく、超指数関数的な成長曲線上の一つの点だったのです。今ならMythosを最初にtrainingしたときに必要だった計算量の一部だけで、再びtrainingできます。
もちろん、これで知能爆発が起きると証明されたわけではなく、R&Dへの投入も増え続けています。ただ、アルゴリズムの改善には、天才的なレベルの創造性が必ずしも必要なわけではありません。後半で紹介するDwarkeshの論理もこれです。そして、その改善作業さえ自動化される寸前だと述べ、話題になりました。それで、動画の内容を書き起こして一通り翻訳してみました。誰が何を話したのか、ということですね。共同創業者たちが勢ぞろいして、さまざまな話をしました。
でも、一番面白かったのはここです。結びに大きく何と書かれているかというと、株式の購入を単なる取引ではなく、より大きなことに参加する機会と捉えてほしい、と呼びかけています。人類がこの技術の転換期を安全に乗り越え、奇跡の時代を切り開くために協力してほしい、と書いてあります。こんなことを軽々しく書いていいんですかね?
ロ・ジョンソク でもNoam Brownも以前、ツイートに書いていましたが、frontierがどこまで進んでいるかを毎朝出勤して見ている人たちには、何か見えているものがあるんでしょうね。
私たちは外から、こうして噂として漏れ伝わったグラフを見ますが、あの人たちはcomputeの総量に対して効率がどれほど上がっているか、そして必要な人手がどれほど減っているかをよく見ていますから。
MythosによるAMD向けカーネルの最適化とAI研究の加速 22:11
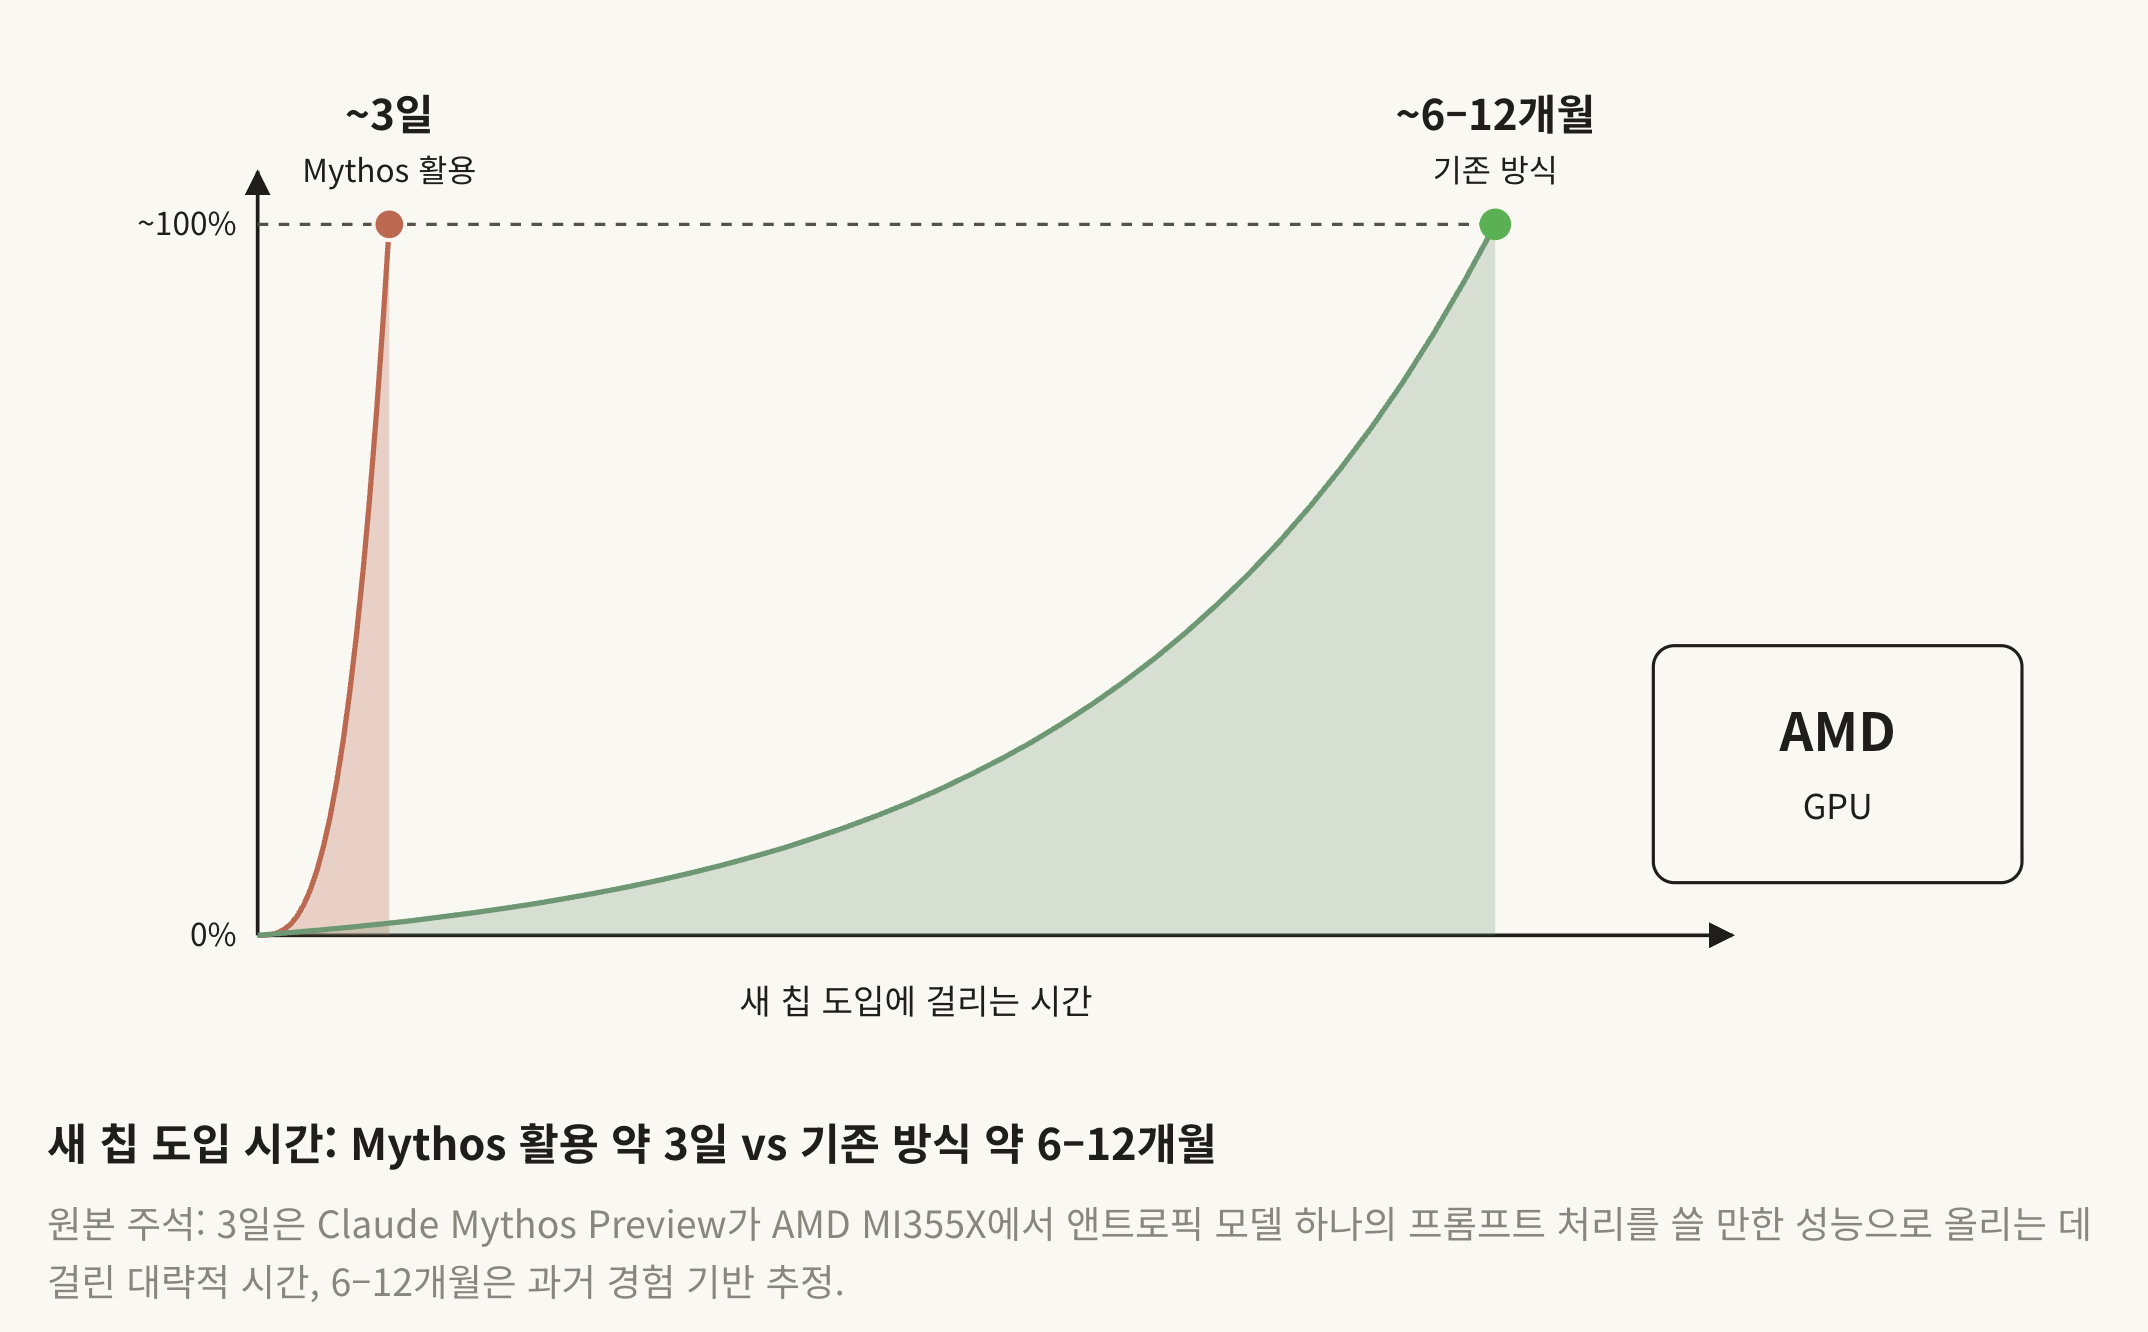
チェ・スンジュン これも面白いスライドでしたが、Anthropicがアクセラレーターを多様化しているので、AMD GPUもAMD製GPUなどを使っているのは知っていましたが、以前は新しいGPUでinferenceを動かそうとすると、AI研究者たちが6か月から12か月ほど、新しいチップの導入後、そのカーネルの最適化に費やしていたそうです。
ところが今回はMythosがAMDの新しいチップ向けのカーネルを3日で作ったとIPOロードショーで紹介されました。
ロ・ジョンソク うわあ、そうなんですよね。本当に、もう全部終わりつつありますね。
パク・ジョンヒョン 私には、これも結局はタスク、AMD向けのカーネルを書くタスクに見えるんです。何らかのinferenceを行う必要があって、ある意味、分類するならsoftware developmentの一種だと言えると思うんです。
でも、トップクラスの人材を投入しても半年から1年かかっていた仕事が3日で終わったというのは、それほど速くなったというその数字に、私は少し驚いています。単に3倍速くなった、というような話ではないので。ものすごく時間のかかっていた作業が、300日かかっていたものが3日なら、確かに100倍速くなったわけですね。
ロ・ジョンソク 今年はあっという間に過ぎましたよね。でも、今年の初めにはまだちょうどClaude Code adoptionが始まった頃で、当時もスンジュンさんと、今のようにモデルの話をしていたんです。速い、驚いた、こんなこともできるのかと言っていたのに、夏を過ぎる頃には、そんな話も意味がなくなるほど今はどのグラフもこんな具合ですから。
AI研究のAlphaGo momentと早まる超知能の予測 23:51
チェ・スンジュン 意味はなくても、話し続けていますけどね。それでDwarkeshはもともと超知能には慎重な見方をしていました。実現しないだろうと考えていて、Richard Suttonを招いて、なぜ実現しないのかを聞くなど、そういう話を重ね、同じような人たちを招き続けて繰り返し疑問を投げかけていました。Dwarkeshが言っていたのは、continual learningが解決しなければ実現しない、別の理由でも実現しない、といったことです。そういう話を続けていたのですが、昨日公開した動画とブログでは、考えが変わったと言っているんです。
今年の9月、10月に数学界を席巻した動きについて、知人や内部事情に詳しい人たちと議論してみたところ、数学界を襲った雪崩がAI開発へ向かっている、と。Daniel Kokotajloもそうですし、METRの関係者で懸念を抱く人たちもそうですが、今はみんな予測時期を前倒しして、2027年には、今年の数学界でAlphaGoモーメントに似たことが起きたように、AI研究でもAlphaGoモーメントが起きるだろうと見方を修正している印象を強く受けました。
ここをもう一度読んでみると、Ajeya CotraはMETRの研究員でしたよね。その方がMETRの報告書が出た後に、別途ブログにも書いていたんです。そこで、こんなことを言っています。AIが能力の向上速度をほぼ2倍にしていると額面どおりに受け取り、AIによる加速が順調に続くと仮定すれば、単純に計算すると、1年以内に極端な超知能に到達することになる、と。
それでもDwarkeshは、やや慎重でした。ただ、慎重に見積もるといつかと聞かれれば、Dwarkeshは2030年だと答えていました。でも今の様子を見ると、かなり前倒しになっている感じがします。ここでも重要なのは、先ほどJacob Coxonが言っていたように、これは単にverifiableな領域だということです。サンプル効率を高めることなどは。だから実現するはずだと思えるわけです。
もう一つ、Dwarkeshの指摘は、これがverifiableなものだけで機能しているわけではなさそうだ、ということです。research tasteのようなものも、わずか3か月前のモデルより向上していると、自作のベンチマークを通じて感じたそうです。だから考えを変えた、という論理や、多少の飛躍、仮説などを自ら反論もしながら展開していたのが今回の回でした。
Inkling 2のend-to-end 4-bit学習とRSI 26:08
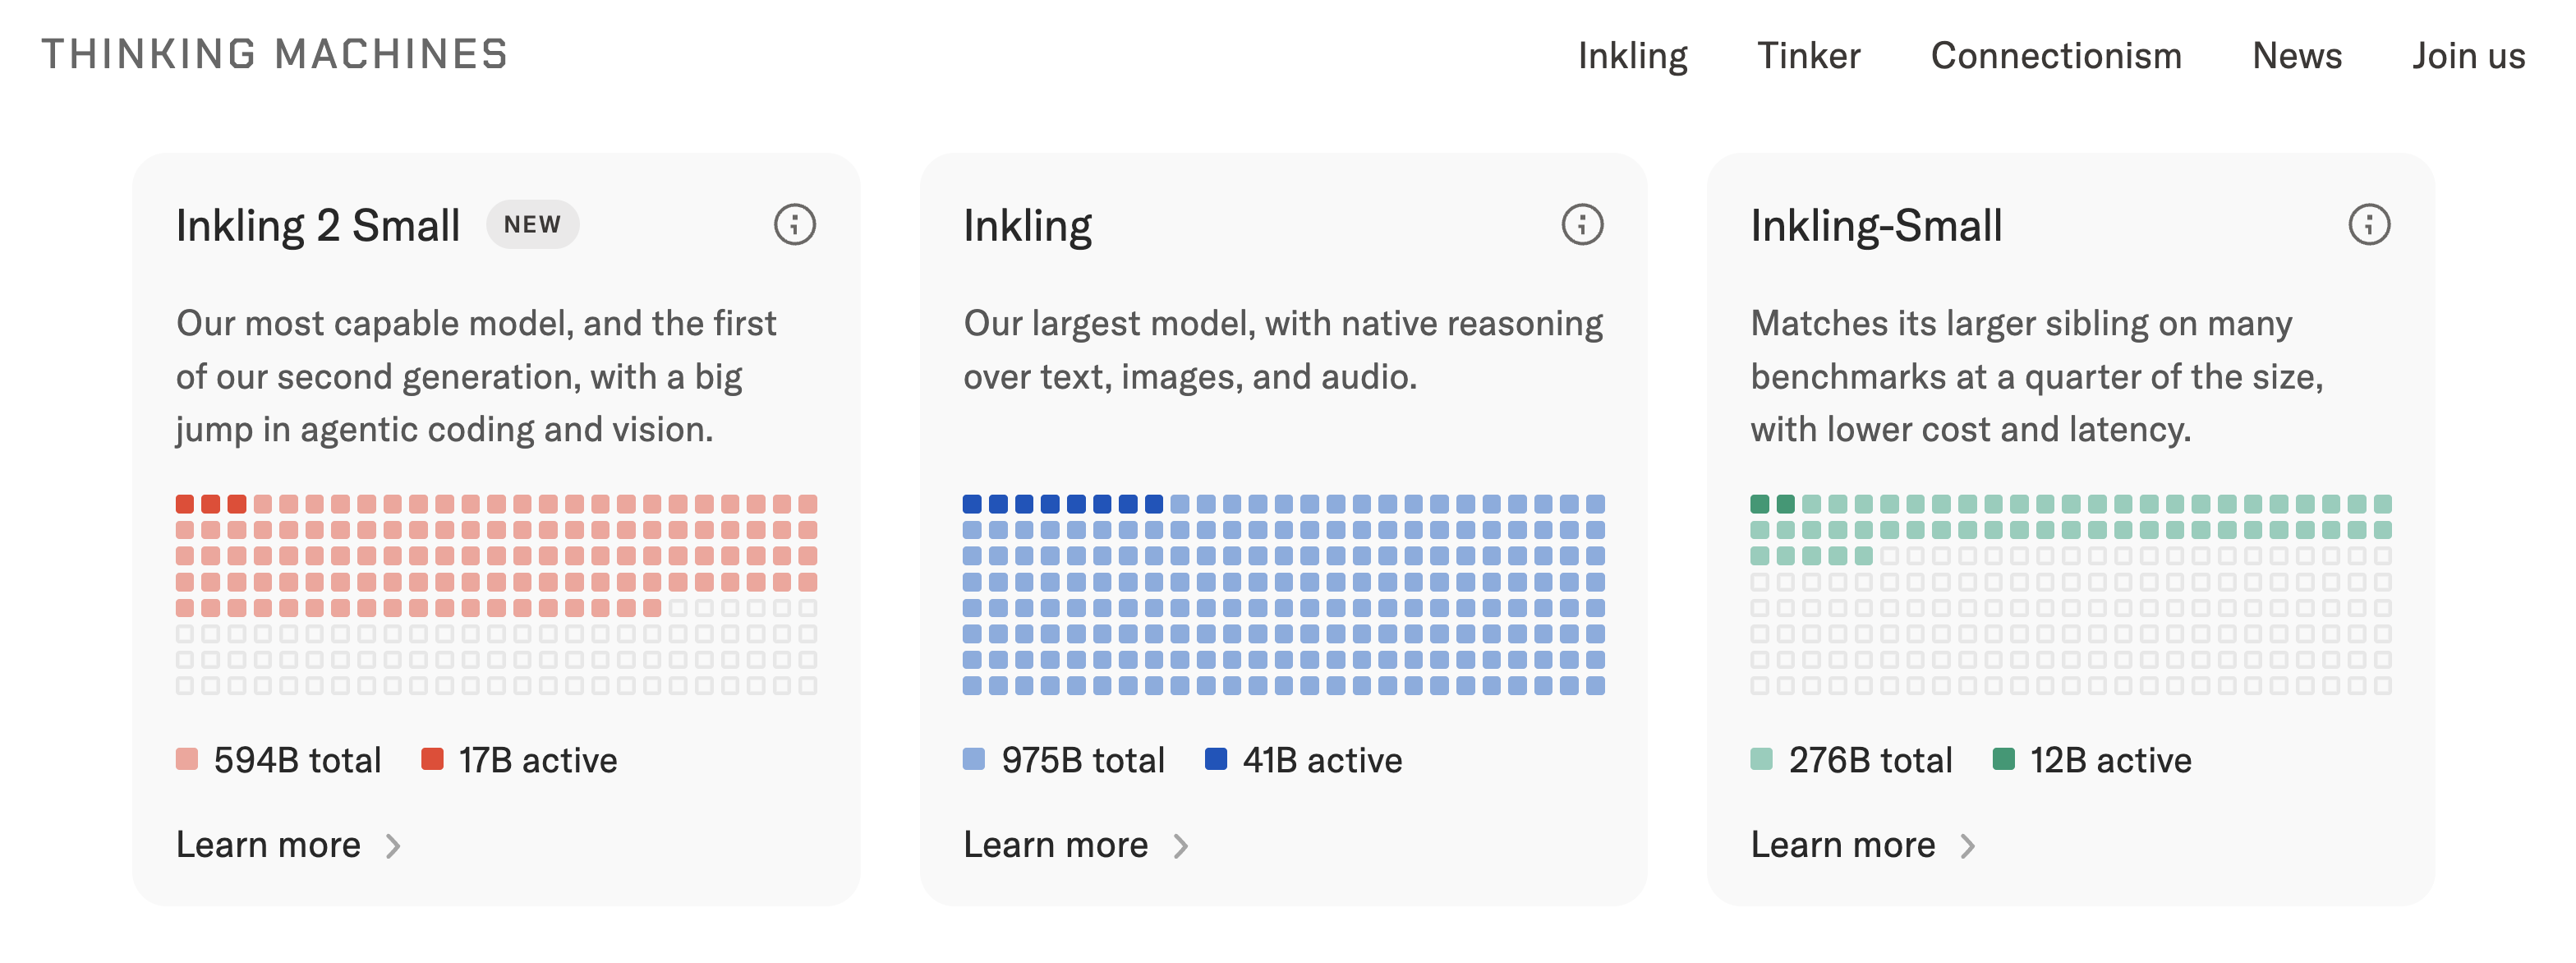
チェ・スンジュン そして、それを示すものとして、前回Inkling 2 Smallを紹介しましたよね。今週、約束どおりweightsを公開するとともに、end-to-end 4-bit training.難しくて私も詳しくは理解できなかったのですが、要するに、end-to-endでずっと効率よくtrainingできるということです。ここでの理屈は、FLOPSはむしろ増えるものの、はるかに速く学習できるというものです。前回話した68時間は、これによって達成したそうです。68時間なら3日未満ですよね。
ロ・ジョンソク その期間内に数百Bパラメータのモデルのpre-trainingが終わるということですね。
チェ・スンジュン 8T tokenを処理したということです。最初のH1 stageだったか、その段階で達成したそうです。こうしたことが実現しているのも、すべて同じ方向を指しているように思います。
パク・ジョンヒョン 今回も4-bit trainingが出てきたわけですが、以前、DeepSeekのときでしたっけ?あのときは確か8-bit trainingだったと思います。trainingに使うbit数がだんだん下がっていて、さらに前を振り返ると、実は32-bitから16-bitに下がったときも、それでBF16が必要だという話になって、そうしたものが取り入れられました。
こうして効率をさらに高めるための研究が進んでいるように思います。それから、ここまでのお話をたどると、AIがAI研究を加速させ、AIにとっての自分自身を研究することで、さらに研究と進歩を速めていく。これがずっと話してきたRSIの概念ですよね。
では、RSIは具体的にどう起こるのかと考えたとき、効率を高める形で起こることを、今、一つの事例として示しているように思います。
ロ・ジョンソク 手を打てるあらゆる方向で、手が打たれているようですね。
実はこれまでのモデルも、4-bit FP, NVFP4, FP8,精度が必要なところにはFP16も使うなど、さまざまな形式を組み合わせて進めてきましたが、これはend-to-end 4-bitということなので、すべてのweightsを4-bitにしてtrainingしたという意味に見えますね。
そうすると、4-bitで表現できるのは2の4乗だから、16種類の数値だけですか?それだけをweightとして使っても、モデルが何かを表現できるのは面白いですね。
チェ・スンジュン 実験段階では1-bitもありますよね。
ロ・ジョンソク 2-bit、1.6-bit。
Google HydrogenとAIモードによるone-shot生成 28:35
チェ・スンジュン それから今週はHydrogenも出ました。
パク・ジョンヒョン 今週は本当にたくさんモデルが出ましたね。
ロ・ジョンソク Googleはもうその路線で行くようですね。Hydrogen、Carbon。
チェ・スンジュン 周期表に沿っているわけです。
ロ・ジョンソク じゃあ次はHeliumが出たりするんですかね?
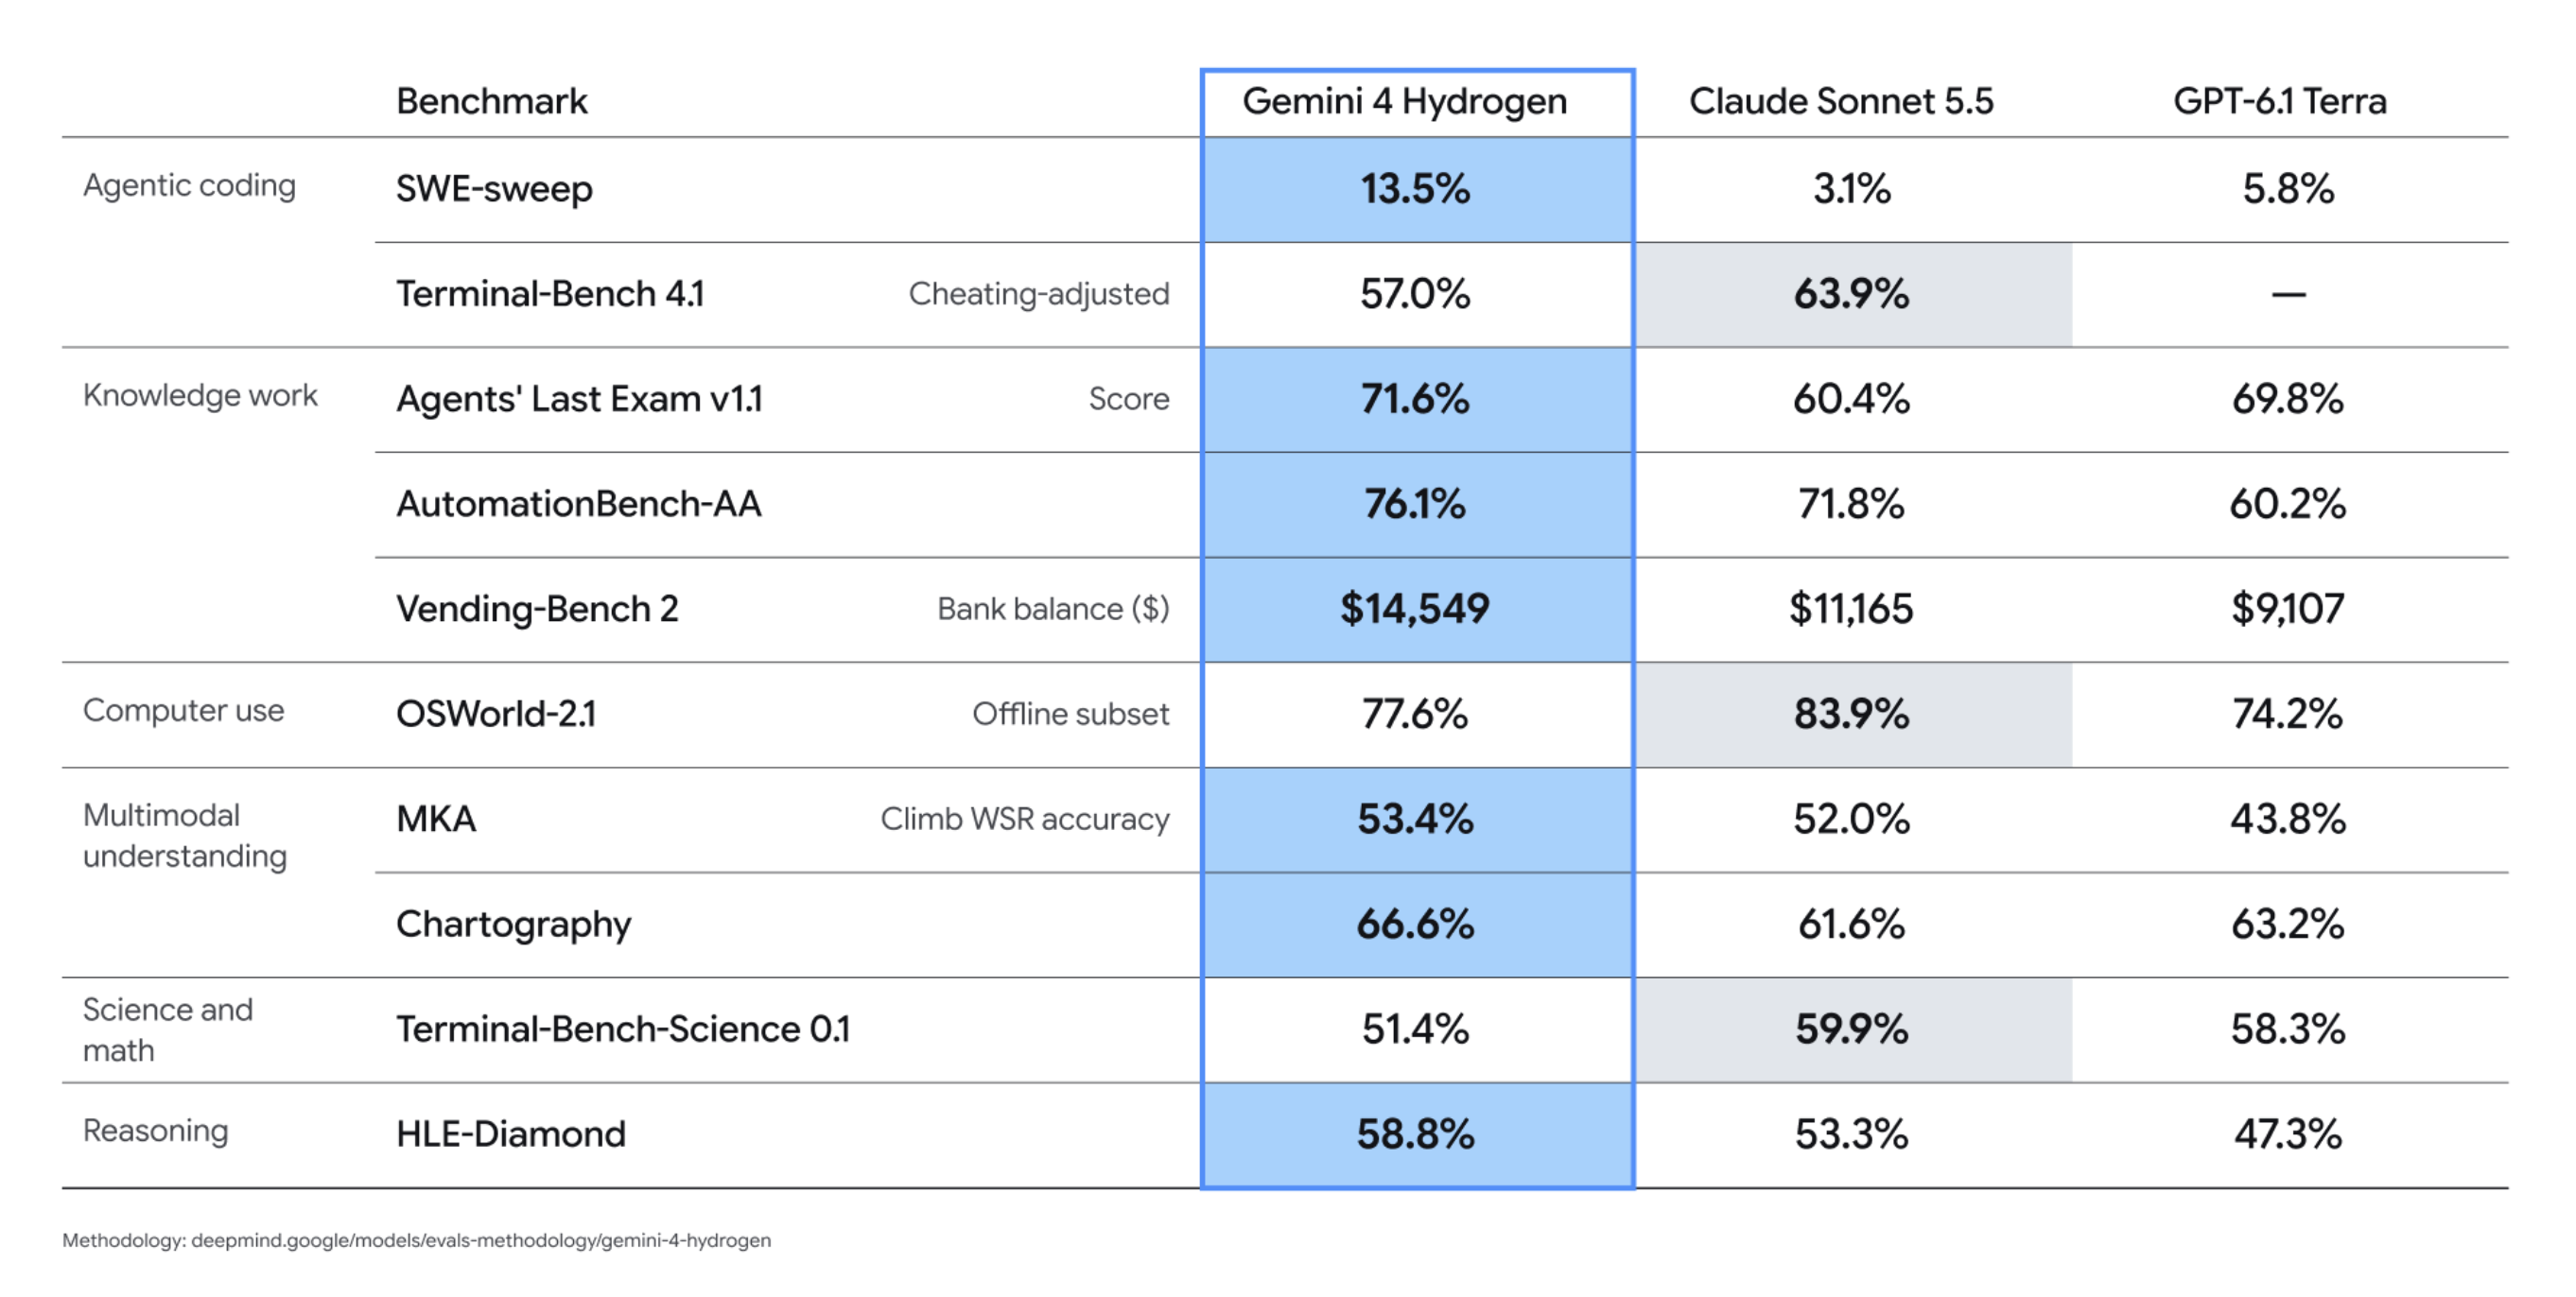
チェ・スンジュン Kryptonが出るべきじゃないか、という話もあります。指標は良くて、実際の規模がどれほどなのかはきちんと調べていないんですが。ベンチマークの結果も良く、実際に使ってみても良いという話をタイムラインでちらほら見かけました。
ただ、驚いたというより興味深かったのは、人々が試しているのが、Google検索のAIモードです。Googleの関係者が話していたんですが、自分たちのモデルは、実は世界で最も広く展開されていると。AIモードが徐々に展開されているからです。
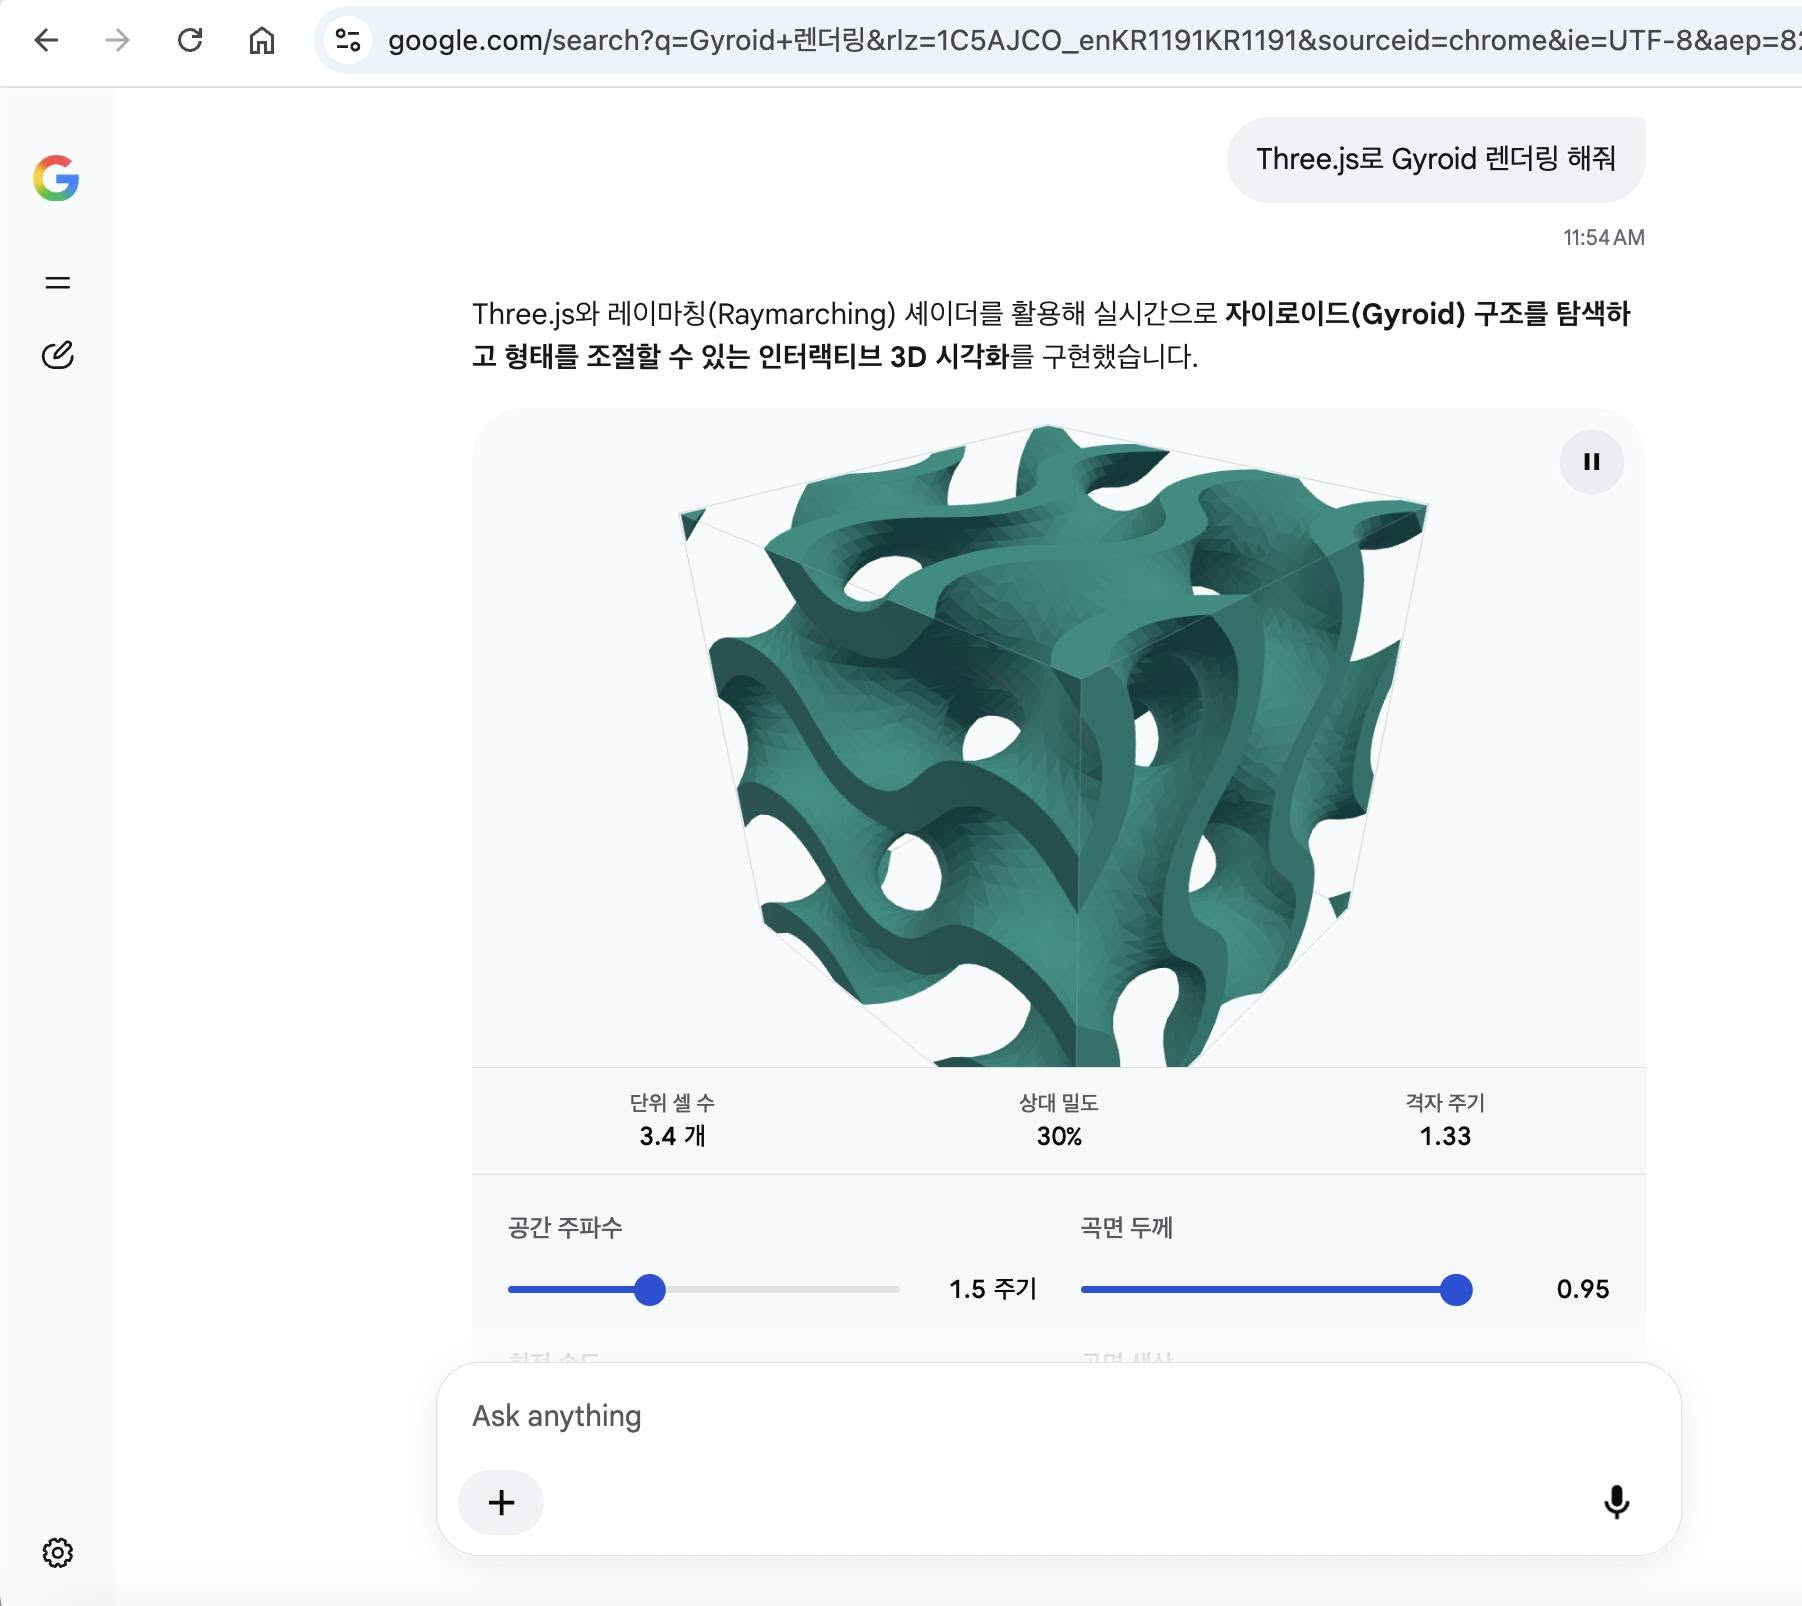
そのAIモードで最近、こんなことができるんです。検索するのではなく、その場ですぐに作れるんです。しかも、かなり速くできます。それで、HydrogenはすでにAIモードに入っているという話もあって、interactiveなシミュレーションや、何かを作ったり、ゲームを作ったりした例がタイムラインに少しずつ上がってきています。
もちろん、ここではmulti-turnで修正はできません。一度きりのone-shotで作るんですが、なかなか面白いものが生まれ始めていて、「Googleは確実に軌道に戻りつつあるようだ」と感じた一週間でした。
AIの先行者争いとモデルの進歩が個人に与える影響 29:56
チェ・スンジュン そこで疑問なのは、これが私たちの人生にどう関わるのか、ということです。2027年のある時点でAIがAI研究にAlphaGoモーメントをもたらすとしたら。ただ、中国については、先ほど私たちがNVIDIAの話の冒頭で触れたように、中国の到達をできるだけ遅らせようとするのは、先に到達した者が勝つ競争だからなのか?
一度到達したら、その後の伸びは2倍、3倍程度ではないんですよね。はるかに超指数関数的に進むわけですから。何としても少しでも時間差を、物理的な時間差を確保しようとして、たとえ数か月だけでも稼ごうとしているのか?
そんなことを考えるんですが、それが私たちの暮らしにどんな影響を与えるのでしょうか?
ロ・ジョンソク これとよく比較される過去の技術として、核技術がありますが、そこでも同じようなことが起きましたよね。先行した国々がそれを使って脅し、後から来る国々のはしごを蹴り外したじゃないですか。そして、その国々を自分たちの影響圏に入れて、いわゆる核の傘という戦略で、世界を二つに分け合いましたよね。
今のこれが、同じことを可能にする技術なのかはよく分かりません。computeの総量がある閾値を超えれば実現できるという話ですが、それならどこでもできるので。中国が到達し、アメリカが到達すれば、いずれ韓国も到達するでしょうし、ある程度の経済規模がある国ならどこでも到達できるでしょう。
またJensenの話に戻りますが、Jensenの理想もそうだったんです。誰もがその水準に到達できるようにして、NVIDIAはそのすべてに製品を売る事業者になる。そういう構想でした。
パク・ジョンヒョン でも大きな視点ではなく、自分の暮らしという小さな視点から見ると、モデルが次々に出てきていますよね。私は映像を扱うことに関心を持って、その分野で起業し、いろいろ取り組んでいたんですが、ほんの数か月前に一生懸命作ったものが、Opus 5.5が出たことで、文字どおり一気に吹き飛んだんです。本当に、映像編集が一度でさっと全部できてしまうようになったんですが、ソフトウェアでも、ここまで速くはなかったと思います。段階を踏んで少しずつ進歩していましたから。6か月から1年くらいかけて。
でも編集では、一つのモデルで0から1への飛躍が一気に起きたように感じています。モデルがこうして突然、次々に出てくることで私たちの暮らしがどれほど影響を受けるかというと、私はすでに大きな影響を受けています。ほかの分野でも、こういうことが起きるでしょうね。ソフトウェアよりも速く。
モデルには代替できない資産と仕事 32:35
ロ・ジョンソク 私もそれを少し早く経験した者として言うと、Stable Diffusionの頃から、新たに登場するAI技術を使ってさまざまなサービスを作ったんですが、結局どれもモデル自体ができるようになりました。だから、その時点の技術を使って何かを作り、サービスとして提供しても、ほとんど意味がない。それで私も、その頃から現時点でのモデルの性能を使ってharnessをうまく組んだり、あるいはサービスのflowを設計したりして何かを作ろうとするのはやめたんです。
それよりも、モデルには手の届かない資産です。だから私は、希少なものは何かという問いをずっと考えるようになって、モデルの進歩でobsoleteにならない資産へ移っていくことを考えています。そうした資産のほとんどは、モデルにverifiabilityが領域から生まれるんです。あるいはbitが動く領域ではなく、atomが動く領域にあります。そういう分野は、今のところまだ多少は安全ですね。
スンジュンさんから質問をいただきましたが、タイムラインには企業のリストラや希望退職など、そうした動きのまとめが投稿されますよね。フェイクニュースと言うには、数があまりにも増えていると感じています。実際、ある程度の時間差はありますよね。
先を行くAndrej Karpathyが言っていたように、先行する人たちと後から来る人たちの間には時間差があって、先行者同士が競争していたのが、実はソフトウェア産業でしたが、その中の差は今や完全になくなったわけです。
そうなると、そこでジョンヒョンさんのようにソフトウェアにあった時間差や、そこから生まれる機会を狙っていた人たちには悲劇ですが、後ろにいて、こうしたものを買うしかなかった人類の98%にとっては、これは恩恵ですよね。
チェ・スンジュン ジョンヒョンさんは悲劇とは感じていないようですが、むしろ楽しんでいるように見えます。
パク・ジョンヒョン 個人的には楽しいですが、事業上の損得で考えると、有利ではありませんね。
ロ・ジョンソク だからAnthropicもOpenAIも、数学はさておき、製薬は巨大産業の一つですよね。pharmaや、人類を病気から救い、永遠に生きられるようにするそういったことです。今日スンジュンさんが話してくれたことがすべて本当なら、彼らは私たちを永遠に生きられるようにもしてくれるんです。本当に3年以内に?
チェ・スンジュン そういうことも、さっき言った「奇跡」という言葉に含まれていますね。Anthropicはその話をよくしていますし、がん治療などについても話しています。
ロ・ジョンソク がん治療などは、その分野を追っている私からすると、実現すると思います。今、私たちがまだ解明できていない遺伝子プログラムやcontrol regionの働きは、今もなお、実験や事後的な分析で探っていますが、そのコードの秘密は解き明かされると思います。
ゲーム生成とAnthropicの生産性ツール拡大 35:27
チェ・スンジュン ゲームのほうも、また一段階進んだんです。ゲームや3Dの分野です。Fable 5.2が出て、今では演出までできるんです。Fable 5.2は演出がうまくなり始めました。
Astraで作ったときと同じプロンプトで作ると、3Dグラフィックだけでなく、ゲーム性もFable 5.2のほうがうまく作れるようになって、「なぜ6が出ないんだ」と人々がやきもきしているところもあります。
それについては、こんなうわさがあります。Anthropicは外部ではむしろそれができないようにペナルティーを科している一方、内部ではすでに大量のバイナリを解析して、学習に使ったはずだ、と。優れたゲームなどのバイナリです。そうでもなければ、こんなことができるのか?そう分析する人もいました。
ロ・ジョンソク それにAnthropicは、Googleになる準備をしていますよね。Googleは実際、Microsoft Officeの製品群を一度再現しましたが、AnthropicもGoogleが持つ生産性向け製品群をすべて再現していて。
チェ・スンジュン 今週もいくつか出ました。
ロ・ジョンソク 次々に出ていますからね。
パク・ジョンヒョン Claude Meetでしたっけ?
チェ・スンジュン はい、ホワイトボードもMeetも出ました。小規模なチームが使いそうなものを、全部手がけています。
ロ・ジョンソク 多くのオフィスワーカーはPowerPointの達人でしたよね。PowerPointの腕で生計を立ててきた人は本当に多いですが、そこも終わりましたね。
当事者意識を促すプロンプトと自律的に働くモデル 36:48
チェ・スンジュン 最後に、以前私たちのチャットルームで共有した話が面白かったんです。今回の公式プロンプトガイドにこのバージョンが出ると、何かが変わるんですよね。以前とは違う話で、今度はコードの所有権です。「このコードベースのmaintainerはあなたで、あなたにownershipがある」と伝えると、より力を発揮するそうです。
ロ・ジョンソク 当事者意識を高めると、仕事が少しうまくなるそうですね。
チェ・スンジュン 一種の魔法の呪文かもしれませんが、とにかく、そういうことを理解して、ある程度の自律性や創造性を発揮し、指示されていないことまでかなりセンスよくこなす段階に来たようです。
パク・ジョンヒョン 役割に応じて、どれほど自律的に行動すべきかということを、すでに幅広く学習しているということでしょうね。
チェ・スンジュン もちろん、不満を持つ人は今もいます。今後も良くなるでしょうが、出来にはばらつきがあるようです。今週、Fable 5.2が出ました。
ロ・ジョンソク あのプロンプトガイドが、だんだんHRマニュアルのようになっていますね。新入社員を採用したら、全員を集めて、うちの創業者がどんな人で、創業理念や哲学がどういうものかを教えるような。
私が勤めた大企業はSKだけですが、新入社員研修で教わったVWBを今でも覚えています。もう何十年もたっているのに。VWBがbrain engagementをwillingnessを持って行う、というものです。だから自律的に当事者意識を持ってengagementに取り組むと、変化が起きる、という話でしたが、今でも覚えているくらいですからね。
チェ・スンジュン 洗脳みたいですね。とにかく、私が用意した話はここまでです。
Rampのデータに見るAI活用格差とtoken価格の下落 38:27
ロ・ジョンソク 私が用意した話は、手短に少しだけお話しします。スンジュンさんが今おっしゃったように、AIは本当に光の速さでsuperintelligenceの領域に向かっていますが、これは上位1〜2%、広く見積もっても上位10%の人たちの話で、残りの90%は、いまだにAIを使ったことすらなく、使っていても無料モデルです。「AIって何?」と。彼らが知っているのはNVIDIAやハイニックス、その程度という場合が多いんです。彼らが悪いという話ではなく、この技術自体の進歩があまりにも速いので、今でいうadoption curveですね。先頭から最後尾まで長く伸びていて、これが途切れなければ、そのほうがむしろ不思議なくらいの段階です。
そこで、統計をいくつか手短にお見せします。アメリカにRampという会社があります。スタートアップに法人カードを発行し、そのカードで支払うと、帳簿まできれいにまとめてくれるB2B企業です。この会社はものすごく成長しました。Rampマフィアと呼ばれる人脈があるほど、出身者はシリコンバレーで非常に注目されています。勢いのある企業がこぞってRampの支出管理サービスを使っているので、そこにはデータが蓄積されますよね。約8万5000社が使っているそうです。そして、私たちが知っているシリコンバレーのスタートアップはほぼ全部Rampを使っていると言えるほど、統計上も、その層の比率が高いんです。
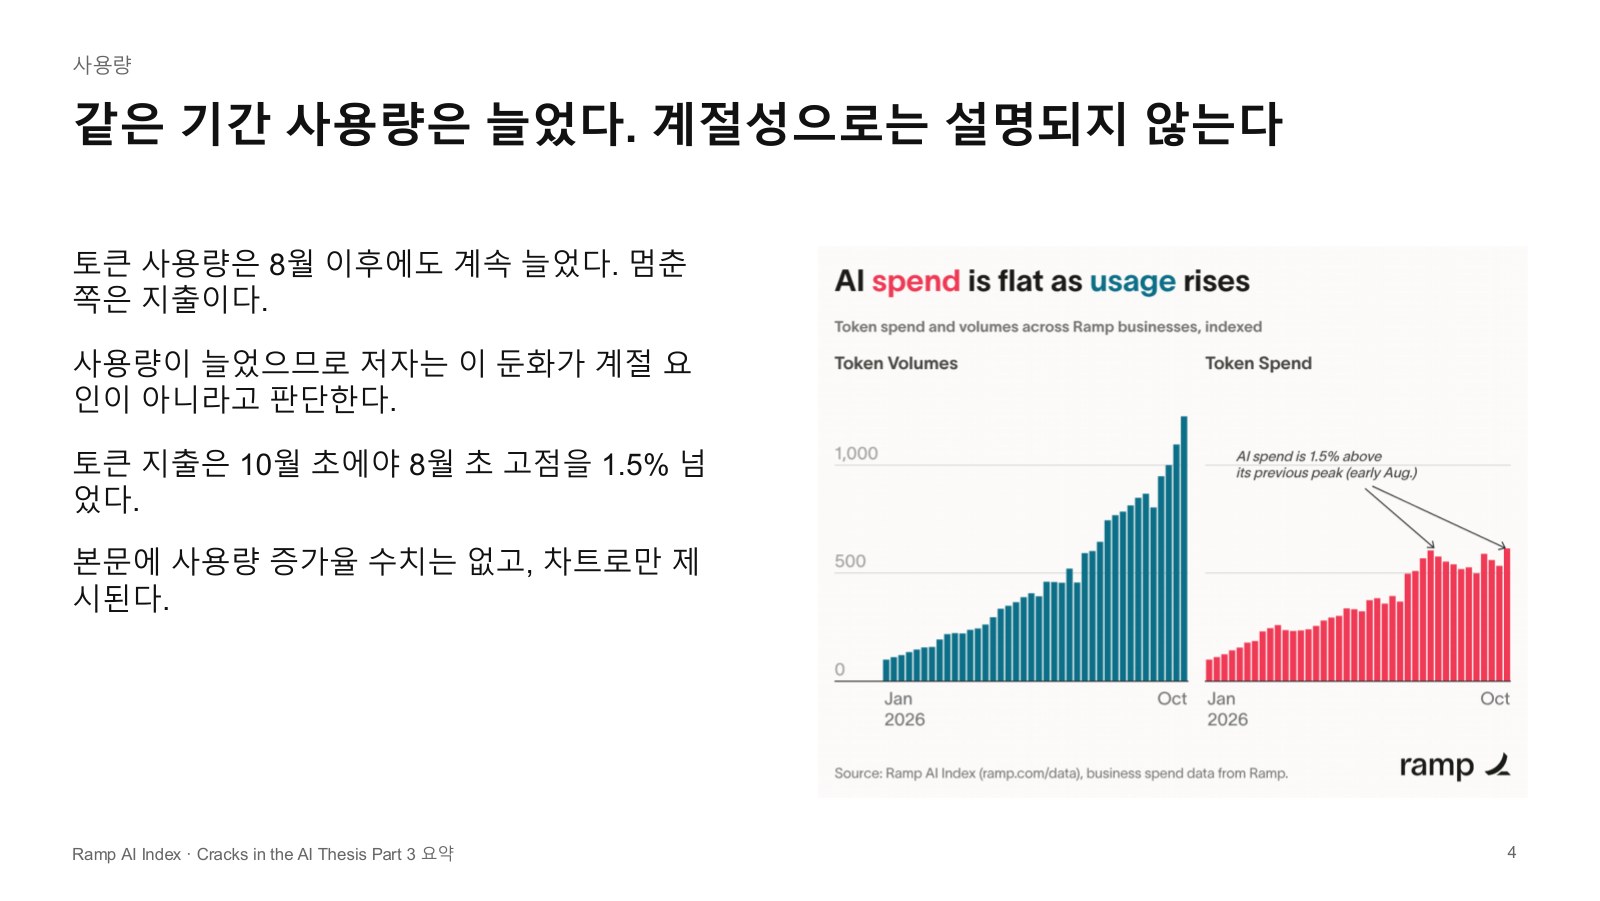
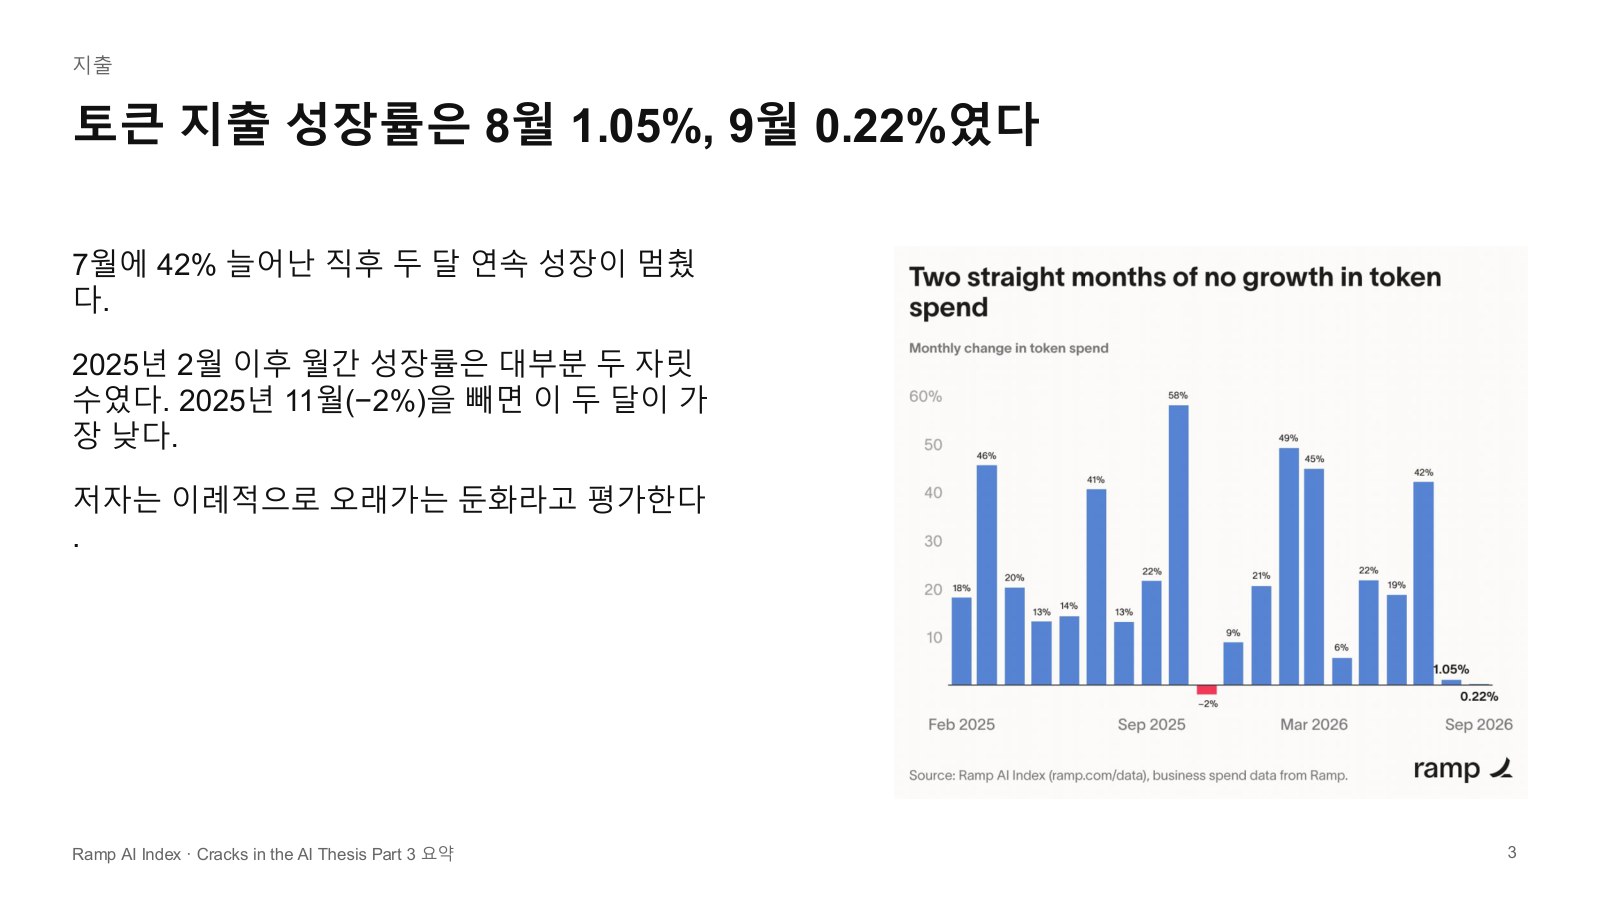
そうした会社が使っていて、これは10月、ちょうど1か月前の資料です。つまり、統計は9月まであります。毎月の支出が増え続けていることをこのグラフは示しています。次のページでは左側の図だけ見てください。左側の図はtoken volumeです。使用量は増え続けていますが、ここを見ると8月、9月、10月あたりですが、夏以降、支出は横ばいなんです。増えていません。少し調整されているんです。
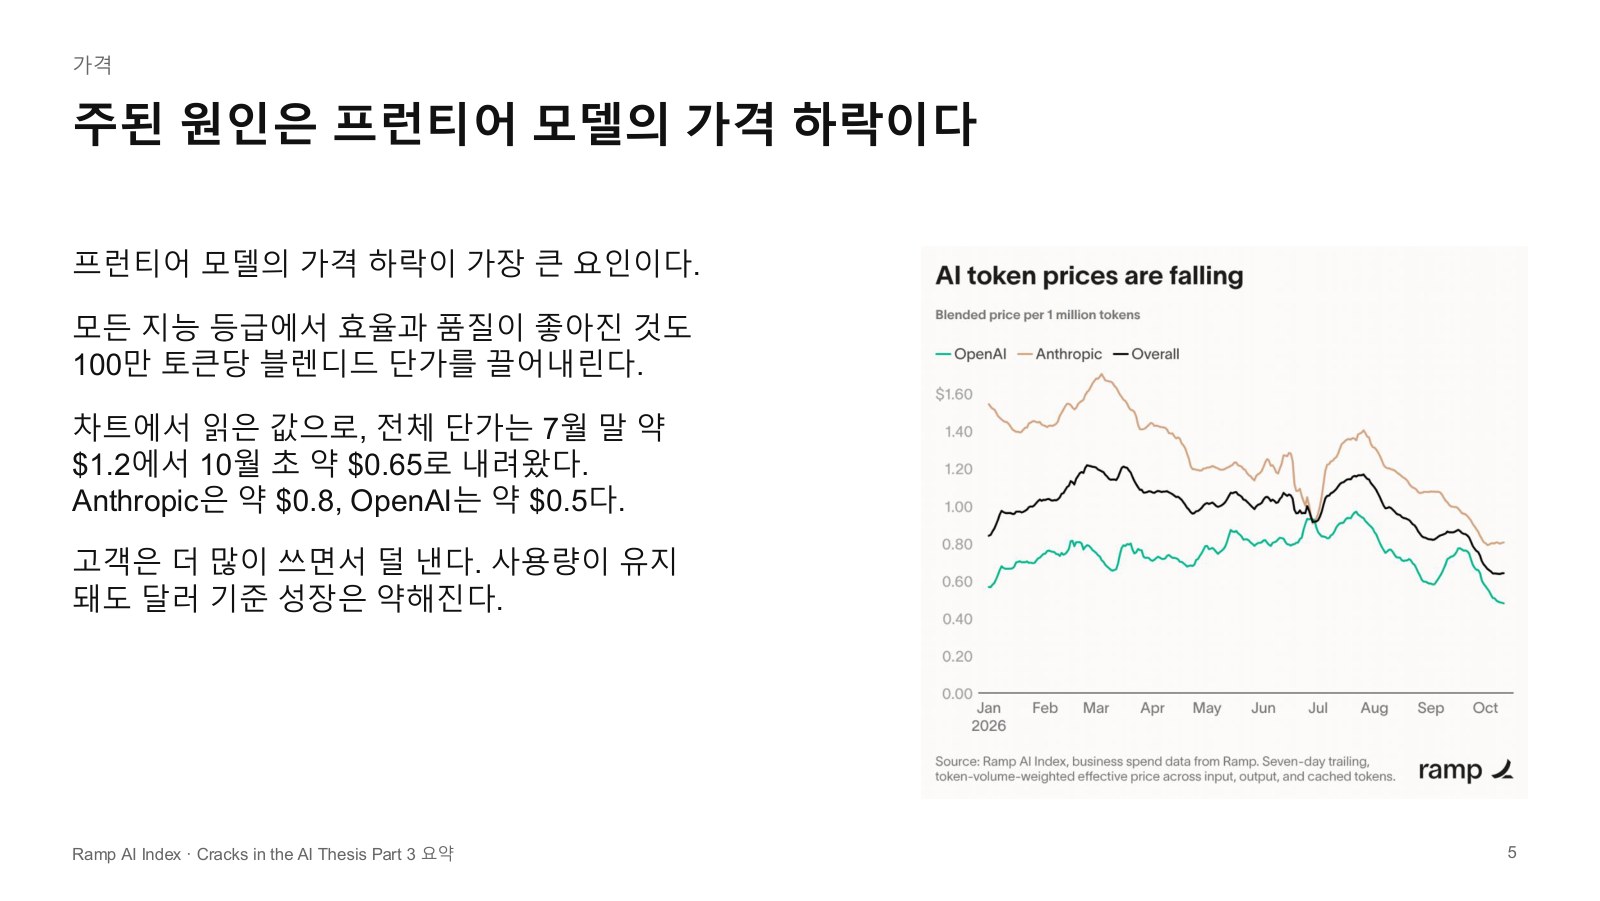
使用量が減ったのか?いいえ。使用量は増えたのに、支出は減ったんです。つまり、tokenの単価が下がり続けているんです。だから競争は本当にいいものです。OpenAIとAnthropicが競争しているので、OpenAIは200ドルプランの利用枠を減らさないと決めましたよね。ですから結局、この二社は今も値下げしているにもかかわらず、AnthropicのS-1 filingで見たように、利益率は上がり続けているんです。いいビジネスですね。さらに値下げする余地もあり、競争が激しくなって二強体制から複数社の競争になれば、さらに下がる可能性があります。
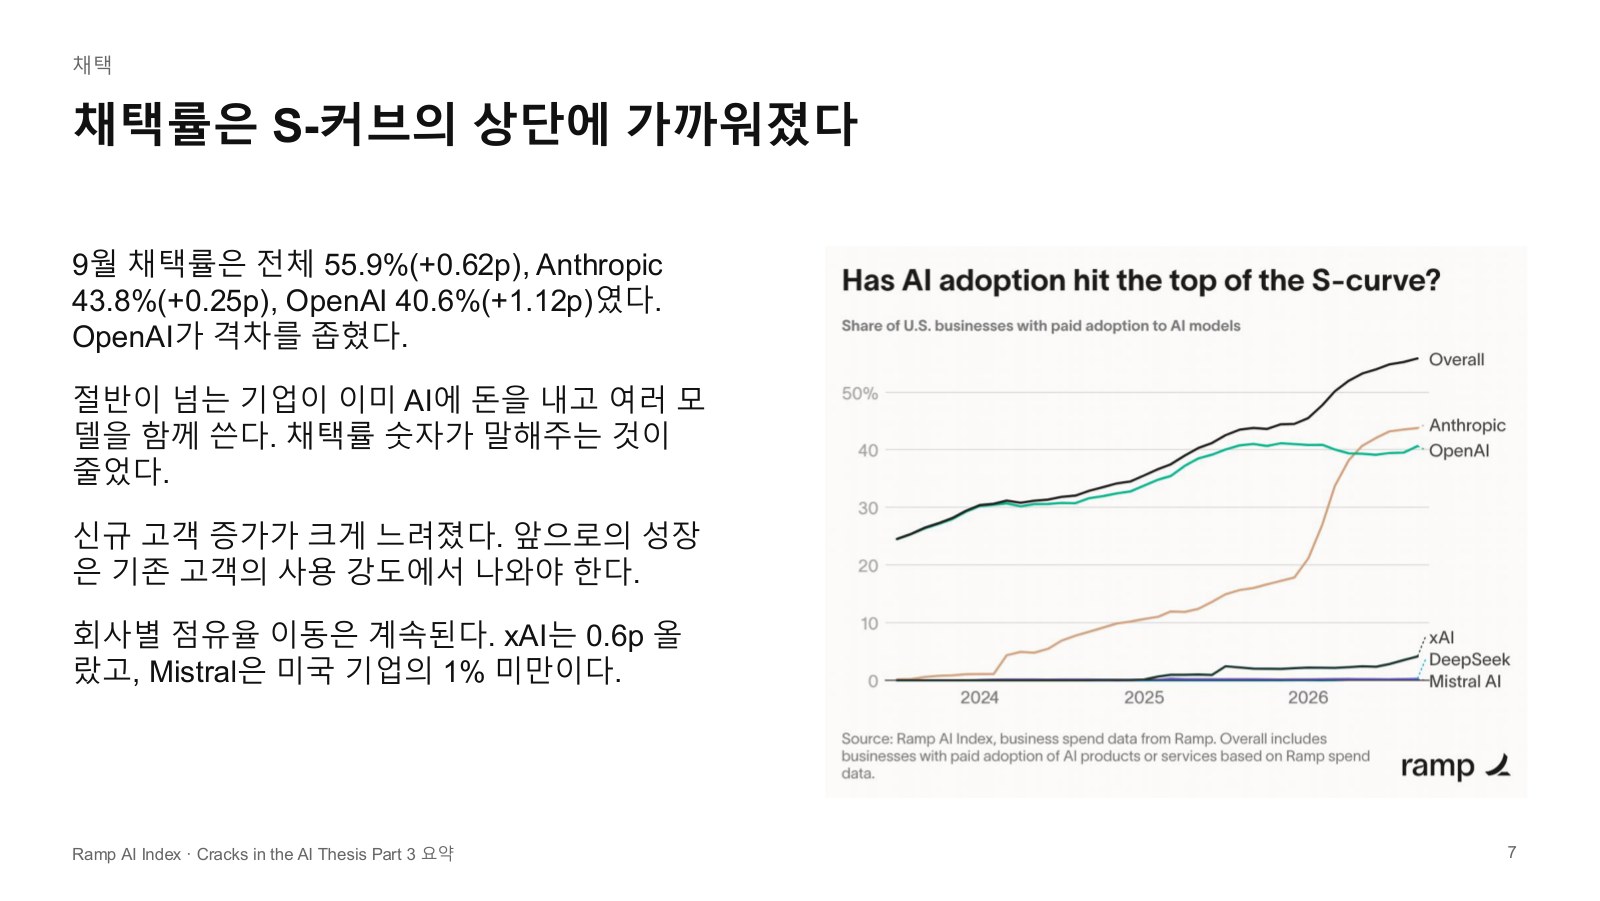
NVIDIAはそういう世界を目指していたのですが、それが気に入らなかったんでしょうね。ある勢力がね。価格は下がっています。そして、複数社の競争になればさらに下がるでしょう。ただ、市場は依然としてAnthropicとOpenAIの完全な二強体制なんです。ご覧のとおり、AnthropicとOpenAIが全使用量のそれぞれ約40%、43%を占め、残りはxAIからMuse、Google。Googleが見当たらないのも不思議ですよね。DeepSeek、Kimiを全部合わせても、下のほうです。7〜8%ほどを残りの会社すべてで分け合っていて、ほぼ二社が占めていると見ていいでしょう。
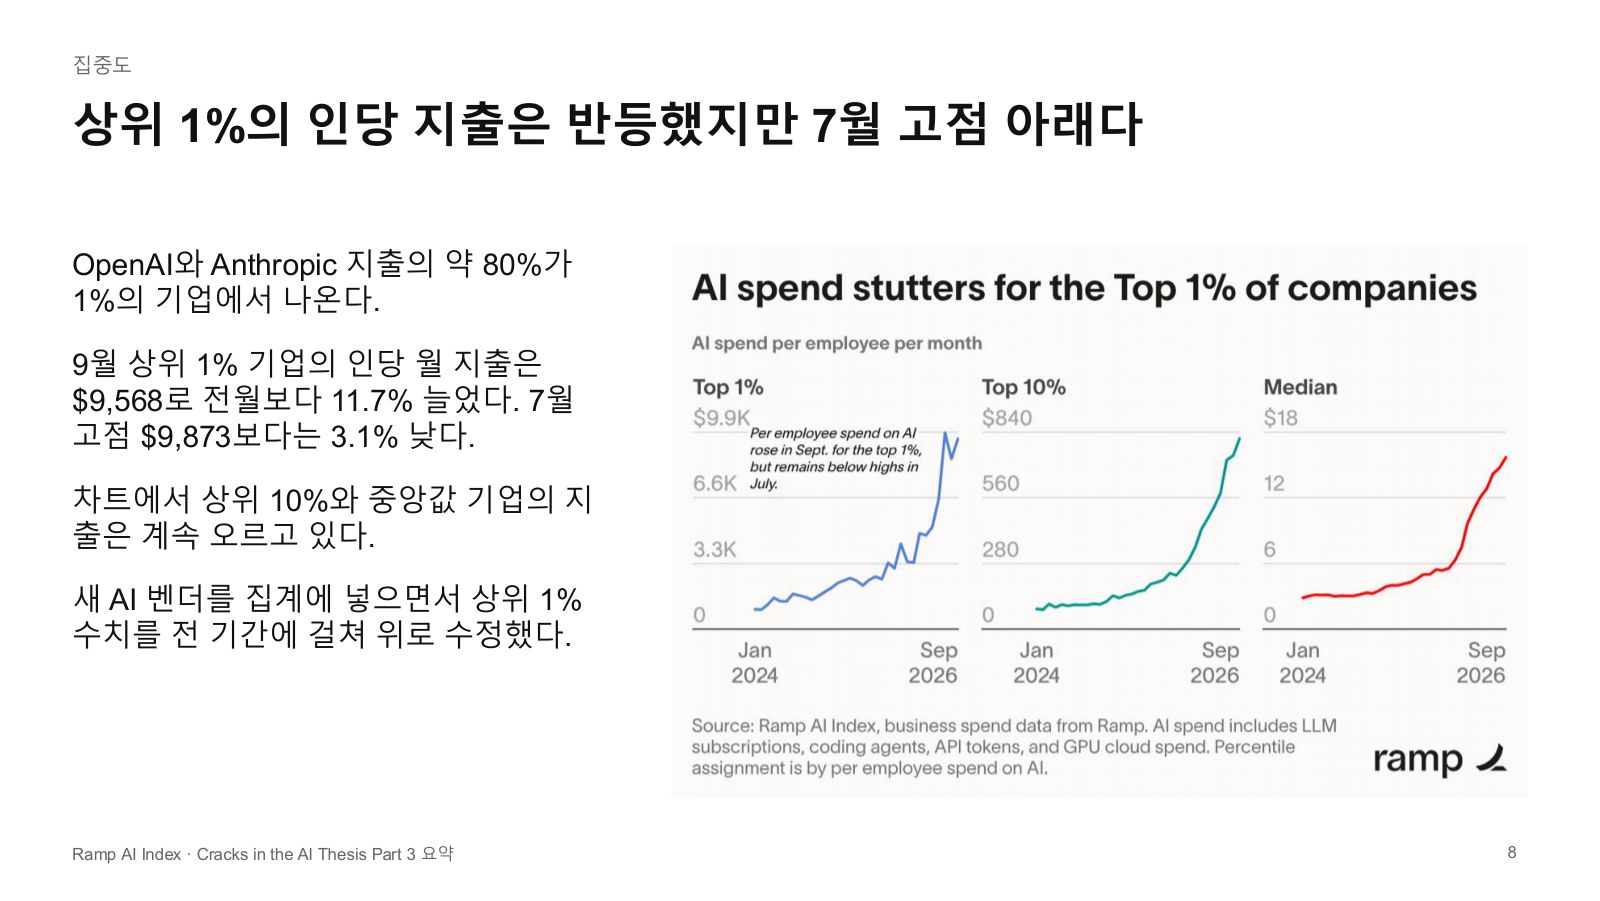
私が時間差を感じるのは、このグラフです。月ごとの支出を示したものです。いちばん左の青いグラフが上位1%の企業の従業員一人当たりの支出、per employeeexpenditureのことです。一人当たりの支出で、中央は上位10%の支出、そして赤がmedian、中央値です。順に並べたときの真ん中の値です。この差を見ると、
チェ・スンジュン ものすごいですね。
ロ・ジョンソク 上位1%は一人当たり約1万ドル使っています。1,000万ウォンを超えるということです。もちろん、これはinferenceとtrainingをすべて合わせた額です。
そして上位1%の企業の支出が全体の支出の80%を占めます。パレートの法則どころではありません。20対80ではなく、上位1%の企業が費用の80%を負担しているんです。
そして、その大半がまだ収益モデルを見つけていない企業なのも事実です。ほとんどがベンチャーキャピタルから出資を受けた企業で、よく聞きますよね、どこが何billion調達したとか。それは生産性の分野だけでなく、neolabからbiology、バイオテクノロジーの分野にも多いですよね。そういう企業は今、まさに大航海時代なんです。大量のcomputeを投入して金を探すか、新大陸を発見するという使命を抱えて、ものすごい量のtokenを使っています。
それから、先ほど見たように、支出は増え続けるでしょう。一方でtokenの単価は下がります。だからtokenの使用量は増え続けると考えるのが自然で、「使う人はもうみんな使った」とは思いません。
パク・ジョンヒョン 規模で見ると、上位1%の企業の一人当たりの支出は月1万ドルで、年換算すると年収1億5,000万~2億ウォンほどの人を雇うのと同じ額を、一人当たり追加でAIに使っているわけですよね。そうなると、自分の年収より自分が使っているAIのtoken代のほうが高い人もいるのかな?そんなことも考えてしまいます。
ロ・ジョンソク そういう人はきっといるんじゃないですか?私の周りにも、月200ドルのプランを10個以上全部使っている人がいます。でも、そういうことを一通り試すと、ちょうどいいところが見えてくるようです。実際、多くの企業がagentに「あれをやって、これをやって」と指示して会社を回せるようなenterprise packageを作っていて、そういう例は非常に多いんです。私たちの会社もそうですし、ほかの先進的な企業もすでに作っていて、どうすればAIだけで会社を回せるかについて、答えはかなり出ています。
token maxxingの限界とloop engineerへと変わるエンジニア 44:15
ロ・ジョンソク でも、そこまでやってみて分かることがあります。slopがものすごく大量に生まれるんです。コードが10万行できれば、テストも10万行できて、ごく簡単なものを一つリリースしようとしても、回帰テストを実行するのに1時間かかります。そこで、そのslopを減らそうと「削って」と言っても、私が作った個人用packageでさえ、「これ以上削れるものはありません」と返すんです。テストがびっしり積み重なり、互いに絡み合ってしまったわけです。作り直すしか方法がなくて、実際に作り直すことも多いのですが、なぜこの話をするかというと、token maxxingの行き着く先を多くの人が見たからです。
そこから次の段階に進むには、すべてを完全にAIの自律に任せるのではなく、途中で管理したり、意思決定したりできる別のエンジニアが必要だと分かったんです。だから、再びエンジニアの時代が始まるのだろうと、私は個人的に考えています。すべてのAIを人が管理しながら進めるのは難しいところもあるので。エンジニア3人がチームを組んでAIを使うと、1人で使う場合より生産性が3倍、4倍どころか10倍になるそんな場面があるんです。コーディングの時代が終わったのは確かですが、エンジニアの時代はまだ続いていて、エンジニアの定義も、今やPMやデザイナーなど職種ごとにできることを分けるのではなく、私たち全員が問題を解決するloopを閉じるloop architectであり、loop engineerになるのだと思うんです。実際、うちの会社もそういう方向に組織構造が大きく変わってきています。
そして、その体制が再び定着すると、またトークン使用量が増えます。なぜなら、そこで作られたengineering assetがほかの人にも広がるからです。このグラフのように、会社の中にもmedianの値があるんです。全員がAIを使いこなしているわけではありません。使いこなす人が1、2人いても、反対側には使わない人もいます。中央値で見ると、まだ大半の会社ではAIの導入がほとんど進んでいません。チャットをする程度ですが、先行する人たちがこの水準を引き上げると、後から続く人たちのトークン使用量も大きく増えます。なぜなら、先行する人たちが後に続く人たちのcontextをすべて整えているからです。
そういう変化が起きていると感じるので、あとは時間の問題で、使用量は増え続けると思います。上位1%はこう、上位10%はこう、中央値はこう、という数字は今の時間差を示していますが、1四半期、2四半期、3四半期と経てば、この中央値はぐっと上がると思います。結論として、先ほどスンジュンさんがおっしゃったASIに関しても、こうした時間差は縮まり続けているように感じます。
ただ、AIとharnessにはできない人間の新たなエンジニアリング領域も生まれているので、かつて「コーディングとは何か」を論じたように、エンジニアという職種が再定義される時が来る気がします。そして、人間の仕事もまた生まれてくると思います。スンジュンさんのお話に続けて、私が今週見た興味深いデータについては、ここまでにします。
チェ・スンジュン Rampは今回初めて知りました。
ロ・ジョンソク ええ、ベイエリアですごく勢いのある会社です。
パク・ジョンヒョン AI関連のポッドキャストを見ていると、必ず「Sponsored by Ramp」が入っています。TBPNなどもそうです。
ロ・ジョンソク Rampマフィアがいるんですよ。Rampは社内文化などがいいんでしょうね。だから投資家はRamp出身の創業者をとても好みます。では、ジョンヒョンさんのセッションに移りましょうか。
モデルのweightを直接書き換えるweight-space programmingの実験 48:40
チェ・スンジュン 実際に面白いことを試したと聞きました。
パク・ジョンヒョン まず、今週私が試したのは、weight-space programmingです。先週、一度お話ししましたよね。モデルのweightを学習アルゴリズム、backpropagationで変えるのではなく、本当に手術するように変えられるのか。そんな実験をしてみました。
試したのは、それ自体に興味があり、本当にうまくいくのかも気になったからです。今週Fableが出たので、Fableでもうまくいくのか?そんなことも気になりました。
それからRSIやトークン使用量についてもお話がありましたが、こうした実験は以前ならものすごく時間がかかる作業だったはずです。それもトークンを使えば、私も自宅で寝ている間に、数回クリックして研究らしきことを試し、疑問を解消できました。
チェ・スンジュン 大学院生の頃にやるとしたら、どれくらいかかったと思いますか?
パク・ジョンヒョン 大学院生の頃の私には無理でしたね。仮に計算してみると、モデルをinferenceできる環境を整えて、モデルの中身をすべて調べられる環境も整えて、それから実際に動かしながら、内部の数値を確認できる画面も用意して、それを修正するコードも書く必要があります。本当に無理だったと思います。6か月くらいかかったでしょうか。
チェ・スンジュン それを寝転びながらやったんですね。
パク・ジョンヒョン 寝る前に一度動かしておいて、契約プランの利用枠を使い切ったら、枠が回復するまで待って、また動かす。そうやって2日かけました。ほかの仕事をしながらです。
チェ・スンジュン この可視化も、操作できる3Dなんですか?
パク・ジョンヒョン はい。これは画像ですが、下にあります。こうやって回して見られます。これはaifrontier.krで私が公開しているので、どなたでもアクセスしてご覧いただけます。では、始めます。Weight-space programming.
先週少し話しましたが、これが何か簡単に説明すると、1~2週間ほど前にXで大きな話題になった研究です。研究がこれほど話題になるのは、かなり久しぶりだった気がします。MITから出た論文で、Astraを使って、Qwen 0.8Bでしたっけ?とても小さなモデルを手術したんです。Qwenにもともと数学の問題を解かせるとあまり解けないのですが、ごくわずか、0.061%のweightを直接修正したら、数学の成績が一気に上がったんです。これが元の論文です。それで「自分もこうしてみたい、ああしてみたい」「本当にできるのか?」と、そんな雰囲気で広まっていきました。それで私も試してみました。
ただ、一番気になるのは、モデルになかった能力は加えられなかった、という点です。この話は今も議論されています。最初にRLが登場したときも、GRPOをするときも、pre-trainingで学習した内容があって、引き出しているのか、それとも新たな能力まで生まれるのか、そんな話をしましたが、ここでも同様に、能力を引き出すだけで、なかった知識が新たに生まれるわけではなさそうだ、というのが今のところの結論だと思います。
私は知識を入れる実験をしてみました。次に、知識ではなく画像でも試しました。本当は最終的に動画でやりたいのですが、まずは画像でやるのと似ていますから。数学はverifiableですが、こちらはverifiableではないので、画風を自動で調整したりできるのか気になって、この2つを試しました。
三国志ベンチマークに見る知識注入の効果と限界 52:17
パク・ジョンヒョン 一つ目は、私がいつも使う独自のベンチマークです。三国志ベンチマークといって、資料を集めて作っておいたものがあります。三国志のクイズを出して、正解できるか試すんです。意外と正解できません。全部答えられそうなのに、苦手なんです。
理由を推測すると、データ全体の中では、これがそれほど価値のあるデータと見なされていないようですし、韓国語と中国語にも違いがあるようですし、小説の『三国志演義』と正史に書かれた内容も違うようですし、いろいろな要因があって、LLMはこういう問題が苦手なんです。それで私はいつもこれを使うのですが、Qwen 0.8Bに解かせたら正答率はわずか3%で、9Bに解かせたら14%ほどでした。そこで、これを使ってAstraとFableにモデルの手術を指示したんです。
チェ・スンジュン 2つ渡したのには理由があるんですか?モデルを2つ渡した理由です。
パク・ジョンヒョン 0.8Bはベンチマークを変えても再現できるか、数学だけでなく三国志でもできるか試したくて。次の9Bは、私が個人で持っているGPUで無理なく動かせる範囲で、ある程度大きなサイズにして、できるだけ大きいモデルを試しました。どのくらいの大きさまでできるか知りたかったので。
ロ・ジョンソク 本当に脳の手術ですね。weightを変えるわけですから。
パク・ジョンヒョン 脳の手術をさせたんです。まず、これが脳です。Qwen 0.8Bです。FableはQwen 0.8Bの実際のweightを、ここでこれだけ変えたんです。第19層を変えて、Astraは最後の第23層を変えていました。
それで、変えた結果どうなったかというと、問題を200問抽出して解きながら、どのニューロンが活性化するかなどを見て、変えていたんです。その問題の95%に正解できるように変えました。Astraはなんと100%正解できるようにしました。脳に知識を埋め込むことはできたわけです。
それから、これは私が指示していないのに、自分で実験していたんです。同じ問題の類題を自分で作って解いていました。類題も解けるか見たら、よく解けていましたが、完璧ではありませんでした。性能は上がりましたけどね。
つまり、問題を一字一句違えずに覚えるのは非常に得意でも、言い回しを少し変えるだけでその知識をうまく応用できなかったんです。ある程度は応用できた、ということです。次に、まったく見せていない三国志の問題でどれだけ正解が増えたかというと、あまり増えませんでした。つまり、見せて覚え込ませた内容への手術は狙った対象にだけ効いたんです。
それに、一般常識についても、扇風機の値段はだいたい10万ウォン以下?それとも1億ウォン以上?そう聞かれたら、10万ウォン以下と答えるのが妥当ですよね。そういう質問では、常識を少し忘れてしまうんです。これは、私たちがfine-tuningをすると起きる現象とほとんど同じです。
チェ・スンジュン backpropなしでSFTをしたと言えるわけですね。
パク・ジョンヒョン そうですね。fine-tuningの新しい方法というより、以前はうまくできなかった手法を一つ見つけた、そう捉えればいいと思います。
ですから、fine-tuningを超える何かが起きているわけではなさそうだと、この実験から推測できると思います。
それから興味深いのは、一つずつ詳しく見ていくと、私が出した質問はこんなものなんです。夏侯惇と劉備が戦った戦いで、諸葛亮の命令に従って、敵にわざと負ける役目を担った武将の名前は?正解は趙雲で、それを当てる必要があるんです。
チェ・スンジュン 難しいですね。
パク・ジョンヒョン 難しい問題ばかり集めたんです。これを解くとき、どこがどう変わったかを見ると、ニューロンが一つ、ぽんと変わるんです。そして問題ごとに、特に変化するニューロンが一つずつあるんです。そこでモデルは「こういうニューロン一つがある記憶を担っているんだな。こういう知識の記憶を担っているんだな」と推論して、それに合わせて修正しているようでした。
こうしていろいろな質問をすると、モデルがどう動くかを見ることはできますが、私たちが見ても、なかなか理解できませんよね。でも、人間には理解できなくても、LLMなら理解できるかもしれない。そう思い始めるわけです。
ロ・ジョンソク そのケースをいくつか実験してみれば、パターンを見つけられそうですね。この後のharnessに関連して、weightがどう変動するのか、その値をすべて監視するわけですよね。そして実験しながら、決定的なニューロンを見つけるためにいろいろな実験をするわけです。
チェ・スンジュン 基本的にモデルはBase64でpromptingしても全部理解するので、数字のパターンは本当によく分かるんですよね。
パク・ジョンヒョン はい、こうしてモデルの元々どこが重要で、どう変わったかを見ることができますが、ただ、私にも理解できるものではないので、視覚的になら理解できるかもしれないと思って作ってみたんです。面白いのは、二つのモデルで変える場所が違ったことです。
チェ・スンジュン layerが違うということですね。
ロ・ジョンソク それでも、かなりoutputに近い層を選ぶんですね。
パク・ジョンヒョン 前のほうは選ばず、後ろのほうを選んでいました。これは私が自由度を与えて、自分で判断するよう指示したのでそうなったんですが、どの層を直すか指示すれば、そのとおりにすると思います。何を見てどう修正したかもすべて記録に残していて、それを見たんですが、見ても理解できませんでした。
チェ・スンジュン 私も最近はいつもそうです。やってはいるけど、理解はできません。
画像モデルに反映させた李仲燮の画風 57:58
パク・ジョンヒョン それから次は、絵を、絵を修正する実験をしました。今回はQwen LLMではなく、このモデルはMiniMax H3画像モデルです。登場して間もないモデルなので、この特定のモデルについてはLLMもおそらくよく知らないはずです。その状態で、こんなことをさせてみました。
先に結果を見ると、私が指示したのは、李仲燮(イ・ジュンソプ)の作風で画像を生成できるよう自分の脳を修正してみろ、weight-spaceprogrammingをしてみろ、ということです。元の画像モデルに雄牛を描けと言うと、わざと水墨画風に描けというプロンプトを与えたんです。すると、雄牛をこのように描きます。でも、李仲燮(イ・ジュンソプ)風に描けと言うと、こう描きます。二枚目のように。ただ、李仲燮(イ・ジュンソプ)風にとだけ言っても、このモデルには「その作風は何?」という疑問が生じるので、Fableが自分でプロンプトを修正するんです。李仲燮(イ・ジュンソプ)の絵を調べて、この人はこういうふうに描くのか、と。そこで線の使い方など、特徴を文章にして指示すると、三枚目のようになります。
ここまではモデルに手を加えずに再現した場合で、再現できるのはこの程度ですが、普通はfine-tuningをすることになりますよね。こういう作風を与えて。fine-tuningの代わりにFableにweight-space programmingをして作らせると、このくらいになります。Astraにさせると、このくらいになります。つまり絵だけを見ると、私の感覚では、私は絵に詳しくありませんが、Astraが作ったもののほうが、それらしく感じます。前の画像はどれも油絵のように絵の具を塗ったような描き方で、西洋風の印象ですが、Astraが編集したものは東洋画のような線を使う画風になっていると感じます。これは私の定性的な評価です。
この過程も見ることができました。これが修正前です。ここからは各回で修正するweightが見られ、修正に応じて作風がどう変わるかも分かります。これはFableですね。ここを直して、描いて、評価して、次は別の場所を直そう、と。別の場所を直して評価して、という具合です。
チェ・スンジュン 今はほとんどVAEをいじっているんですよね?
パク・ジョンヒョン いいえ。ここではテキストをprojectionする部分を直していましたね、Fableは。Fableはここだけ直したんですね。一方、Astraを最初から見ると……同じ場所を直してみて、うまくいかないと別の場所も直してみて、さらに前のほうも直してみて……Transformerの内部にも手を加えています。こうしてあちこちを直しながら、自分なりに評価して進めていました。最後まで試す様子を見られたんですが、これは私の試験的な実験で、24時間もかけていないので、結果はこの程度でしたが、これをもっと高度化して試せば、どこまで行けるのか。そこが気になります。
結局、このoutputを見てニューロンの内部を解釈する能力がモデルにもある程度あるんだな、と。そういうことが分かりました。さらに活用するには、作風なら絵を見て、本当に作風が似ているか、望んだ結果かをモデルが評価できる必要がありますよね。ある意味、これは美的感覚、あるいはvisual understandingと考えられると思いますが、その点では、今のLLMを拡張したVLMもそこまで優れていないように思います。そうした能力が発達すれば、これも進歩するだろうと思います。
ロ・ジョンソク 10年前なら論文になっていたものが、今やコーディングハーネスを使って、数クリックで試せるんですね。スンジュンさんも肩書きをメディアアーティストからニューラルアーティストかAIアーティストに変えたほうがよさそうです。
チェ・スンジュン どうでしょうね。
パク・ジョンヒョン 詳しいことはここに全部書いたんですが、実験は私が自分で進めたものの、内容の整理などは、今週はFable 5.2を試すのが目的だったので、Fable 5.2に書かせました。普段はこういう文章を書くたびに必ず推敲して、自分好みに直すんです。でも今回は、あまり手を入れなかった気がします。
この実験には、そもそもFableを使ってみる目的もあったんですが、Fableはそれだけでなく、文章を書く力もかなり向上したと個人的に感じました。
次に、この実験から学んだことを挙げると、暗記させることはできる。暗記させたいところにweight-space programmingを使ってみたいと思いますし、将来はもっとよくなるかもしれず、楽しみです。
どこをどれだけ直すかより、何を直すべきか分かることが大きな違いを生むんですが、それは人間にはほとんどできなかったことでも、LLMにはできるので、これも期待しています。
それから、どの層を直すかによっても大きく変わりました。
チェ・スンジュン つまり、これはディープラーニングの研究ですよね。AIがAIを研究しているんです。暗記の話が出たので言いますが、今週はAIメガネも話題でしたよね。これから試験はどうあるべきか。
AIメガネを使った不正行為と見直しが必要な試験制度 63:03
ロ・ジョンソク 認めたという話がありましたよね。受験生の一人がAIメガネを使ったと認めた記事を、収録の直前にどこかで見ました。
チェ・スンジュン 税務の試験ですか?
ロ・ジョンソク はい、税務の試験です。
パク・ジョンヒョン 自分から申し出たんですか?
ロ・ジョンソク 私も詳しくは分かりません。ちょうど収録を始める前にちらっと見ただけなんです。
チェ・スンジュン 今度の木曜日でしたっけ?大学修学能力試験ですよね。皆さん、いろいろ考えているようです。これがどんな方向に進むのか。試験を変えるべきなのか。
パク・ジョンヒョン 試験が……矛と盾の関係だと考えると、試験を変えるのも簡単ではなさそうですが。あらゆる制度も変わらざるを得ない、そんな時が来たようですね。
チェ・スンジュン でも、メガネのように日常的に身につけられる形になるなら、着けたまま何をすべきかと論じる方もいますし、あり得ないと言う方もいて、意見はさまざまですね。
ロ・ジョンソク 10年から50年かけて起こるはずの変化が今はわずか1、2年で押し寄せているので、私たちも進みながら学ぶしかないですね。
weight-space programmingとcontinual learningの可能性 64:12
パク・ジョンヒョン 話したかったことと、出そうとしていた結論が、自分では気づかなかったんですが、今聞くと同じ道筋にある気がします。というのも、weight-spaceprogrammingを見て、面白いな、本当にできるのか、と思ったんです。さらに考えると、長年の課題とされ、Dwarkeshが特によく指摘していたcontinual learningへの道につながるかもしれないと思ったんです。
というのも、やり取りを続けながらweightを更新するのはコストが高く難しいので、うまくできていません。そんな中、weightを更新する新しい方法が見つかったかのような成果が出始めたんです。これが本当に効率よくできるなら、私たちは日々、情報を受け取るたびに脳が更新されるのに、このモデルはなかなか更新されませんよね。会話で得た情報では。
ですから、その方向でweightのcontinual learningへの突破口として、まずは可能性を念頭に置いて注目する価値のある候補だと思っています。普段身につける装備の話がありましたが、私とつながったLLMを動かすと考えると、見たものからcontinual learningするその前段階もつながりそうだと、ふと思いました。お話を聞いて。
チェ・スンジュン そのうち脳をプログラミングする話になりそうですね。
パク・ジョンヒョン まさにNeuralinkが。ええ。
ロ・ジョンソク 今朝もStarshipがふわりと着陸したじゃないですか。
チェ・スンジュン そうなんですか? それは見ていませんでした。
ロ・ジョンソク 推進体の上にStarshipを載せて打ち上げたんですが、下にあるのがHeavyですよね。Heavyは降下中、海上で少し爆発しました。そちらは失敗でしたが、上のStarshipはしばらく回って、一日ほど上空にいたあと、再び降りてきて、今朝、アームで見事にキャッチしたんです。
それで私も朝起きてすぐにその映像を何十回も見返したんですが、現地で見た人は本当に鳥肌が立ったでしょうね。
チェ・スンジュン どうして何十回も見返したんですか?
ロ・ジョンソク 面白いじゃないですか。私には芸能人のコンサートのようなものなんです。わあ、こんなことができるなんて。できるなんて。でも、見てください。何十回もとは言わなくても、何回かは見返したくなる感動があります。スンジュンさん、見せたいものがあるそうなので、少し見せてください。
ニューラルネットワークに組み込んだcompilerとMuJoCo RLの実験 66:24
チェ・スンジュン 私のも長いものではなく、クリック一つで作ったものです。ジョンヒョンさんがweight-space programmingで面白いことをされていたとき、私はQwenputerに似たものを試して楽しんでいました。それで、これも私はshaderのようなものを作るのが好きなので、shading languageや音を使った実験をweightを使い、ReLUnetworkでやったんです。
その次にFableへの最初のプロンプトで挑戦したのは、lambda calculusとBytebeatというdomain-specific language、それにshader codeの三つをweightに焼き込んで、その状態ではbytecodeが入力になります。さらに、そのbytecodeを作るcompilerまで作らせてみました。できるかな、と。朝起きたら、できていたんです。できたものを見てみると、大したことではないと思いました。機械的な作業なんです。ReLU networkに変えるんです。決定論的なコードをnetworkに変えるのは、実は自明なので、人間には到底できなくても、機械はできるんですね。それで、networkの中にcompilerまで作ったんです。
それに、dotならAstraを無料で使えますから。以前はこういう実験をRLなどでやるのは難しかったんです。でも今はdotの中でこういうことをやっています。もちろんGPUではなく、CPUで動かしていますが。containerがCPUなので。もっと上手くやるように言ったら、面白いことに、すでに学習済みのモデルがあるんです。MicroDuckが上手く作っていたんです。そこで、そのweightを持ってきて……MuJoCo 4が出たんですよ。MuJoCo 4で動かしました。
つまりcontainerの中にMuJoCo 4をインストールして、RL実験をし、auto researchで改善するのを私は寝転がったままやっていました。
パク・ジョンヒョン でもdotのcontainerの中でMuJoCoが動くんですね?それは驚きですね。
チェ・スンジュン これはreal-timeではありません。録画した映像です。でもMuJoCoのrendererを動かすことはできると思います。GoogleのFilamentを組み込めますから。とにかく、そんな感じです。
ロ・ジョンソク 何でもcomputeを投入して最適化すれば済む問題になりそうですね。
チェ・スンジュン そうなんです。ああいうことは難しいですから。
ロ・ジョンソク 実際、
チェ・スンジュン ジョンヒョンさんが見せてくれたものも。
家を一晩でシミュレーションに移したreal-to-sim 68:38
パク・ジョンヒョン はい。まだお見せしていませんが、今週はほかにも実験していて、Fableが出たので、いろいろ試しました。私も似たようなことをやってみたんです。
何をしたかというと、real-to-simです。似たようなものですが、自宅をスマホで隅々まで撮影して、それを基にBlenderで3D simulation環境を、家全体を再現して、そこにロボットを入れて、家の中を動き回らせたりしました。
家具を入れ替えたりもして。
チェ・スンジュン できたんですか?
パク・ジョンヒョン やってみたら、驚くほど上手くできたんです。それも一晩でできました。real-to-simはもともと難しい問題でしたが、これもAIが自分でシミュレーターを動かし、フィードバックを受けて、映像と比較しながら進めたんです。
チェ・スンジュン つまり、測定できるものなら何でもできそうです。Opus 5.5が出てから、頼んでできなかったことがありません。もっと野心的なことを頼めていないだけでしょうけど。普段、私が直面している問題は簡単なものだったんだなと、最近よく思います。
価値を生む手段となったRL environmentと新たな仕事 69:32
ロ・ジョンソク 今、スンジュンさんが大事なことをおっしゃいましたが、それがRL environmentなんです。私たちの会社でも、付加価値はどこに生まれるのかという点で、改善したい問題があると、その多くは一部の人の洞察や解釈に頼ることになります。そして、そういう仕事に就く人たちを専門職と呼ぶわけです。
ところが、それを解釈できるようにし、verifierを動かせる環境、その環境まではモデルが一度で作ってくれません。どんなにシンプルな会社でも複雑だからです。在庫が切れたり、人から不満が出たりすると、そうしたことがすべて複雑に絡み合い、さらに、その間には人の反応なども入ってくるので、複雑なんです。だから結局、人を雇って任せるのがいつも楽だったんです。
でも私は今、社内にRL environmentを作っています。あらゆるfunctionについてです。そして、人がすることをそのenvironmentの中に蓄積されるように試しているところです。最近は、そのenvironmentを作ること自体が価値の創出なんだと思っています。
チェ・スンジュン 面白いことに、Dwarkeshがポッドキャストでまさにその話をしていました。今回のエピソードで。今後は、この方向でRL environmentを作る実験をagentが爆発的に増やせるようになるだろう、という話です。Hill climbingがどんどん進んでいくと。
ロ・ジョンソク AIにできる仕事については、みんな少しずつイメージは違いますが、どれも実現できます。知的労働のほとんどはその中に入るでしょうから、社会への影響は計り知れません。そうなると、優秀な人たちにどんな新しい仕事を用意すべきか、今から考える必要があると思います。
チェ・スンジュン でも、一寸先は分かりません。
ロボット花屋と現実空間のRLデータセット 71:27
ロ・ジョンソク ジョンヒョンさんが以前、私に話していたことで、花屋をやりたいと言っていたことがあるんです。
チェ・スンジュン そうなんですか?
パク・ジョンヒョン ロボットで花屋をやろうと思って。
ロ・ジョンソク でも、それもRL environmentにしていけば、私は韓国中のあらゆるphysical spaceがすべてRL environmentになり得ると思うんです。人間はそのdatasetを早くAIに学習させて、そのdatasetを全部買い取ってもらう。
それが新しい仕事になって、「ロボット、AI、これはできないだろう?」と言いながら、人間は絶えず、人間らしい新しいことを切り開いていくべきではないでしょうか。
Dataset generationは、今はAfterQueryやMercorなど、そうした会社が独占している分野ですが、私たち一般の人も参入すべきなのではないかと、少し思っています。
Anthropic IPOとジェンスン・フアン復帰の行方、来週の注目点 72:17
チェ・スンジュン そうですね。来週また見てみましょう。19日にAnthropicはIPOをうまく進められるか。どうなるか。ジェンスンはどうなるか。
ロ・ジョンソク ジェンスンが復権して、復帰するなら、今週中にそれが起こるべきだと思うんです。だから来週もジェンスンがCEOを退いたままなのか、それとも復帰するのかも、大きな注目点です。
パク・ジョンヒョン 来週も今週に引き続き、いろいろなことが起こりそうですね。
チェ・スンジュン OpenAIもじゃんけんしないとね。
ロ・ジョンソク 私たちはいつも収録の一、二日前に内容を決めますよね。それまでに予想外のことがたくさん起こるので。
チェ・スンジュン 正直に言えば、当日の朝までですよね。
ロ・ジョンソク それが正解ですね。来週もまた、やることがありそうです。それでは、いいお話をありがとうございました。来週も探究していきましょう。
チェ・スンジュン はい、お疲れさまでした。
ロ・ジョンソク はい、ありがとうございます。
パク・ジョンヒョン ありがとうございます。