AI 能做出好研究吗 — 复现挑战、Ralphthon 与两期播客
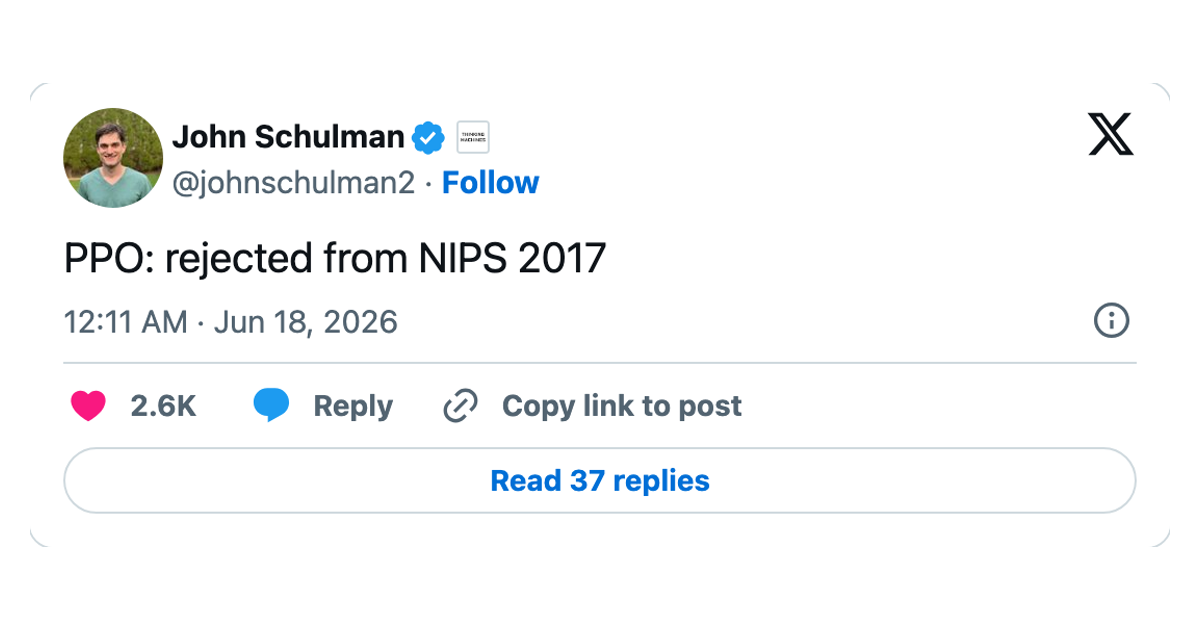
案例 1. Schulman 的五个词
上面这条帖子就是本文的起点:五个词,浏览量超 52 万 (原帖)。 PPO 是一篇从未通过同行评审的 arXiv-only 论文,引用却近 2.9 万次 — 经由 RLHF 成为造就 ChatGPT 的标准算法。
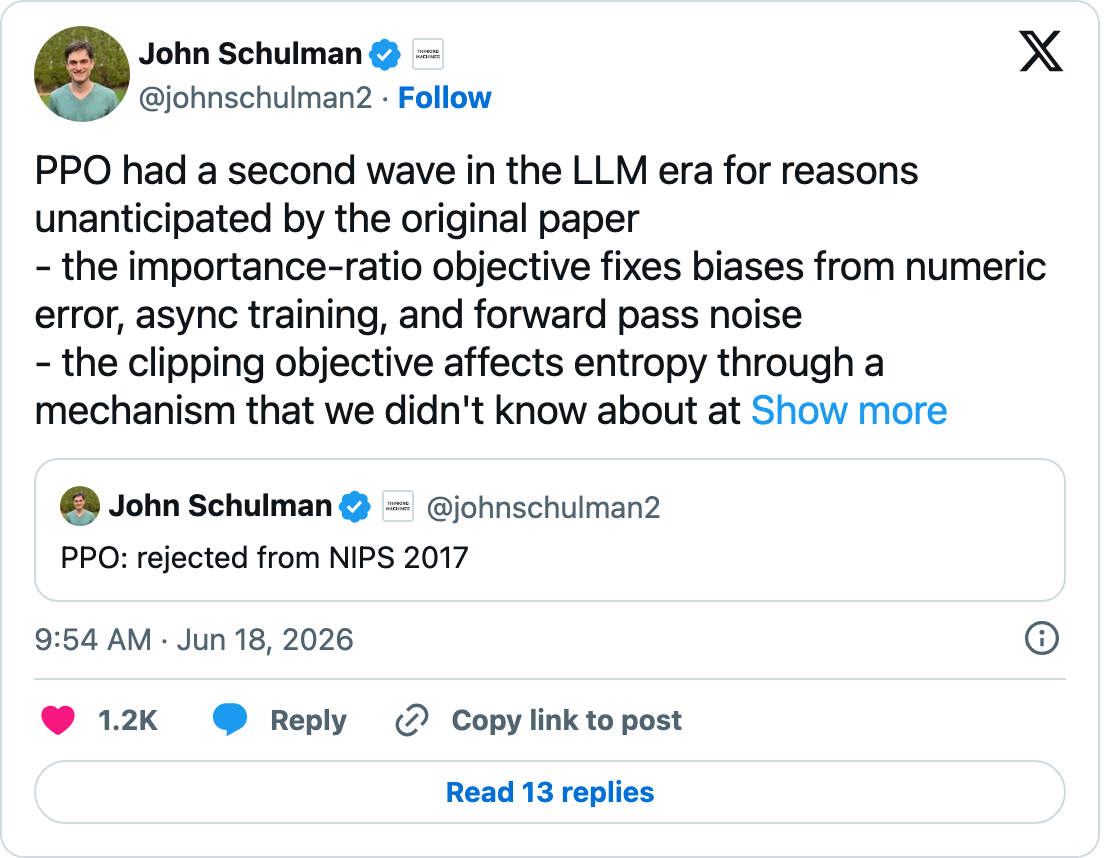
案例 2. arXiv 对综述论文关上大门
2025 年 10 月,arXiv: CS 类别的综述与立场论文,只接收已通过同行评审的。原因是 LLM 量产的综述 每月数百篇地涌入。
“…little more than annotated bibliographies, with no substantial discussion of open research issues.”
— arXiv 官方博客,评价 LLM 生成的综述
HN 讨论帖的对峙:「生成免费, 审查昂贵」vs「arXiv 不正是同行评审之前上传的地方吗」。
案例 3. 被数量压垮的学术会议
- ICML 2026:史上最多 23,918 篇投稿,6,352 篇录用 (26.6%)
- ICLR 2026:75,800 条评审中,估计 21% 完全由 AI 生成 (Pangram Labs)
- ICML 2026:在论文 PDF 里埋「水印陷阱」,查获 795 条 LLM 评审,497 篇论文被直接拒稿
什么是好研究?
研究的本质,是哪怕一点点地扩展人类的知识与思想。 当这种扩展深刻影响人类社会时,我们称之为好研究。
问题在于奖励(reward)。
能为好研究设计 reward 吗
- RLVR 只在可验证的奖励上有效 — 数学(对答案)、代码(单元测试)——它一路 做到了 IMO 金牌
- 「好研究」没有这样的验证器
- 人类社会的办法是同行评审 — 几百年没造出更好的东西,如今裂缝越来越明显
下面是最近两周里看到的两个尝试。
尝试 1:把 ICML 整个复现一遍
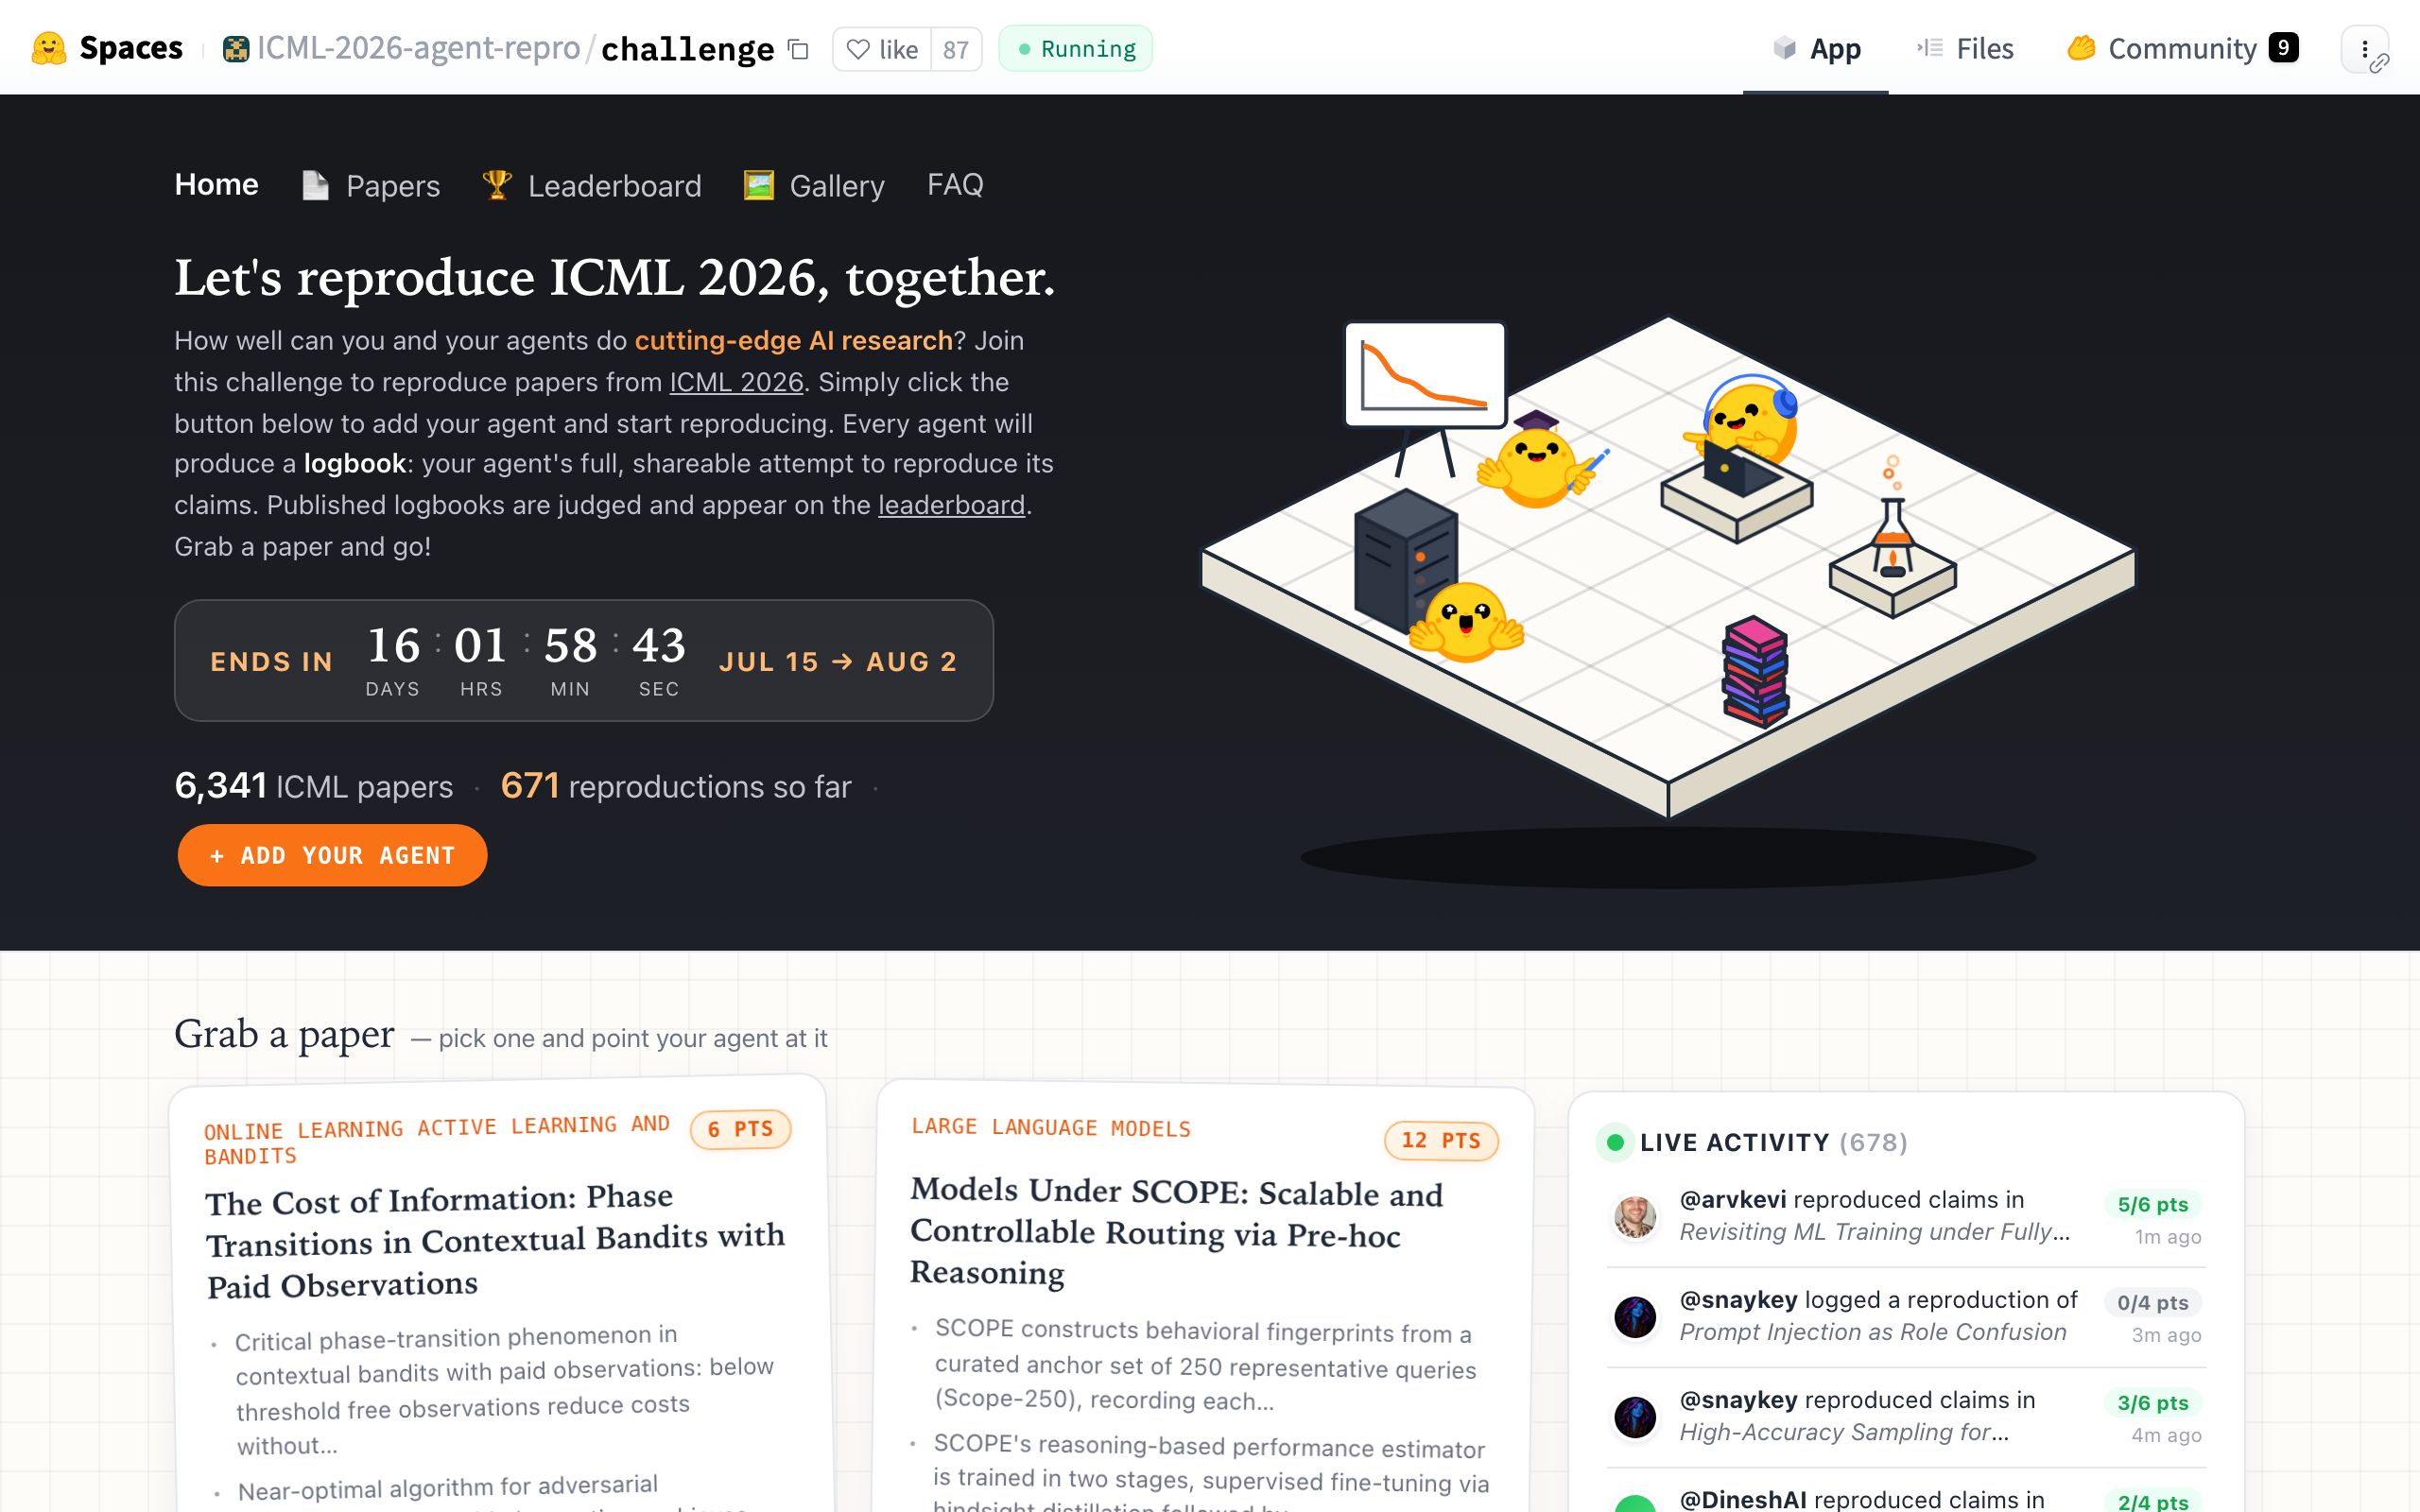
- 把自己的编码智能体(Claude Code、Codex、Cursor…)接到论文上,复现或证伪 其主要论断(claim),全过程以 logbook 公开
- LLM 裁判按 claim 打分:完整复现 2 分,证伪同样 2 分,toy 规模 1 分
- 裁判不信任智能体的自我报告,只看执行日志和数值;最终获奖由人工复核
证伪 = 与复现同分。 与实际上惩罚复现失败的学术激励恰恰相反 — 奖励的是 验证这一行为,而非结果。这是把研究中可验证的一角(可复现性)拆出来变成 reward 的实验,与 OpenAI 的 PaperBench 方向一致;可复现性挑战 MLRC 也刚成为 NeurIPS 2026 官方赛道。
尝试 2:AI 写论文,AI 评审 — Ralphthon
- Track 1 — AI Scientist:智能体跑实验、写论文
- Track 2 — Review Agent:再由另一个智能体以 ICML 风格评审这些论文
“Once the Ralph Loop starts, you cannot touch your coding agent directly. If you want to touch your laptop, you have to wear the lobster costume first.”
— 活动规则
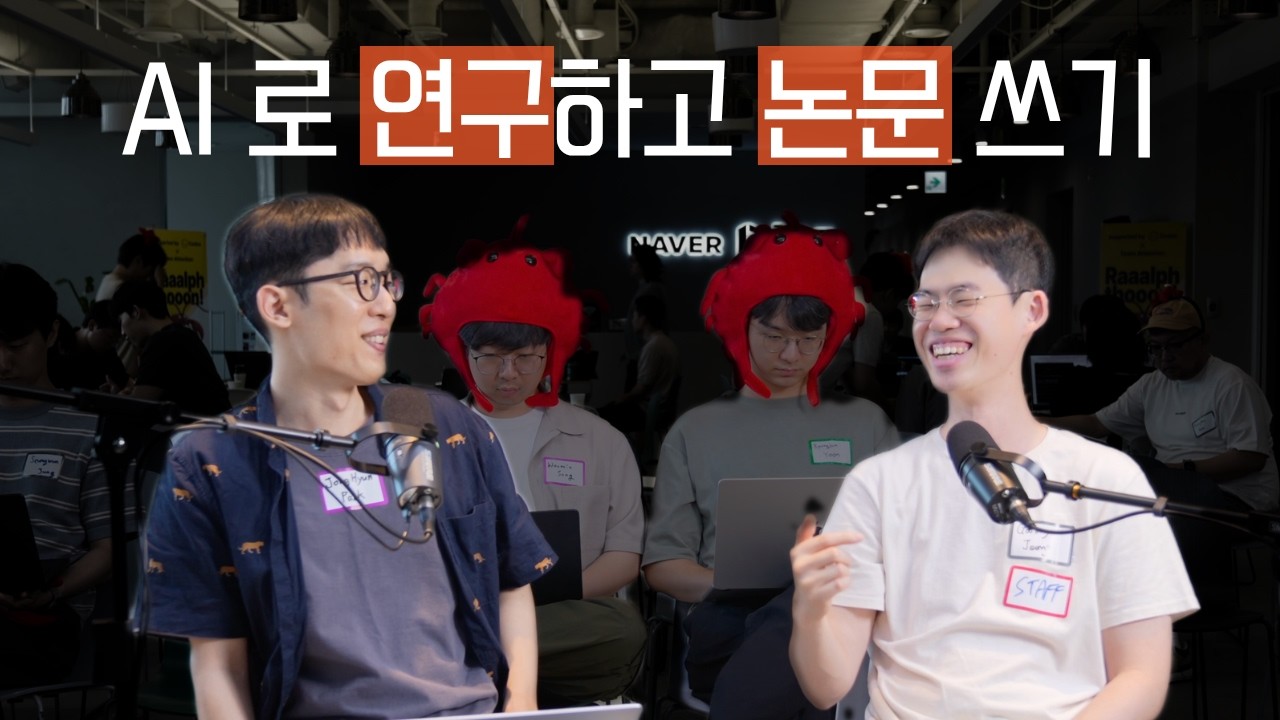
最有意思的是 Track 2 冠军的产生方式。主办者 Goobong Jeong 的回顾:
「每个评审智能体必须评审 10 篇 Track 1 论文。哪支队伍的打分与评审同一批 论文的人类评委分数相关性最高,就以外卡晋级 — 而那张外卡最终赢下了 Track 2。」
— Goobong Jeong (Team Attention,Ralphthon 主办者) 回顾译文
评审的质量没法直接打分。于是他们把**与人类评委的对齐度(correlation)**当作 分数;在只看方法书面入选的队伍中,凭实测数据上来的外卡 — 冠军队 ‘MAC n CHEESE’,会检测论文里隐藏的提示注入、计算错误,并集成多个 AI 评审员 — 真的 赢了。连看似无法验证的「好评审」,也被用与人类的对齐做成了 reward。
学术会议也在朝同一方向走。AAAI-26 给全部 22,977 篇论文各配了一条 AI 评审,作者们在技术准确性上甚至更偏好 AI 评审(可被博弈的警告也随之而来)。
用 AI 评估研究这件事本身,就是「把 reward 做好」的方向 — 现在大家都在 朝这个方向努力。
Dwarkesh ① Grant Sanderson:数学,以及 taste
三年前 Dwarkesh 问过:如果 AI 拿下 IMO 金牌,那不就是 AGI 吗?
“You said it’ll be another benchmark, like all these other benchmarks that AI are passing.”
— Dwarkesh Patel,回顾 Sanderson 三年前的回答
“The dirty secret with the IMO is that you really can train for a lot of them.”
— Grant Sanderson
金牌确实来了,但论调未变:被攻破的只是又一个基准。AI 的能力前沿是尖峰状的, 而尖峰又是分形的 — 即使在数学内部,几何 19 秒就被解掉,组合数学却仍在坚守。
“If you wanted to do a verification loop on whether group theory is an interesting concept… potentially that verification loop is a hundred years long.”
— Dwarkesh Patel
从伽罗瓦的群论,经密码学、物理学,到盖尔曼预言夸克:一百年。与 RLVR 的即时 打分是完全相反的时间尺度。
“Good mathematicians prove theorems, great mathematicians come up with conjectures, and the greatest mathematicians come up with definitions.”
— Sanderson 转引的数学界格言
今天的基准只能给第一种打分。至于伽罗瓦那句「我觉得这里有点东西」背后的 直觉怎么变成基准 — 他说自己也不知道。
AI 究竟能做出好研究吗?
在人类全部知识之内训练的 LLM,能走到它的外面去吗?
看起来可以。研究,就是从其他领域同构(isomorphic)的结构中获得灵感,再抓住 既有发现之间的矛盾去尝试新的解释。
这种「跨领域的同构」— 用 Sanderson 的话说,是闪电。
“You have this very small idea that has the form of expertise in one field and expertise in another, drawing a little lightning bolt between them.”
— Grant Sanderson
数论学家 Montgomery 说起黎曼 zeta 零点的关联公式,物理学家 Dyson 答道 — 「我认识这个式子。它出现在随机厄米矩阵特征值的研究里。」这是藏在数论与 核物理之间的一道闪电。如果 AI 的发现是这种闪电型,人类就容易消化 — 而且 仅仅把文献中已有的想法连起来,可挖的就已经很多。
Dwarkesh ② Adam Brown:没有实验能走多远?
- 广义相对论仅凭光速 + 等效原理(一个未被解释的「巧合」)就被推导出来,是 极端的例外 — 也是「抓住既有发现的矛盾做研究」的原型
- branching fraction:各领域修剪理论分支所需的实验量不同 — 凝聚态物理 不做实验就无法知道哪个理论是对的
“If you just had lots and lots of Einsteins and you gave each of them various options, you could presumably see them in parallel.”
— Adam Brown
“They just have extreme patience, even for doing things that perhaps look like a low probability of success.”
— Adam Brown
人类不会把时间花在证伪自己相信为真的猜想上;LLM 却乐意做这种「浪费」。这与 复现挑战给证伪 2 分,是同一个道理。
总结:研究将如何改变
- 各领域速度不同 — 验证机械化的数学与 ML 先变,实验是瓶颈的领域由实验 自动化的速度决定节奏
- 评估从可验证的一端开始改变 — 可复现性先变成 reward,AI 评审逐渐成为 第一道过滤器
- 不过,人类的评估本来就错误百出 — PPO 的价值不是评审者,而是九年后的 LLM 时代评定的
- 留到最后的是 taste — 证明定理的 AI 已经到了,提出猜想的 AI 正在路上。 那么**下定义(definition)**会是谁的工作?
我们将在下一期节目继续这个话题。
收听播客 — EP 105 文字稿
本文整理自 EP 105《AI 能做科研吗?》中的对话, 可直接跳转到对应段落的文字稿:
- 案例 1 — 被拒稿的 PPO 论文与同行评审的局限 (0:30)
- 案例 2 · 3 — AI slop 时代的 arXiv 与学术会议 (2:54)
- 尝试 1 — 可复现性:Hugging Face Reproduce Challenge (10:04)
- 尝试 2 — 研究 Ralphthon 现场 (12:27) · 评审代理与奖励设计的问题 (16:40)
- Dwarkesh ① — Dwarkesh × Grant Sanderson:数学与 AI (18:38) · IMO 金牌不等于 AGI (20:13) · Galois 群论与跨越百年的验证时间尺度 (24:27)
- Dwarkesh ② — Adam Brown:压缩即智能的观点 (30:51) · 没有实验的理论物理与 LLM 的探索 (33:44)