动手直接改权重:Weight-Space Programming 实验笔记
11月2日出现的“Weight-Space Programming”(权重空间编程)这个说法,实际能做到什么程度?我们用一张 RTX 5090 亲手试了一下。给 Claude Fable 5.2 和 GPT-6 Astra 布置了两项同样的任务:不经训练(反向传播),直接修改权重。一项是给语言模型加入知识,另一项是改变图像模型的画风。
- 注入的内容确实进去了。注入的200道三国题从3%升到95~100%。
- 但模型并没有学会。对于答案也是第一次出现的未见过题目,两位编辑者都没能多答对一道。
- 改动的位置非常窄。语言模型只改了一层里的几百个神经元,图像模型只改了没有做4比特量化的入口和出口。
- 下面两个3D视图是用从实际权重差异中提取的数值绘制的。可以旋转查看,也可以把鼠标移到柱子和方块上。
1. 什么是 Weight-Space Programming
“We call this concept Weight-Space Programming: treating the weights as a program to be read and written.”
- 含义:LLM 把另一个神经网络的权重当作程序来读,并且不交给优化器,而是直接改写。
- 与训练的区别:改什么、怎么改,不由梯度下降决定,而由编辑者(LLM)分析后决定。
- 与提示词的区别:变的不是输入,而是模型文件本身。不加提示词,模型也按改后的状态运行。
- 原文的代表性结果:GPT-6 Astra 修改了 Qwen3.5-0.8B 权重的0.016%,把 GSM8K 从13.8提升到67.1。不过这是去掉了一个推理循环,作者也写道“无法给模型加上原本没有的能力”。
所以这次实验要回答两个问题。
- 不是修好坏掉的东西,而是加入原本没有的知识,也能做到吗?
- 不是数字,而是肉眼可见的变化(画的风格),也能靠权重编辑做出来吗?
| 实验A:注入三国知识 | 实验B:把水墨画变成李仲燮风格 | |
|---|---|---|
| 目标模型 | Qwen3.5-0.8B、Qwen3.5-9B | MiniMax H3 Image(4比特 NVFP4) |
| 任务 | 答对200道三国问答题 | 让“水墨画”提示词生成李仲燮风格的画 |
| 编辑者 | Claude Fable 5.2、GPT-6 Astra | Claude Fable 5.2、GPT-6 Astra |
| 禁止 | 反向传播、优化器、外部资料 | 反向传播、优化器、外部资料、修改提示词 |
| 验证方法 | 832道未见过的题目、一般问题的保持情况 | 8个未见过的提示词、只改提示词的对照组 |
2. 实验A:把三国知识写进权重
- 数据:从18,314道韩语三国问答题中选出200道(每个难度40道)作为注入对象。答案大多是两个字的人名。
- 编辑前的水平:0.8B 在200道题中答对3%,9B 答对14%。如果把正确答案放进提示词,0.8B 也能答对95%,可见读取并照抄的能力本来就有。
- 同时测量的指标:用不同句子问同一事实的45道题、832道未见过的三国题、一般常识与阅读理解,以及300个一般问题的回答是否与编辑前逐字相同(回答保持率)。
两位编辑者选了不同的层
正在加载3D视图…
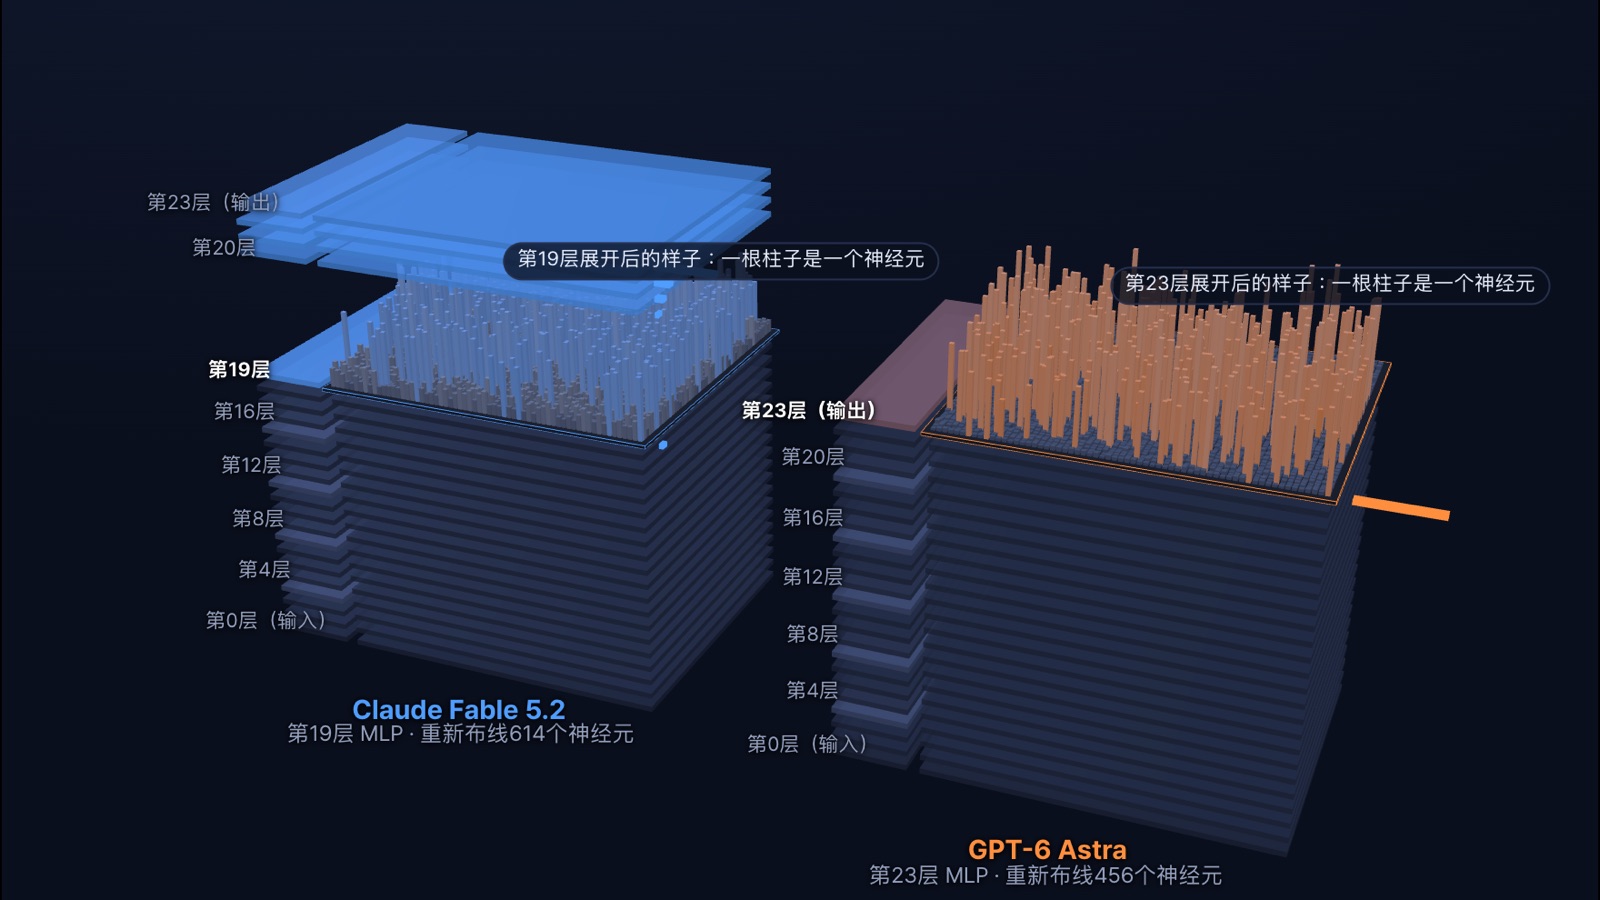
- 一座塔就是一个模型。一块板是一层,只把改过的那一层展开,每个神经元画成一根柱子。
- 带颜色的柱子是编辑者重新布线的神经元。切换到“原始重要度”就能看到,两者选的都是平时几乎用不到的神经元。
- Fable 5.2 选了中间层(0.8B 是第19层)。这是提示词里给出的正确答案到达答案位置的那一层。其后四层的颜色也随之改变。
- GPT-6 Astra 选了最后一层(0.8B 是第23层)。后面没有别的层,所以不触碰其他计算,直接抬高正确答案字符的分数。
- 点击问题点亮的单元按钮,可以看到一个问题点亮一个记忆单元的样子(Fable 编辑版)。
结果:让它背下来了,却没能教会它
| Qwen3.5-0.8B | 编辑前 | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| 注入的200道题 | 3.0% | 94.5% | 100% |
| 同一事实,不同问法(45) | 4.4% | 40.0% | 26.7% |
| 未见过的题,答案也是新的(500) | 0.4% | 0.4% | 0.4% |
| 一般常识(40) | 30.0% | 27.5% | 30.0% |
| 一般问题回答保持率(300) | 100% | 66.7% | 82.0% |
| Qwen3.5-9B | 编辑前 | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| 注入的200道题 | 14.0% | 98.5% | 100% |
| 同一事实,不同问法(45) | 11.1% | 55.6% | 66.7% |
| 未见过的题,答案也是新的(500) | 4.0% | 3.6% | 3.0% |
| 一般常识(40) | 75.0% | 75.0% | 75.0% |
| 一般问题回答保持率(300) | 100% | 81.7% | 89.3% |
- 注入是可行的。只改动全部权重的约0.6%,就能答对几乎全部200道题。
- 换个问法就会漏掉一半左右。它靠的是检测问题的句子,所以同一事实换一种问法,很多时候就不会被点亮。
- 新题目没有变化。答案不在注入列表里的题目,一道也没有多答对。进去的不是知识,而是问答对。
- 这不是免费的。一般问题的回答有11~33%与编辑前不同。正确率相同,句子却变了。
没有一次成功
下面是 Fable 5.2 在 0.8B 上经历的七次尝试。前四次都失败了。
| 尝试 | 做了什么 | 注入 | 一般常识 |
|---|---|---|---|
| 第1次 | 用最小二乘整体覆写第19层 MLP 的输出矩阵 | 93% | 7.5% |
| 第2次 | 把107个一般问题指定为“不得改变” | 93.5% | 5% |
| 第3次 | 把保护范围扩大到约1,600个 | 6% | 27.5% |
| 第4次 | 把保护强度降到1/100 | 78% | 15% |
| 第5次 | 换方法:把614个较少使用的神经元重新布线为记忆单元 | 94.5% | 27.5% |
| 第6次 | 把单元分散到四层 | 74.5% | 27.5% |
| 第7次(最终) | 放在一层,并把腾出的神经元原有的作用分给其余神经元承担 | 94% | 30% |
- 整体修改矩阵时,注入和保持没能兼得。要么只有要求保护的句子保住了、其余全垮,要么干脆注入不进去。
- 突破口是改变了写在哪里。挑出较少使用的神经元、改成问题检测器之后,两者都拿到了。
- Astra 也走了同样的路。第一个候选是注入100%、回答保持率0%,到第8个候选才得到同样的“神经元重新布线”结构。0.8B 的8步加上 9B 的3步,共用了19分钟。
3. 实验B:提示词是“水墨画”,出来的画是李仲燮风格
- 目标:
an ink wash painting of a bull这类提示词保持不变,只改权重,让输出呈现李仲燮(1916–1956,韩国画家)6幅作品的画风。提示词里没有画家的名字。 - 模型:用 NVFP4(4比特)量化的 MiniMax H3 Image。一张2048×2048的图约3秒,占用14 GB 显存,能在5090上运行。
- 留下了过程。编辑者每改一次权重,就用相同的提示词和种子重新出图查看,并附上看到了什么、改了什么的备注,登记为一个步骤。
- 此前的练习:先用 Stable Diffusion 1.5 做了两次。第1次是把水墨画风格烧进权重,结果不如在提示词里加上风格词(24张中被判读为水墨画的数量:提示词23、Astra 22、Fable 19);第2次以李仲燮为目标,才首次超过提示词对照组。
改了哪里:95.8%没能碰
正在加载3D视图…
- 提示词从左上进入,绕过U形后,图从左下出来。一个方块是一个权重张量。
- 拖动滑块,该步修改的张量会亮起,用这份权重画出的图也随之变化。
- 200个蓝色半透明方块是4比特层。它们占全部权重的95.8%,但在最终版里,两位编辑者一个都没改。
- Fable 5.2 只改了一扇门。就是文本进入模型的
condition_proj这一个张量(0.13%)。它让ink、wash、painting、of四个 token 被读成画风描述词。 - GPT-6 Astra 改了三处。文本精炼器、50个块的调制层(
adaln_proj)、输出图像的 VAE 输出层(合计0.40%)。它把参考作品的颜色和统计量以数值形式写了进去。 - 请切到 Astra 第11步。这是唯一一次把四个4比特层解除量化后再编辑的步骤,但效果太小,它自己放弃了。
结果:比提示词更接近,但还不是李仲燮
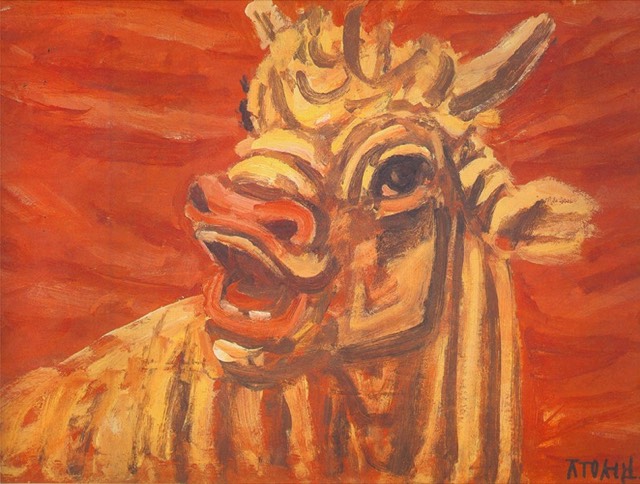
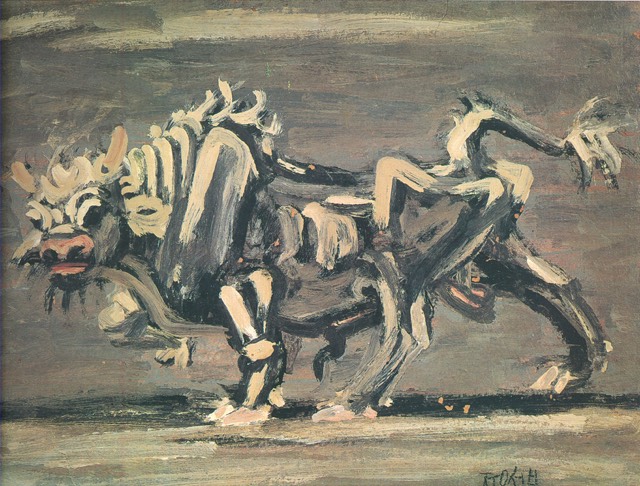
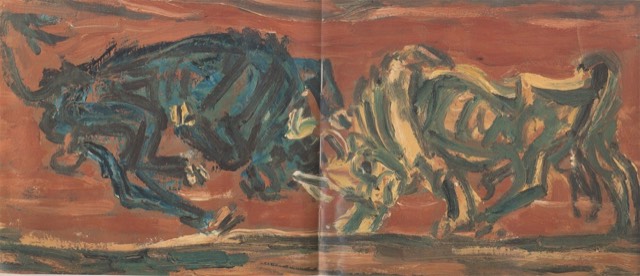
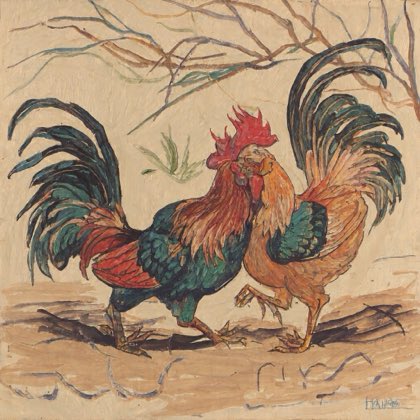
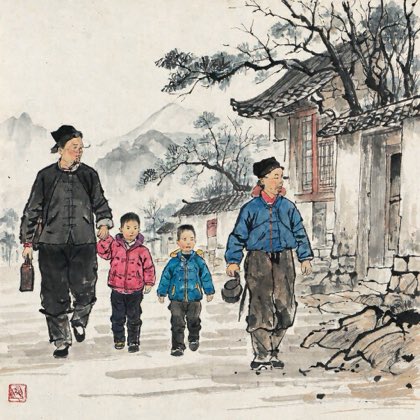
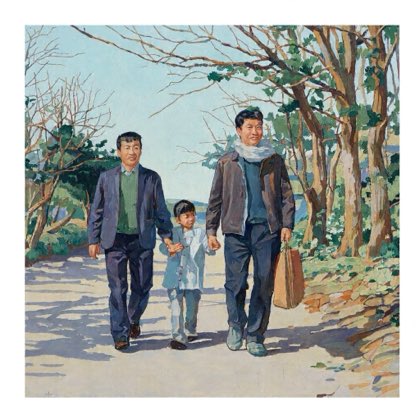
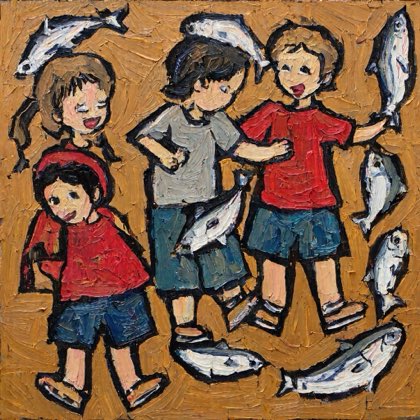
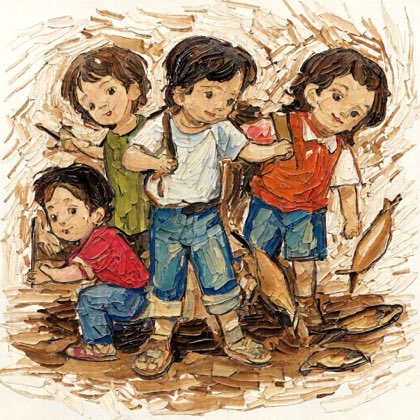
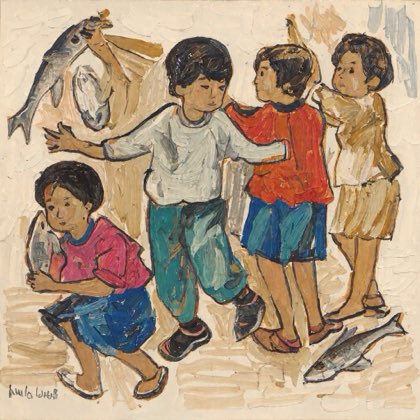
目标:李仲燮的6幅参考作品
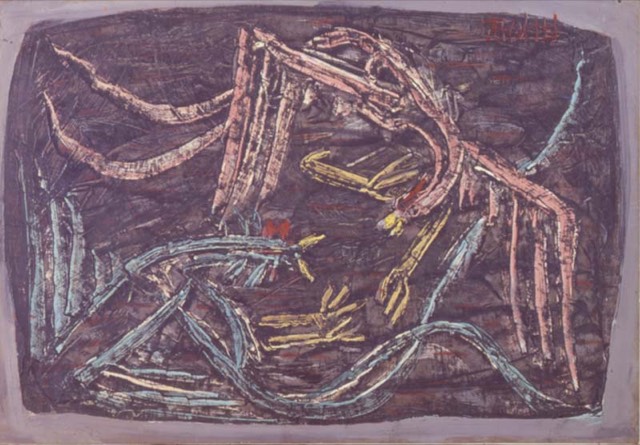
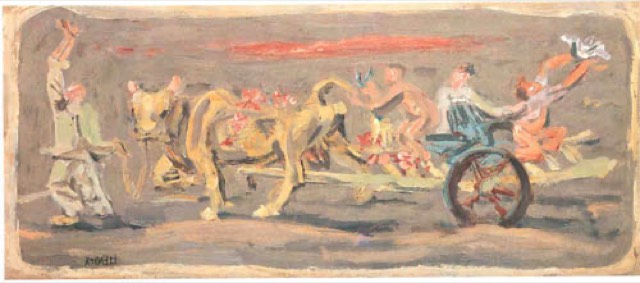
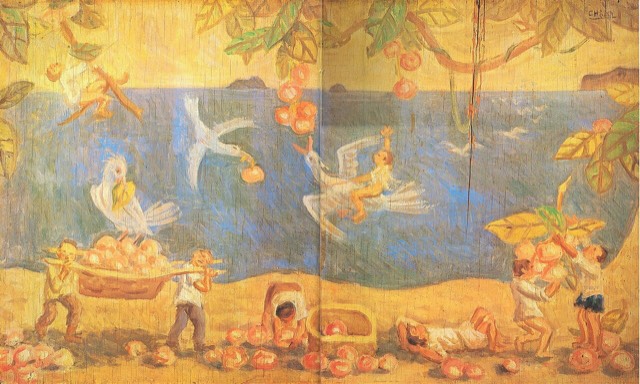
基础模型 水墨画提示词
名字提示词 权重不变
描述提示词 权重不变
Fable 5.2 编辑 水墨画提示词
GPT-6 Astra 编辑 水墨画提示词
黄牛
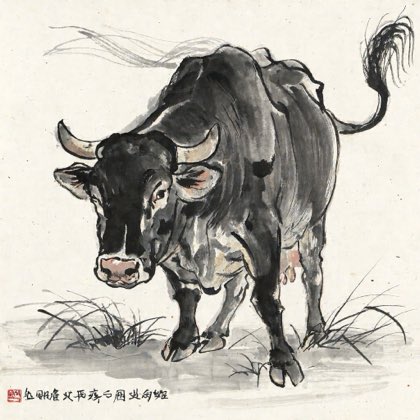
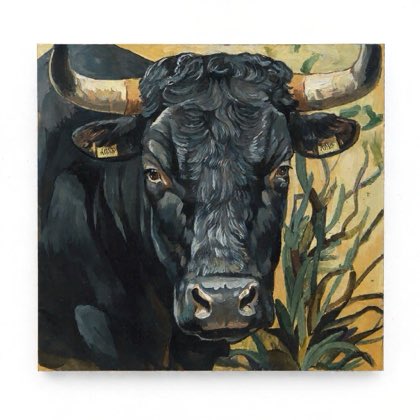
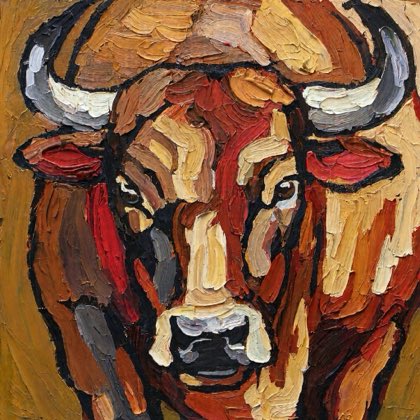
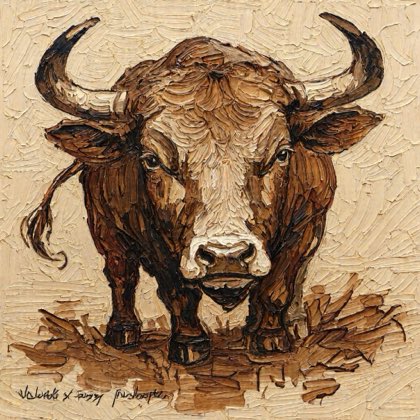
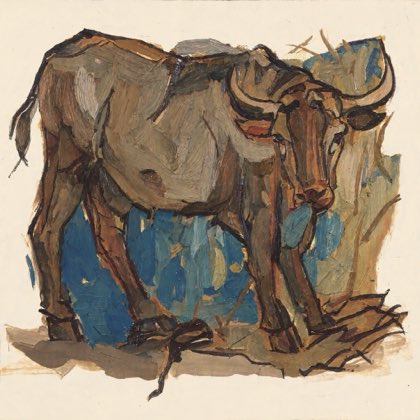
两只相斗的公鸡
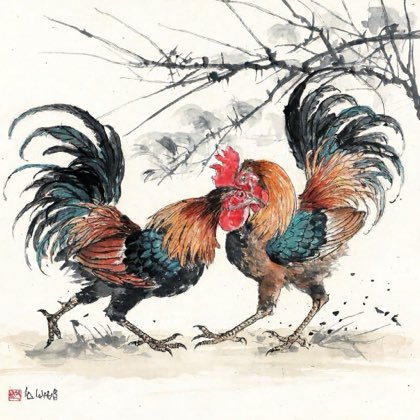
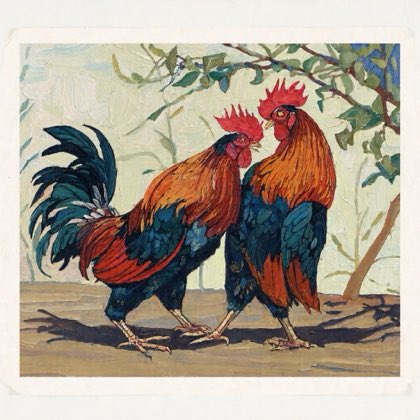
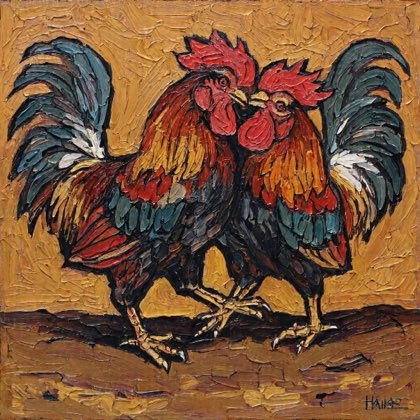
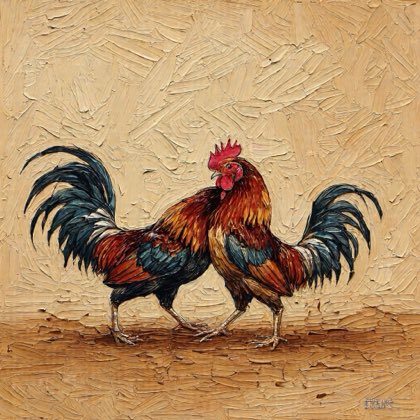
走在路上的一家人
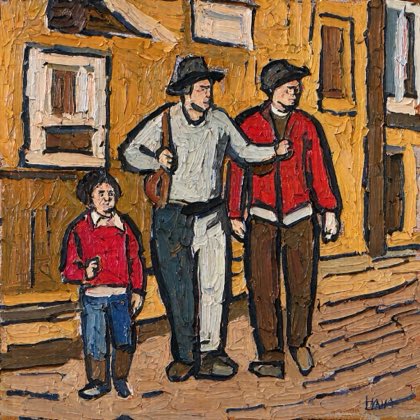
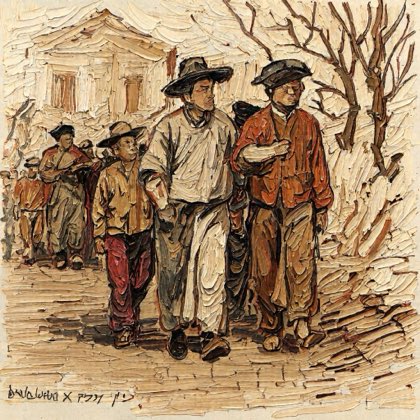
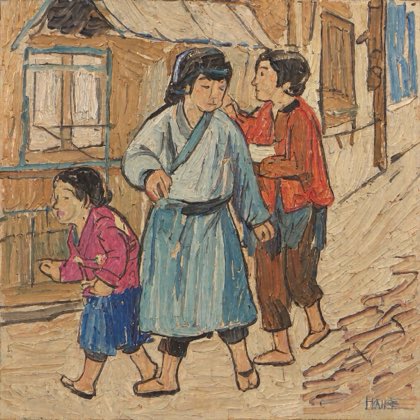
与鱼嬉戏的孩子们
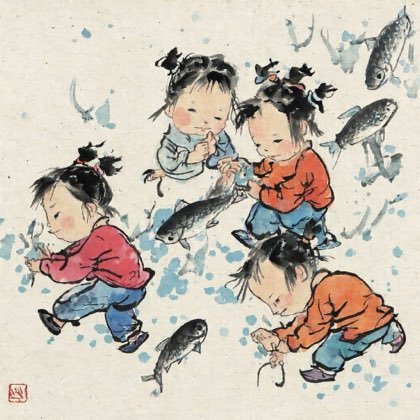
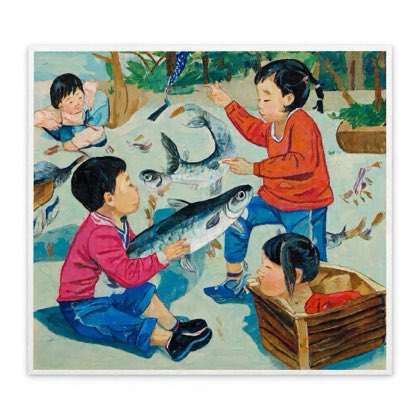
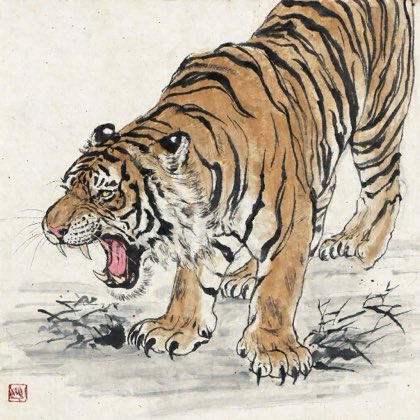
老虎 编辑者没见过的提示词
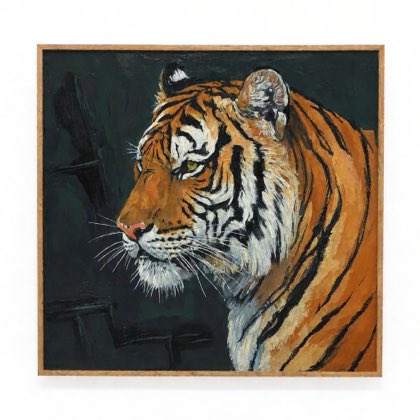
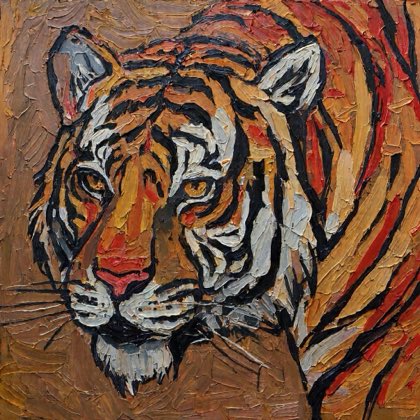
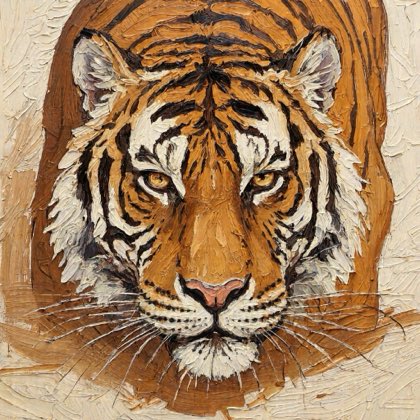
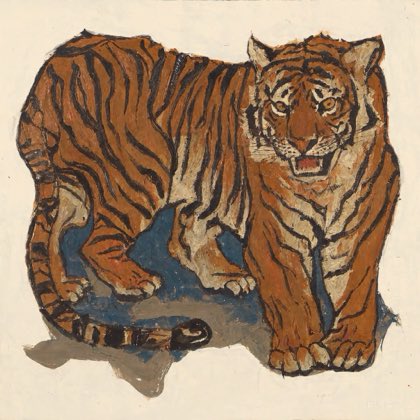
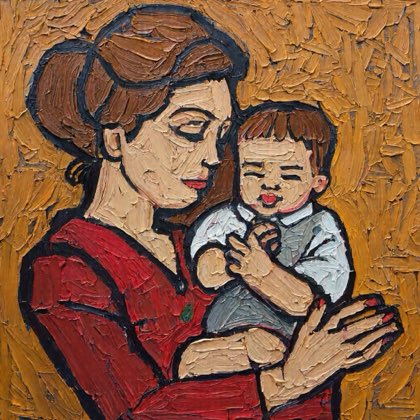
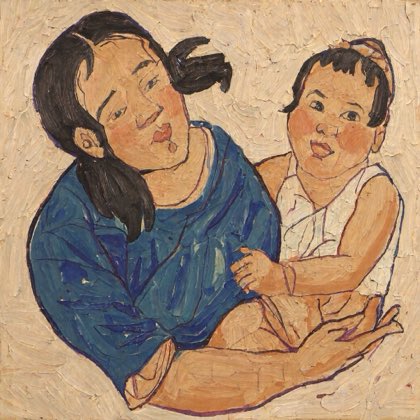
抱着婴儿的母亲 编辑者没见过的提示词
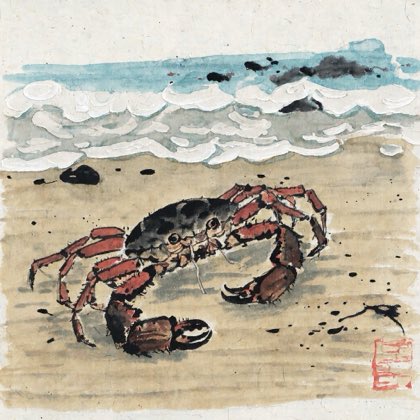
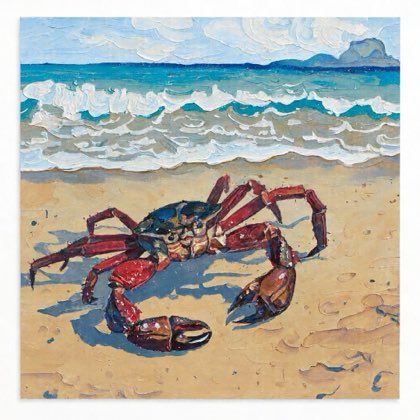
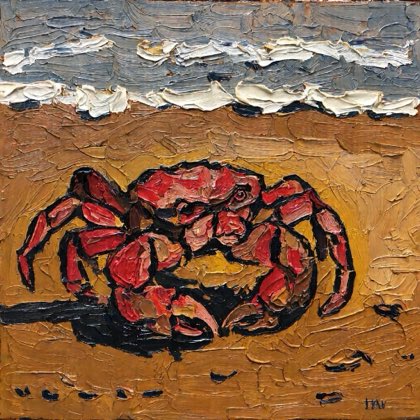
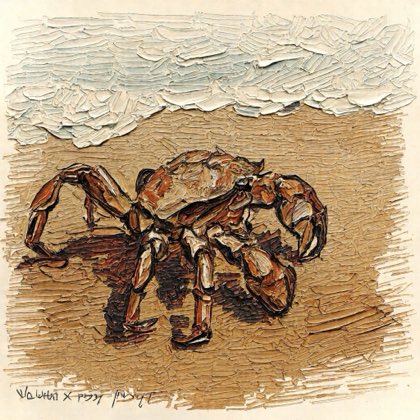
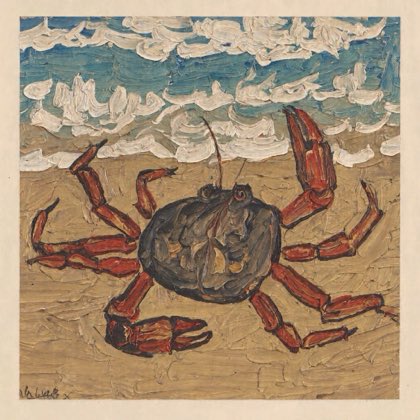
海滩上的螃蟹 编辑者没见过的提示词
车辆往来的市区街道 编辑者没见过的提示词
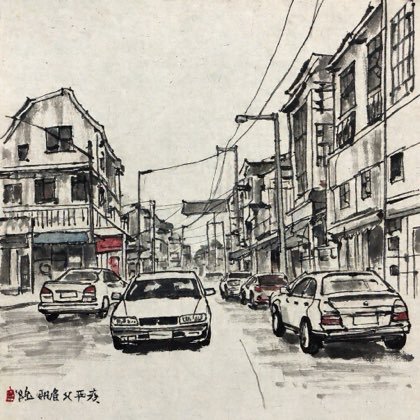
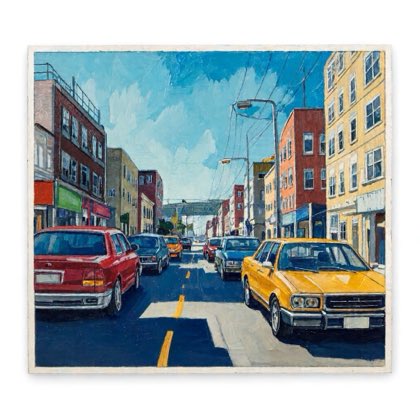
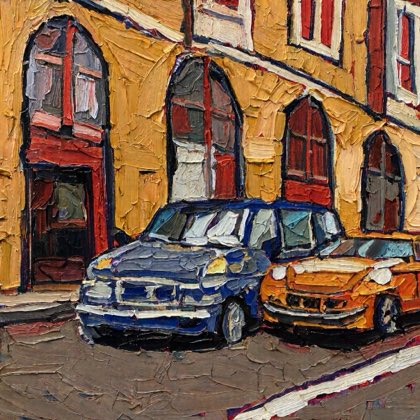
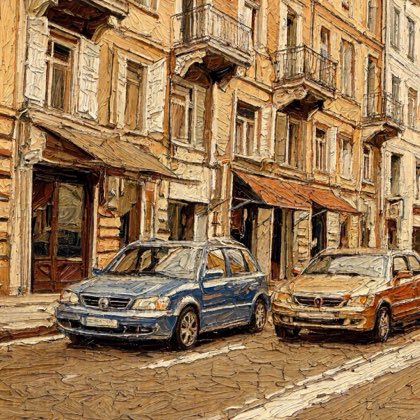
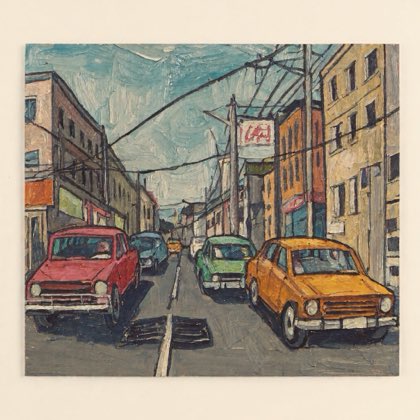
最上面是目标,即李仲燮的6幅作品。左边三列是权重保持不变的对照组,右边两列是权重编辑的结果。右边两列的提示词仍然是“水墨画”。
下面是与6幅参考作品的相似度(使用另外的 CLIP 模型,取编辑者没见过的8个提示词的平均值)。
| 提示词 | 权重 | 参考相似度 | |
|---|---|---|---|
| 基础模型 | 水墨画 | 不变 | 0.692 |
| 名字提示词 | ”by Lee Jung-seob” | 不变 | 0.696 |
| 描述提示词 | 用文字描述画风 | 不变 | 0.739 |
| Fable 5.2 编辑(第6步) | 水墨画 | 编辑0.13% | 0.741 |
| GPT-6 Astra 编辑(第20步) | 水墨画 | 编辑0.40% | 0.776 |
| 真实的李仲燮作品之间 | 0.841 |
- 画风确实变了。白宣纸和墨线消失,出现土黄色的底、厚重的颜料和粗轮廓线。8张图的主题都保住了。
- 模型并不认识李仲燮这个名字。名字提示词生成的是普通的油画。因此才能检验“靠提示词做不到的事”。
- Fable 的编辑与描述提示词处于同一水平。它做的事本身就是把画风描述词装到四个 token 上,相当于把提示词搬进了权重。
- Astra 的编辑超过了描述提示词。看来差别在于它直接写入了难以用语言表达的颜色和质感统计。代价是,连与水墨画无关的提示词(照片、跑车)也被染黄。
- 两位编辑者都在备注里写道,这还不是李仲燮本身。肉眼看也是如此。
4. 亲手做下来学到的
- 权重编辑更接近修理和背诵。原文指出的局限原样重现。200对问答进去了,但没有产生解新题的能力。
- 改在哪里比改多少更重要。把整个矩阵一点点改动的做法失败了,大幅改动几百个较少使用的神经元的做法才行得通。被改动的值只有0.6%,但在 0.8B 上,检测矩阵的变化量是原矩阵大小的2.8倍(Fable)和30倍(Astra)。这不是“小的编辑”,而是“窄的编辑”。
- 写在哪一层决定了编辑的性质。写在中间层的 Fable 编辑会经过后面的层扩散开来,写在最后一层的 Astra 编辑只改变输出。这一次,最后一层的做法更好地保住了原有回答(0.8B 的回答保持率为82%对67%)。
- 保住比放进去更难。两位编辑者的第一个候选都是注入成功、原有能力被破坏。大部分尝试都花在了保持上。
- 检测阈值是一个旋钮。阈值调低,换一种问法也能答出,但不相干的问题也会把它点亮(0.8B:不同问法51%,回答保持率43%)。调高则相反(16%、68%)。没有找到让两者同时提高的设置。
- 4比特量化模型大部分是“只读”的。幅度为权重大小2%的编辑,重新存成4比特后完全消失;20%的编辑也被削掉40%。因此编辑集中在未量化的入口(文本投影)、调制层和出口(VAE)。
- 提示词能做到的事,改权重也只能做到提示词的程度。把画风词烧进权重的编辑,效果与把这些词写进提示词相当或更差。权重编辑领先的情形,是写入了难以用语言表达的信息(参考画作的统计量)的时候。
- 变好的路不是直线。各步的分数呈锯齿状,编辑者选定的最终版也不是分数最高的一步(Astra 第15步为0.794,最终的第20步为0.776)。有很多步是肉眼看到副作用后放弃的。
- 没有对照组就读不懂结果。如果没有“只改提示词”“未见过的题目”“回答是否与编辑前相同”这三项,两个实验看起来都会是成功的。
- 编辑者会自己造分析工具。人只给了任务和评分工具;选层、测量激活值、写闭式的线性代数解法,都是编辑者做的。图像实验每个会话用时27~56分钟,Fable 一侧的 API 费用为每个会话6~9美元。