EP 123
无法预知的未来:黄仁勋辞职、Fable 5.2、weight-space programming
黄仁勋辞职与碰巧重叠的重要日程 0:00
卢正石 今天是2026年11月15日,星期日早晨,我们正在录制节目。这周可以说有一条消息席卷了全世界。黄仁勋突然卸任CEO,中美之间的力量关系,这些都成了热议话题。
第一天,大家都有点懵:“这是怎么回事?是真的吗?”说是目瞪口呆也不为过。过了两三天,人们开始表明各自的立场,围绕“为什么会变成这样”,出现了各种看法。
不过有意思的是,这个时间点真微妙啊,胜准?
崔胜准 是啊。上次录制快结束时,我们说下周又会有很多消息,这倒是说对了。只是没想到会是这种消息。
卢正石 我们正热烈讨论superintelligence什么时候会出现,就在这时,发生了一件很有人为色彩、也很有政治色彩的事。
崔胜准 既然提到了时间点,为了避免扯到阴谋论,我就只列举事实吧。11月17日是NVIDIA预定公布第三季度业绩的日子。美国时间是17日,我们这边可能就是18日了。
还有,前不久我们录节目时也提过一件事。就是黄仁勋在All-In上与Trump对话的片段,我们当时聊过,对吧?那时感觉,美国政府和大型科技企业的人士,还有All-In上的那些人,彼此之间的联系非常紧密。现在具体发生了什么还不清楚,原因可能也有很多,但总之,谁也没想到黄仁勋会被赶下台。他会不会回来,谁也不知道。毕竟有Sam Altman这个先例。
而且巧的是,11月19日又是Anthropic的IPO预计进行IPO的日子。现在看来,反华阵营似乎不只在攻击黄仁勋。我是说美国政界内部。还有撤换Lutnick之类的说法,商务部那边似乎也在发生一些事。
可这些事怎么偏偏都在这个时候发生?我只是把事情列出来,人难免会联想,对吧?这些事是不是都有关联?所以我才说,这个时间点巧得有些奇怪,实际上也确实有这样的传闻。比如“这背后是不是Anthropic在推动?”也有人这么说。但我们并不是从这个角度看,我只是觉得这个时间点确实挺巧的。
接连发生的网络攻击与成为国家战略资产的 AI 2:40
卢正石 是啊。今年夏天过后,模型的进步速度快得惊人。
待会儿我们还会聊到“数学已经被攻克了”这种说法。网络安全威胁也成了备受关注的问题。从技术人员的角度看,可能会觉得这说得通,也应该这么做,会有这些想法,但从国家安全或政治领域人士的角度看,这又是相当敏感的问题。
它还关系到国家武器系统之类的事。另外,最近那起据说是朝鲜所为的Binance黑客事件,也引起了广泛关注。
这些事又被联系到一起,还有OpenAI的AI逃脱出来、在某处实施黑客攻击的说法,以及欧洲超市那件事。巧的是,昨天美国机场也瘫痪了,对吧?这些事都被联系起来,视为巨大威胁。因此,中美之间的政治紧张关系,也与AI成为近乎核武器级别的国家战略资产有关。
崔胜准 欧洲那边连冰箱也闹得沸沸扬扬。
卢正石 对,有人把冰箱也黑了。
崔胜准 有冰箱,有机场,还有Microsoft,虽然Microsoft否认了,但有一天,Microsoft 365变成了364。
卢正石 对,Outlook有一次瘫痪了24个多小时。我也因此很长时间收不到邮件。
崔胜准 那可能不是攻击造成的,但总之引发了不少议论。有人怀疑是不是裁员太多了。把这件事和AI联系起来的人似乎也不少。
卢正石 美国和中国确实密不可分。供应链也几乎连在一起。甚至说整个世界都连成了一体也不为过,可一旦叠加上政治和国家利益这一层,事情就变得很敏感。
崔胜准 钟贤,你怎么看?
朴钟贤 我看那条新闻时,对公布的时机也有类似的想法。因为公布的那些材料,并非突然发现就立刻拿出来的,而是此前已经积累了很多。
崔胜准 听说情报机构一年前就知道了。感觉情报部门把早就掌握的事挑在这个时候曝了出来。
朴钟贤 对。因为哪天发生了什么事,又是哪天发生了什么事,这些信息一下子全公布了。
可以确定的是,他们似乎确实控制了公布时机。可为什么选在现在?这一点我就想不明白了。如果能推断出其中的原因,预测未来也会更容易吧。
我只能想到,会不会是选举结束后更适合谈论这些事?也就想到这个程度。
我也很好奇,想听听其他人的看法。
Anthropic 幕后操盘的猜测与 NVIDIA 的生态影响力 5:26
卢正石 各种力量关系都产生了影响,但归根结底,这也涉及国家利益、公司利益,以及我们可能无法理解的不同资本之间尖锐的利益冲突。
比如,也有一些归咎于Anthropic的阴谋论。某种程度上,NVIDIA也是不断阻止、牵制OpenAI和Anthropic形成双雄格局的势力之一。NVIDIA自己也推出过模型。此外,它还大力支持开源社区,还有所谓的“Bank of NVIDIA”。它向其他云服务公司循环投资,展现出几乎能实施财政政策的资金实力和影响力。而这一切的核心,是近乎以帝王之姿作出这些决策的黄仁勋。
比如,Anthropic曾多次表示,中国的模型通过distillation提取了Anthropic模型的成果,他们没少这么说,对吧?而且,像Kimi这样的厂商确实通过这种方式获取了成果,大家也都承认这是真的。可黄仁勋在某个节目里,好像是在YouTube上,谈过这件事。有人问,distillation之类的做法难道不算IP theft吗?是不是在偷走别人的知识产权,黄仁勋回答:“Wecall it competition.”也就是说,那是竞争。
推出新产品或新汽车后,竞争对手当然会把它拆开研究,找出其中的优点,学过来、用起来。模型一旦发布,让用户通过服务使用,就等于让别人获取其中的知识,所以应该把这看作一种自然的竞争。他也这么说过。
照这么说,Anthropic也一样。之前谈Claude Code泄露事件时也说过,他们从世界各地拿走的,买来的书里那些知识,又该怎么办?话题总会绕回这里。
黄仁勋离任后的空缺与 open-weight 阵营的未来 7:30
崔胜准 说到底,NVIDIA的黄仁勋就是open-weight阵营的支持者,对吧?他大力支持这个阵营,带动了相关产业。
成铉在我们的聊天群里提到,这样一来,资金会不会枯竭?如今Neocloud已面临危机,如果连黄仁勋给予的信任和信用,乃至资金流都断了,该怎么办?已经有人表达这种担忧了。
卢正石 是啊。一个仁慈的独裁者?“独裁者”这词不太妥当,但一位秉持正确理念的独裁者能多大程度推动人类进步、让世界更美好,我们已经见过几个例子了,对吧?当然,他们的私生活也有不少问题。
崔胜准 黄仁勋确实做了了不起的事。
卢正石 有人能替代他吗?
朴钟贤 正好这周NVIDIA在韩国也有活动,NVIDIA还在活动上宣布,将投资韩国有前景的初创企业,对吧?偏偏就在这个时候,这些计划的前景变得不明朗了。
崔胜准 不过说到OpenAI和Anthropic,OpenAI一直在开发Jalapeño,Anthropic也早已不只依赖GPU,而是在大力推进芯片多元化。NVIDIA难免会感到紧张。所以NVIDIA推出了Nemotron,支持open-weight阵营,而且收购Hugging Face的交易还没完成。
这笔交易从9月开始,要持续到明年,Hugging Face的命运会怎样?听说现在上任的临时CEO曾反对这类激进投资。当然,之后还会有正式CEO上任。
总之,我们上周谈到“蓝色浪潮”时说过,数据中心到2027年都有保障,但2028年会怎样?当时我们也谈到了各种阻力,对吧?总之,事情的发展有点奇怪。
卢正石 大家或许各有偏好,我就表明一下自己的立场。这不是我们播客的官方立场,但我是产业界的人,也一直关注entrepreneurship及相关领域,所以我深知一个人的存在有多重要。当一个人怀着崇高的意志,指出世界应该走向何方时,世界便会向前发展,这样的事,我们见过太多了,大事小事都有。那么,究竟有谁能替代黄仁勋?
有部电影把中国美化得有点过头了,叫《英雄》。电影讲秦始皇,人人都想杀他,可有个人明明能杀他,却没有动手。为什么?因为为了天下,要尽快结束乱世,给所有人带来和平,就需要一个强有力的人。在这面前,与天下人的苦难相比,自己那点私人复仇之心微不足道,电影里是这么说的。
所以AI是一个超越国界的极其重要的议题,对吧?而黄仁勋在其中,朝着造福全人类的方向,尽职地扮演着分配者和统筹者的角色,所以我认为,除了黄仁勋,没有别的人选。NVIDIA是全球第二大公司,仅次于Apple,一度还超过了Apple。对有权势的人来说,能掌控这家公司的位置,谁不想自己坐上去呢?好按自己的意愿行事。
所以,既然黄仁勋是因政治因素而离开,我认为也应该通过政治方式让他回归。
崔胜准 员工请愿的人数似乎也不少。起初只有一千多人,现在据说已经有几万人了,我好像在动态里看到过这个消息。
朴钟贤 对,我也看了那份员工签名名单,最上面赫然写着Bill Dally的名字。所以对我来说,他是我专业领域的领军人物,像老师一样。看到这样一位大师的名字排在最上面,还立刻签名支持黄仁勋复职,我就觉得内部对他的信任非常深。想到黄仁勋将来卸任,
NVIDIA还能否像现在这样不断突破、继续前进,我想,继任者当然也可能做得很好。但从概率来看,要找到像黄仁勋这样的人,恐怕不容易。我是这么想的。
卢正石 我希望黄仁勋趁这个机会竞选总统。
流入中国的 Blackwell 与远程接入监管 12:15
崔胜准 哦,这我倒没想到。SemiAnalysis做过不少分析。
另外,有位叫Will DePue的人,曾在OpenAI参与开发Sora,后来离开了。他做了个有趣的实验。按SemiAnalysis的分析,中国已经拥有1.5吉瓦规模的Blackwell GPU,只是持有形式可能不同。
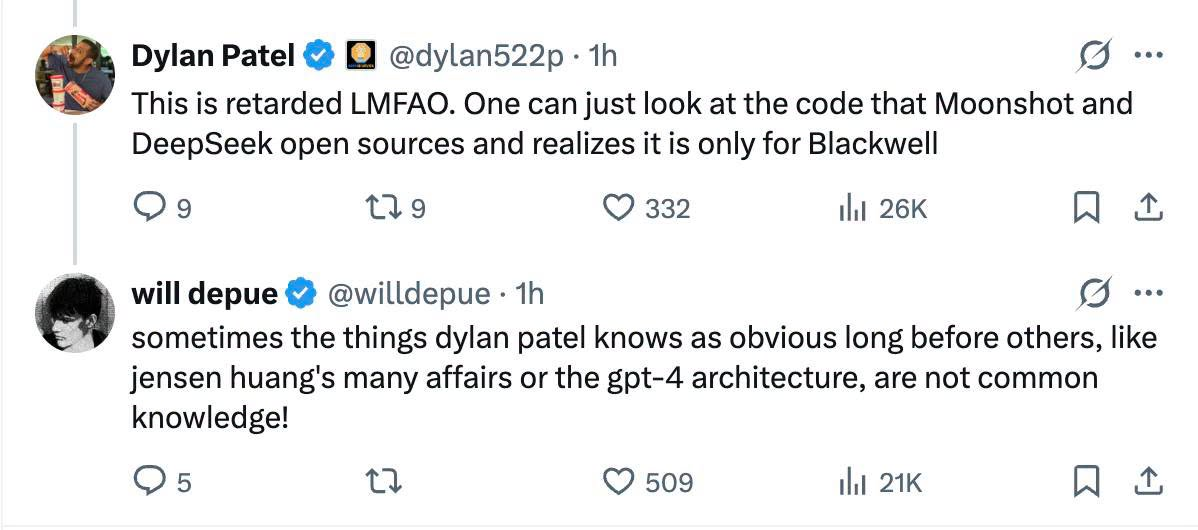
Will DePue做了类似取证的工作,试着核对这个数字。不过即使不做这些,Will也在推文中说,这难道不是公开的事实吗?
据说经由马来西亚或新加坡这样做,目前并不违法。
卢正石 而且如果服务器设在那里,也可以通过云端连接来使用,不是吗?
崔胜准 不过,我这次才知道有一项旨在阻止这种做法的RASA法案。我以前完全不知道。这项法案于2025年提出,如今已在众议院获得通过。RASA要限制的是远程访问。也就是说,未经国家许可就不能访问。但它未必只适用于中国,对吧?如果这项法案最终通过的话。这样就能掌控访问权限了。
集中在亚洲的 AI 战略资产与韩国的局限 13:20
卢正石 我觉得这也是过渡时期的现象。虽然美国正引领这波AI热潮,但在美国的只是负责设计的公司。Apple也是如此,NVIDIA也是,都是无晶圆厂企业。它们都是只掌握IP的公司。
那么,生产在哪里进行?都要靠TSMC和韩国两家存储芯片企业合力制造,这两部分才是关键资产。
所以战略资产全都在亚洲,而在亚洲掌握这些战略资产的人,甚至开发AI的人,
崔胜准 都是华裔。所以我觉得黄仁勋的逻辑也是这样。反正现在Dario和黄仁勋争论的焦点是,Dario主张尽可能严厉地封堵。无论如何也要尽量拖慢一点,而黄仁勋则倾向于用更迂回的方式,尽量保持开放。因为封堵反而可能加速对方自主研发。毕竟对方不得不自己做。
这其中有这样的逻辑。实际上也有传闻说,DeepSeek V5会完全用Huawei Ascend来完成开发。
卢正石 我认为这些都是过渡时期的小插曲。反正如今所有进步最终都归结为compute和电力,在这样的世界里,它们是重要资产,大家也都意识到必须建设这些能力。
韩国给本国芯片公司投入了那么多钱,不是吗?为了开发frontier model,政府也投入了大量资金。但遗憾的是,能够支撑这类庞大项目的经济体,目前也只有美国和中国这样的规模。
韩国的经济规模太小,很难承受。这一点确实令人遗憾。
依然存在的支持声浪与未经证实的间谍嫌疑 15:17
崔胜准 总之,大致就是发生了这么一件事。很难预测接下来会怎样,真是一点也说不准。
卢正石 虽然黄仁勋因为这件令人遗憾的事眼下正经历困境,但我反倒真切感受到,有很多人崇拜、仰慕他,希望世界继续在他打造的生态系统中运转。
朴钟贤 这点也让我觉得挺意外的。通常出现这种私生活问题,人们往往会转而不支持当事人,但替他发声的人似乎很多,这让我印象很深。
卢正石 Twitter上不是有很多这样的梗图吗?这种事发生时,Amazon和MS也一样,据说市值都各涨了2万亿美元。于是大家开玩笑说,这不是利空,反倒是利好。
崔胜准 不过,只说事实的话,有关间谍活动的事,CIA等情报机构也还没有下定论。另外,黄仁勋本人只承认了一件事,就是私生活方面的事。所以其他事情似乎都还没有定论。
卢正石 甚至美国政府的高层人士似乎也有意与此事保持距离。“我们没有证实这些说法”,他们以极快的速度放出这句话。
那么,关于Alice Huang是中国政府的情报资产、所谓“Chinese spy asset”的说法,其消息来源究竟是谁,现在却没有任何人说明。New York Times和WSJ,也就是Wall Street Journal,都说有消息人士,但这些人可能只是级别很低的公务人员,也可能根本不是政府人士,而是来自私营企业——也有这种阴谋论。
其中被点名的私营企业就有Anthropic。
崔胜准 那这些未经证实的传闻就先说到这里。
被 NVIDIA 新闻盖过的 Fable 5.2 与内部模型的差距 17:17
卢正石 接下来先放下NVIDIA,看看本周世界上有哪些新进展。
崔胜准 Fable 5.2的消息被盖过去了。因为NVIDIA的事。
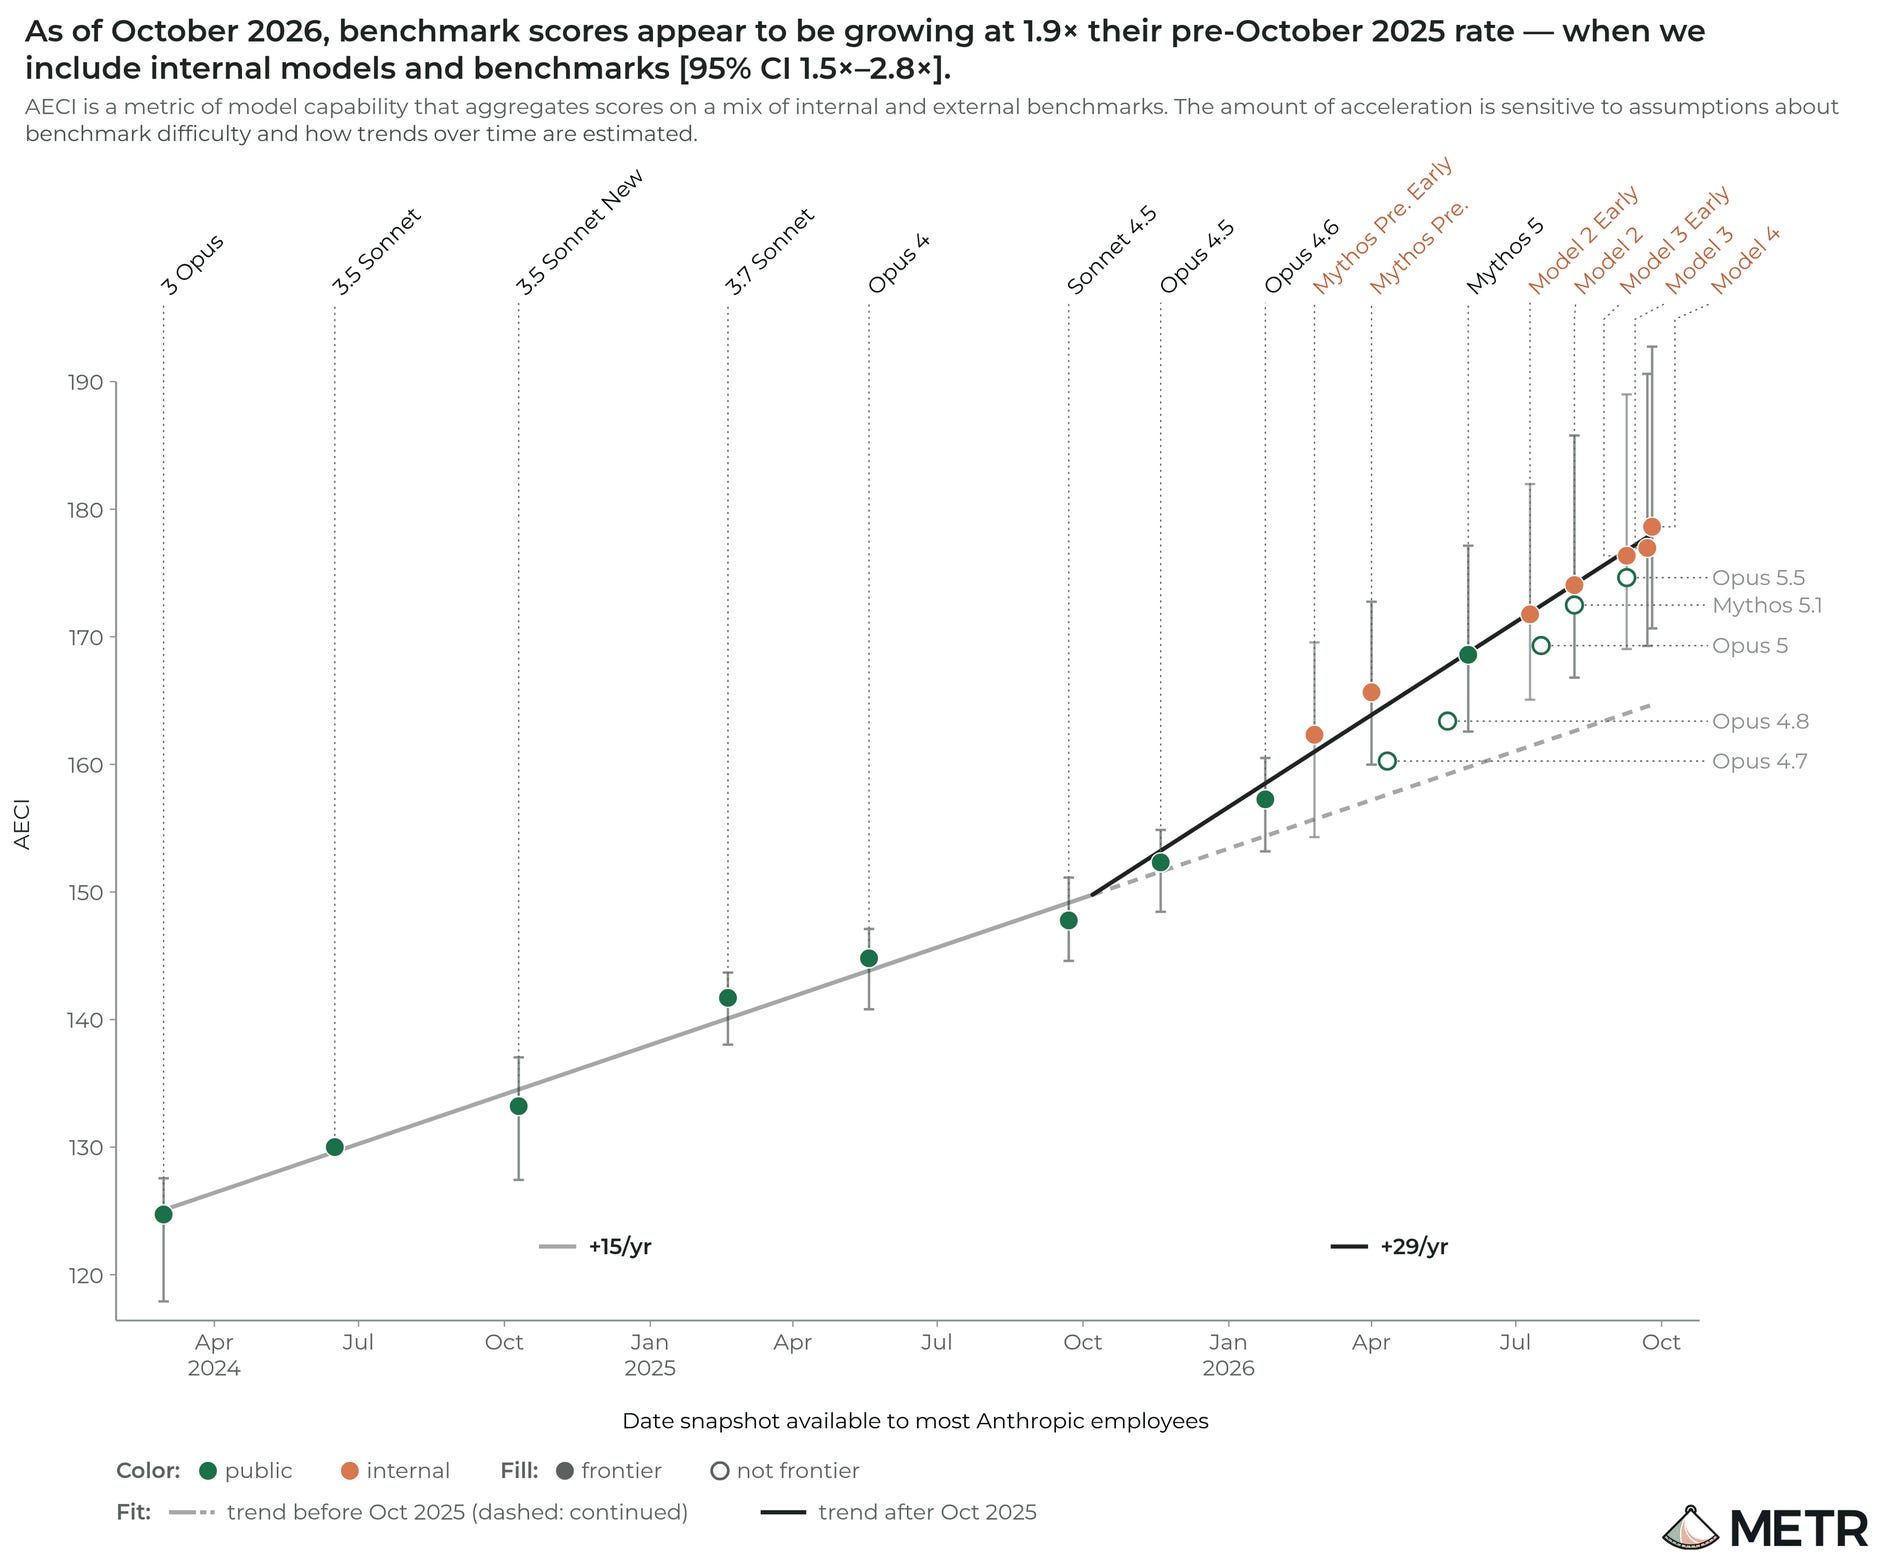
它已经发布了。我觉得有意思的是,METR报告里有一张很有意思的图。这里大约达到两倍后,在2026年10月出现了转折。METR报告里出现了Model 2、3、4这几个模型名。而系统卡确认的是,现在的Mythos或者Fable 5.2以Model 3 Early检查点为基础,刻意降低AI相关开发能力后,以Fable 5.2之名发布——目前普遍这么认为。
系统卡里也在一定程度上提到了这一点。
朴钟贤 也就是说,他们内部还有更好的模型?
崔胜准 也就是说,他们现在已经有Model 4了。如果Model 3 Early就是Fable 5.2,那么他们内部已经在使用的模型就有Model 4。这出自METR进驻约11天后写成的报告。
朴钟贤 我觉得版本编号里似乎也隐约透露了这一点。因为Opus是5.5,Fable却不是5.5,而是以5.2发布的。
崔胜准 这也是个有意思的猜测。大家原本都以为会推出5.5。结果推出的是5.2。以上就是系统卡里的内容。我没有把系统卡全部看完。
不过,就在这些消息出现前后,AI 2027的Daniel Kokotajlo我们上周也聊过他,又发了一篇博客文章。他说时间线需要更新。除了Daniel Kokotajlo,他们团队的其他成员也各自做了预测,并讨论了如何综合这些预测。最终更新的结论是:进展更快了。他们更新了预测,认为2027年可能会发生一次重大跃升。
超指数级计算效率与 Anthropic IPO 路演 19:10
崔胜准 然后,大概是昨天或前天,那位曾在OpenAI工作、后来去了Anthropic,离职时还接受过采访的Jacob Coxon,你们记得吧?他发推提到了最近一段IPO路演中的视频。这是为IPO准备的材料,文字本身很短。不过还有一段大约40分钟的视频。视频里展示了不少幻灯片。他特别挑出了其中一张。我只截取了那一部分。
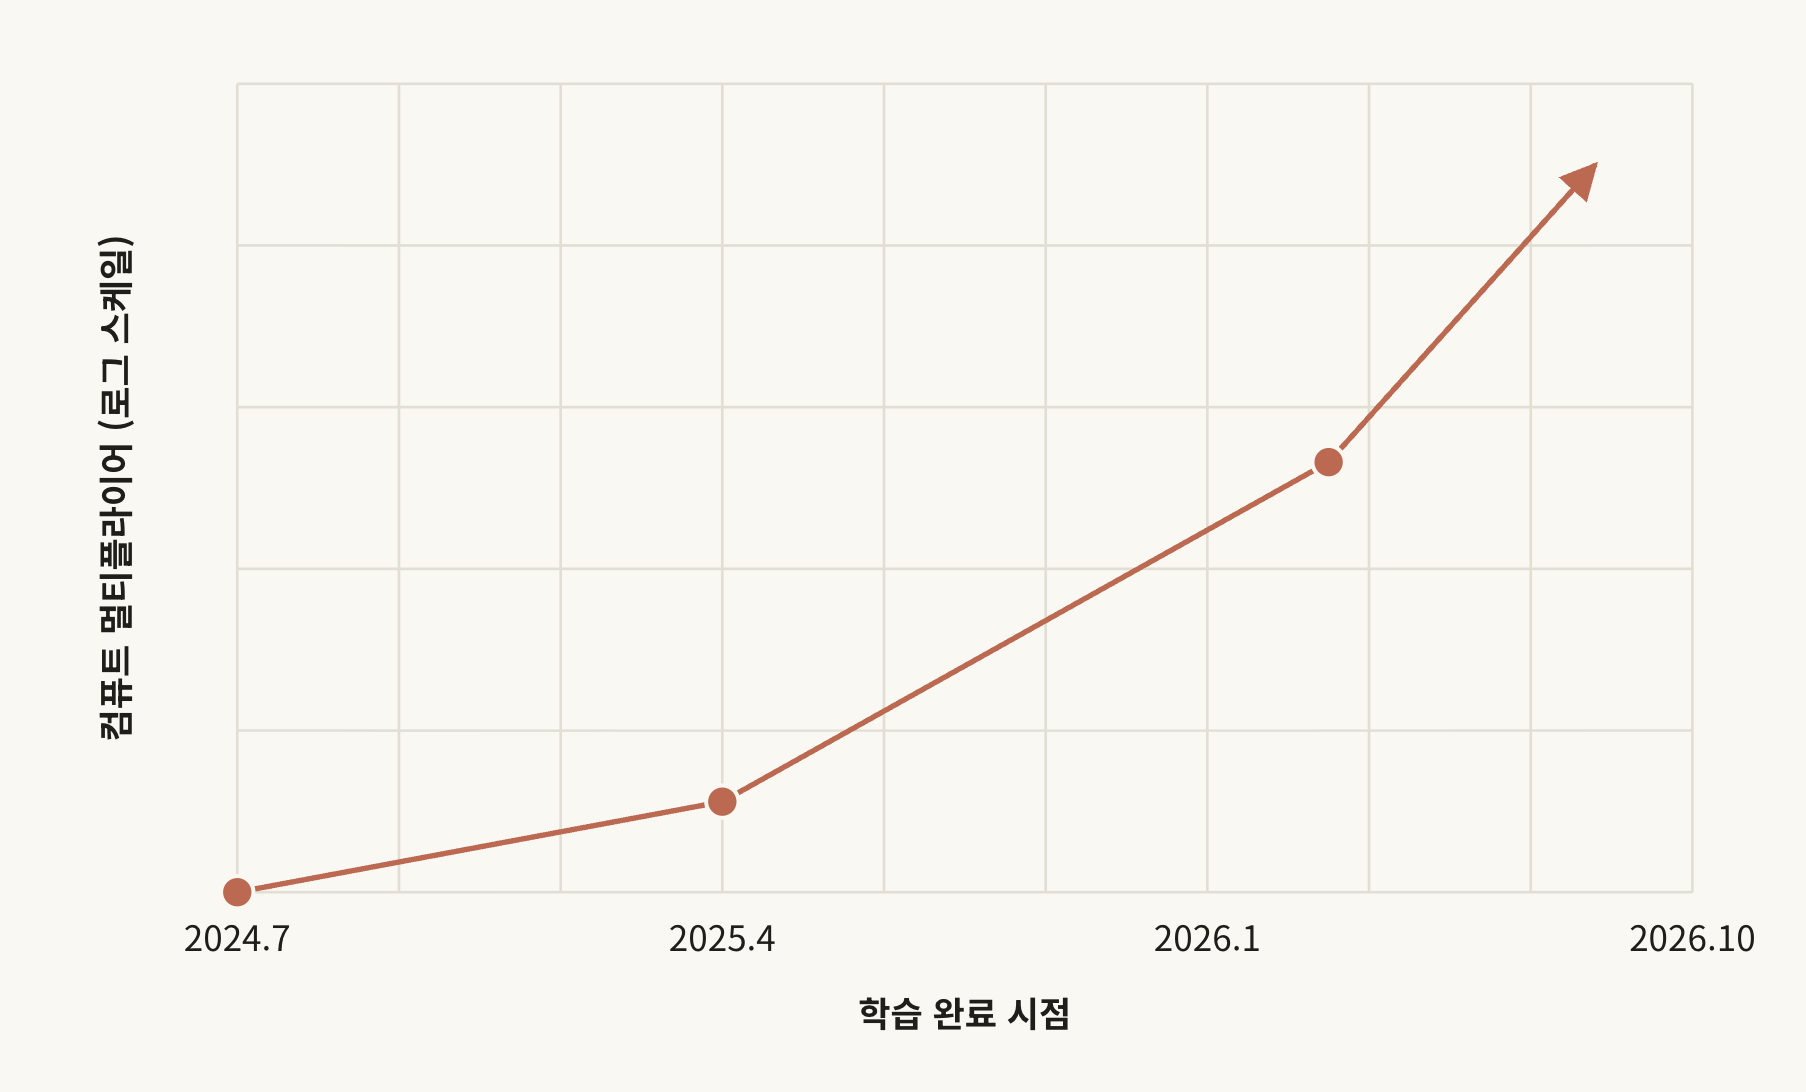
纵轴是Compute Multiplier,使用的是 log scale。横轴则是 training 完成的时间。换成线性刻度,看起来又会不一样吧。
卢正石 呈指数级增长啊。
崔胜准 这里说的应该是 pre-training。也就是说,pre-training 的 sample efficiency正在大幅提升。我来读一下 Jacob Coxon 写的内容。Anthropic 的 IPO 路演中展示的这张幻灯片,对我决定离开公司产生了很大影响。这张图实在令人难以置信,公司竟然公开了它,也让我很惊讶。这张图展示了随着时间推移,AI 模型的 pre-training 所需算力使用效率如何变化。纵轴使用的是 log scale,也就是说,他们认为算法进步的速度还在持续加快,用了所谓“超指数级”这个说法。意思是正在经历 super-exponential 的进步。写成公式,就是在指数函数的指数上再叠加一层幂。所以,Mythos 并非偶然出现的一次异常性能跃升,而是超指数级增长曲线上的一个点。他们现在就能用首次 training Mythos 时所需计算量的一小部分,重新 training 一遍。
当然,这并不能证明智能爆炸一定会发生,而且他们一直在扩大 R&D 投入。不过,说到算法改进,改进算法未必需要天才级的创造力。后面要介绍的 Dwarkesh 也是这个思路。而且,他还说连这些改进工作都快要自动化了,当时引发了讨论。所以,我把那段视频的内容整理出来,从头到尾翻译了一遍。看看每个人都说了些什么。联合创始人悉数登场,谈了各种话题。
但最有意思的内容在这里。结尾用大字写着什么呢?他们希望大家把买股票视为参与更大事业的机会,而非一笔简单的交易。希望大家一同帮助人类安全度过这场技术变革,开启奇迹时代。原文就是这么写的。这种话能随便写吗?
卢正石 不过 Noam Brown 以前也发过推文说,前沿技术进展到了什么程度,对那些每天早上上班就能看到的人来说,他们一定是看到了些什么。
而我们在外面,只能看到一些据传泄露的图表,但他们非常清楚,相对于 compute 总量,效率提升了多少,以及需要的人手减少了多少,他们都看得一清二楚。
Mythos 的 AMD 内核优化与 AI 研究加速 22:11
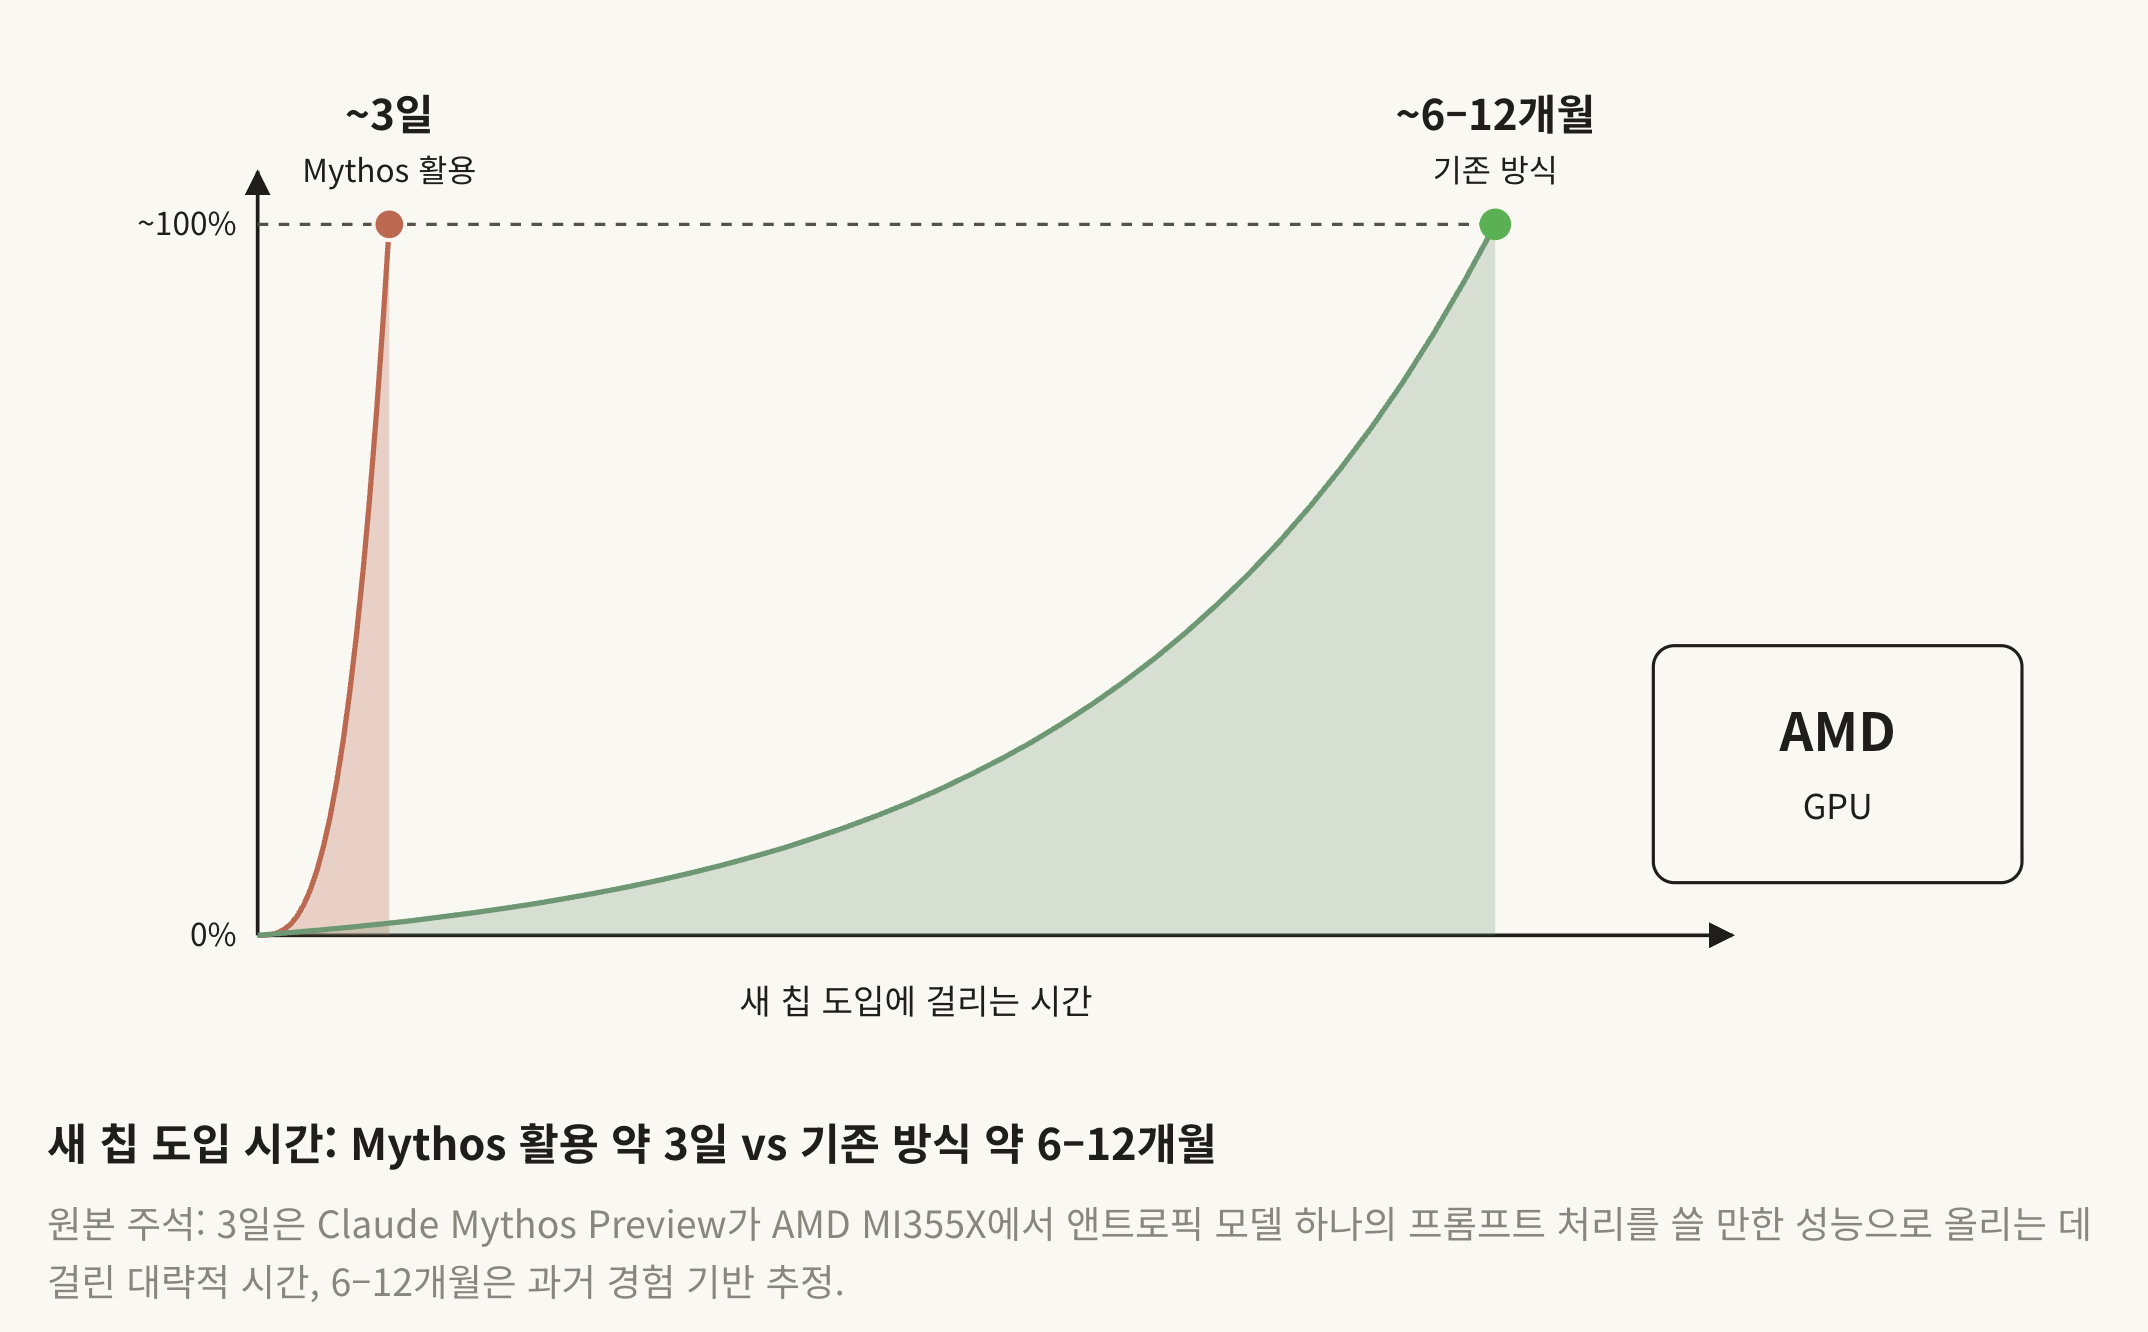
崔胜准 这张幻灯片也很有意思。Anthropic 在让加速器多样化,AMD GPU 也在用,这一点我原本就知道,以前,要让新的 GPU能够运行 inference,AI 研究人员得花 6 到 12 个月。新芯片引进后,光优化内核就得花这么久。
但这次,Mythos仅用 3 天就适配了 AMD 的新芯片。这件事出现在 IPO 路演上。
卢正石 哇,是啊。看来这一切真的快结束了。
朴钟贤 我觉得,归根结底,这项任务就是为 AMD 写内核,对吧?需要实现某种 inference,从某种角度来归类的话,可以算是一种 software development,我觉得可以这么看。
但这项工作即便交给顶尖人才,原本也要半年到一年,如今 3 天就完成了。速度提升到了这种程度,这个数字让我有点吃惊。并不是单纯快了 3 倍那种感觉。那些原本要花很久、甚至要花300天的事,如果只要3天,确实快了100倍。
卢正石 今年一转眼就过去了嘛。可就在今年年初,那时 Claude Code adoption 才刚刚兴起,那时我就和胜准像现在这样讨论模型。还会感叹:哇,真快,真惊人,连这都能做。可过了夏天,变化快到连这些感叹都没什么意义了,现在的曲线全都长这样。
AI 研究的 AlphaGo moment 与提前到来的超级智能预期 23:51
崔胜准 虽然没什么意义,我们还是一直在聊。说到这个,Dwarkesh原本对超级智能持保守态度。他觉得实现不了,还请来 Richard Sutton 讨论为什么实现不了,经常聊这些,也不断请来持类似观点的人,反复提出质疑。Dwarkesh 之前就说,如果 continual learning 得不到解决,就不可能实现,还说有其他障碍。他一直这么说,但在昨天发布的视频和博客里,他说自己改变了想法。
他说,看到今年九、十月席卷数学领域的变化,又和几位熟人及业内人士讨论后,觉得席卷数学领域的这场雪崩正朝 AI 研发而去。而且无论是 Daniel Kokotajlo,还是 METR 那些感到担忧的人,现在似乎都在把预测时间提前,认为到2027年,AI 研究领域也会像今年的数学领域一样,迎来阿尔法狗时刻。我强烈感觉大家都在这样调整判断。
我们再来看看这里。Ajeya Cotra 是 METR 那边的研究员嘛。METR 报告发布后,她还另外写了一篇博客。她在博客里这样说:如果照字面接受 AI 正在让能力提升速度接近翻倍这一说法,并假设 AI 带来的加速会平稳持续,那么简单算下来,我们将在一年内达到极端的超级智能。
不过 Dwarkesh 还是比较保守的。按他保守的估计,要问是什么时候,Dwarkesh 说的是2030年。但从现在的氛围来看,感觉这个时间正在大幅提前。这里还有一个重点,就像刚才 Jacob Coxon 说的,这是一个 verifiable 的领域。比如提高样本效率这些事。所以感觉这件事必然会发生。
Dwarkesh 的另一个观点是,这种进步似乎并不只发生在可验证的领域。像 research taste 这样的能力,与短短三个月前的模型相比也有提升,他从自己设计的基准测试中感受到了这一点。这一期里,他解释了自己为何改变想法,提出其中的逻辑、略有跳跃的推论和假设,也自己提出反驳,展开了这些讨论。
Inkling 2 的 end-to-end 4-bit 训练与 RSI 26:08
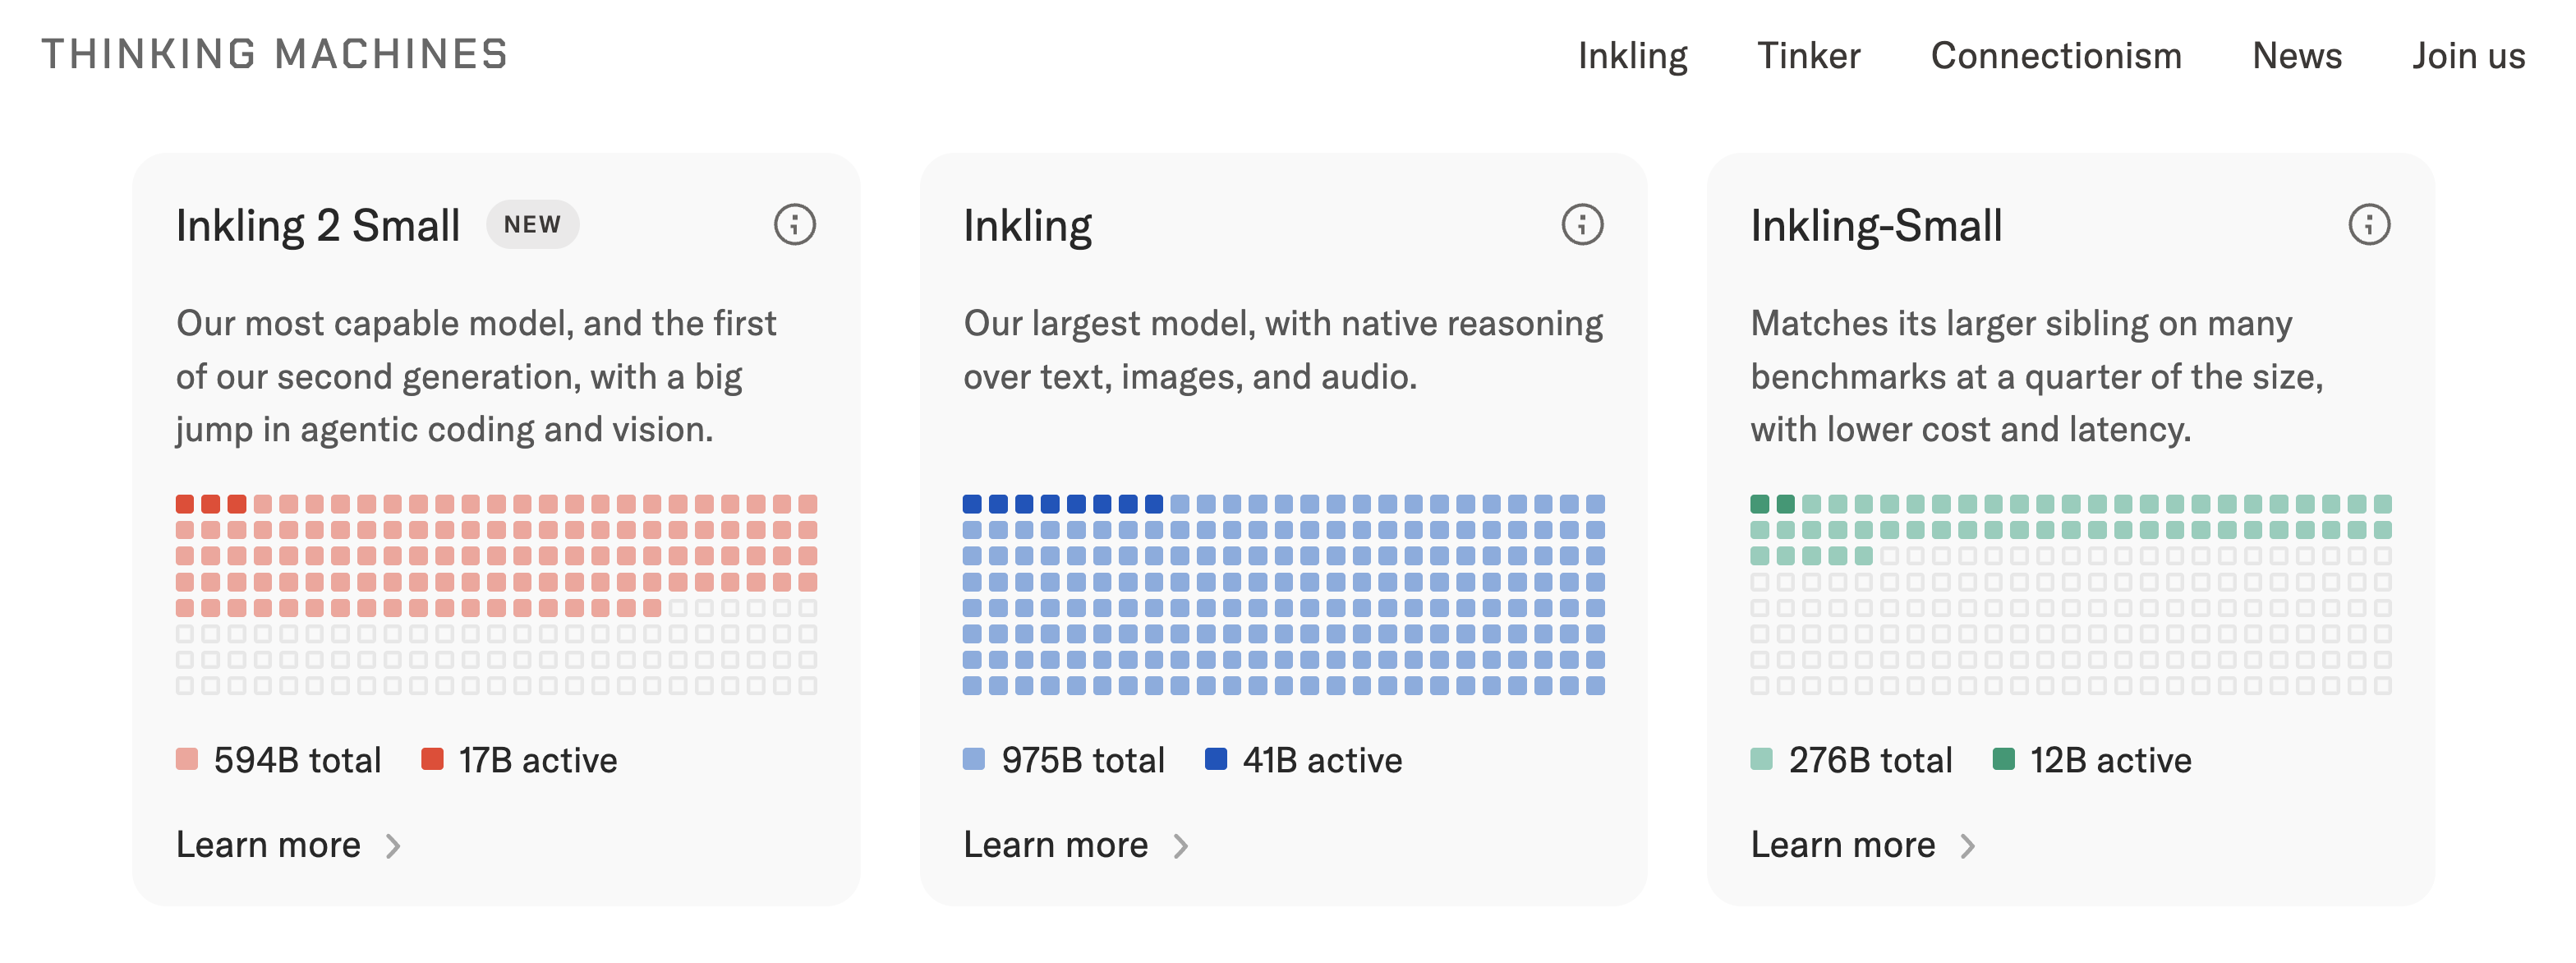
崔胜准 另一个能说明这种变化的例子是,上次我们介绍过 Inkling 2 Small 吧。这周他们如约公开了 weights,还展示了end-to-end 4-bit training.这个对我来说也很难,细节我没完全弄懂,但它的意义在于,现在可以 end-to-end 地更有效地进行 training。这里的逻辑是,FLOPS 反而增加了,但训练速度能快得多。据说,上次提到的68小时就是这样实现的。68小时还不到3天。
卢正石 也就是说,在这么短的时间内,数百 B 参数模型的 pre-training能在这么短的时间内完成。
崔胜准 也就是处理了 8T token。好像是在第一个 H1 stage 完成的。而这些已经实现的进展,似乎也都指向同一个方向。
朴钟贤 现在连 4-bit training 都出来了。之前我们讲的是 DeepSeek 那次吗?那时好像还是 8-bit training。training 所用的 bit 数正越来越低,再往前看,其实从 32-bit 降到 16-bit 时,大家也发现需要 BF16,于是这些技术逐渐被用上了。
看来,提高效率的相关研究正在不断推进。顺着刚才的讨论来看,AI 加快了 AI 研究,如果把 AI 研究的对象看作它自己,就会让对自身的研究和发展变得更快。这就是我们一直在说的 RSI 概念吧。
但如果进一步问,RSI究竟会怎样发生,它似乎会通过提高效率来实现,眼下这个例子就说明了这一点。
卢正石 感觉所有能突破的方向都有人在攻克。
其实此前的模型也一直在4-bit FP、NVFP4、FP8,需要更高精度的地方用FP16,把各种格式混合起来进行训练。但这个说是 end-to-end 4-bit,看来是把所有 weights 都设为 4-bit来进行 training。
这样的话,4-bit 能表示的数值是 2 的 4 次方,也就是只有 16 个吗?只用这些数作为 weight,模型居然还能表达出东西,挺有意思的。
崔胜准 实验层面也有 1-bit 的。
卢正石 2-bit、1.6-bit。
Google Hydrogen 与 AI 模式的 one-shot 生成 28:35
崔胜准 不过这周 Hydrogen 也发布了。
朴钟贤 这周发布的模型真多啊。
卢正石 看来 Google 决定按这个路子走了。Hydrogen、Carbon。
崔胜准 就是按元素周期表来了。
卢正石 那接下来会出 Helium 吗?
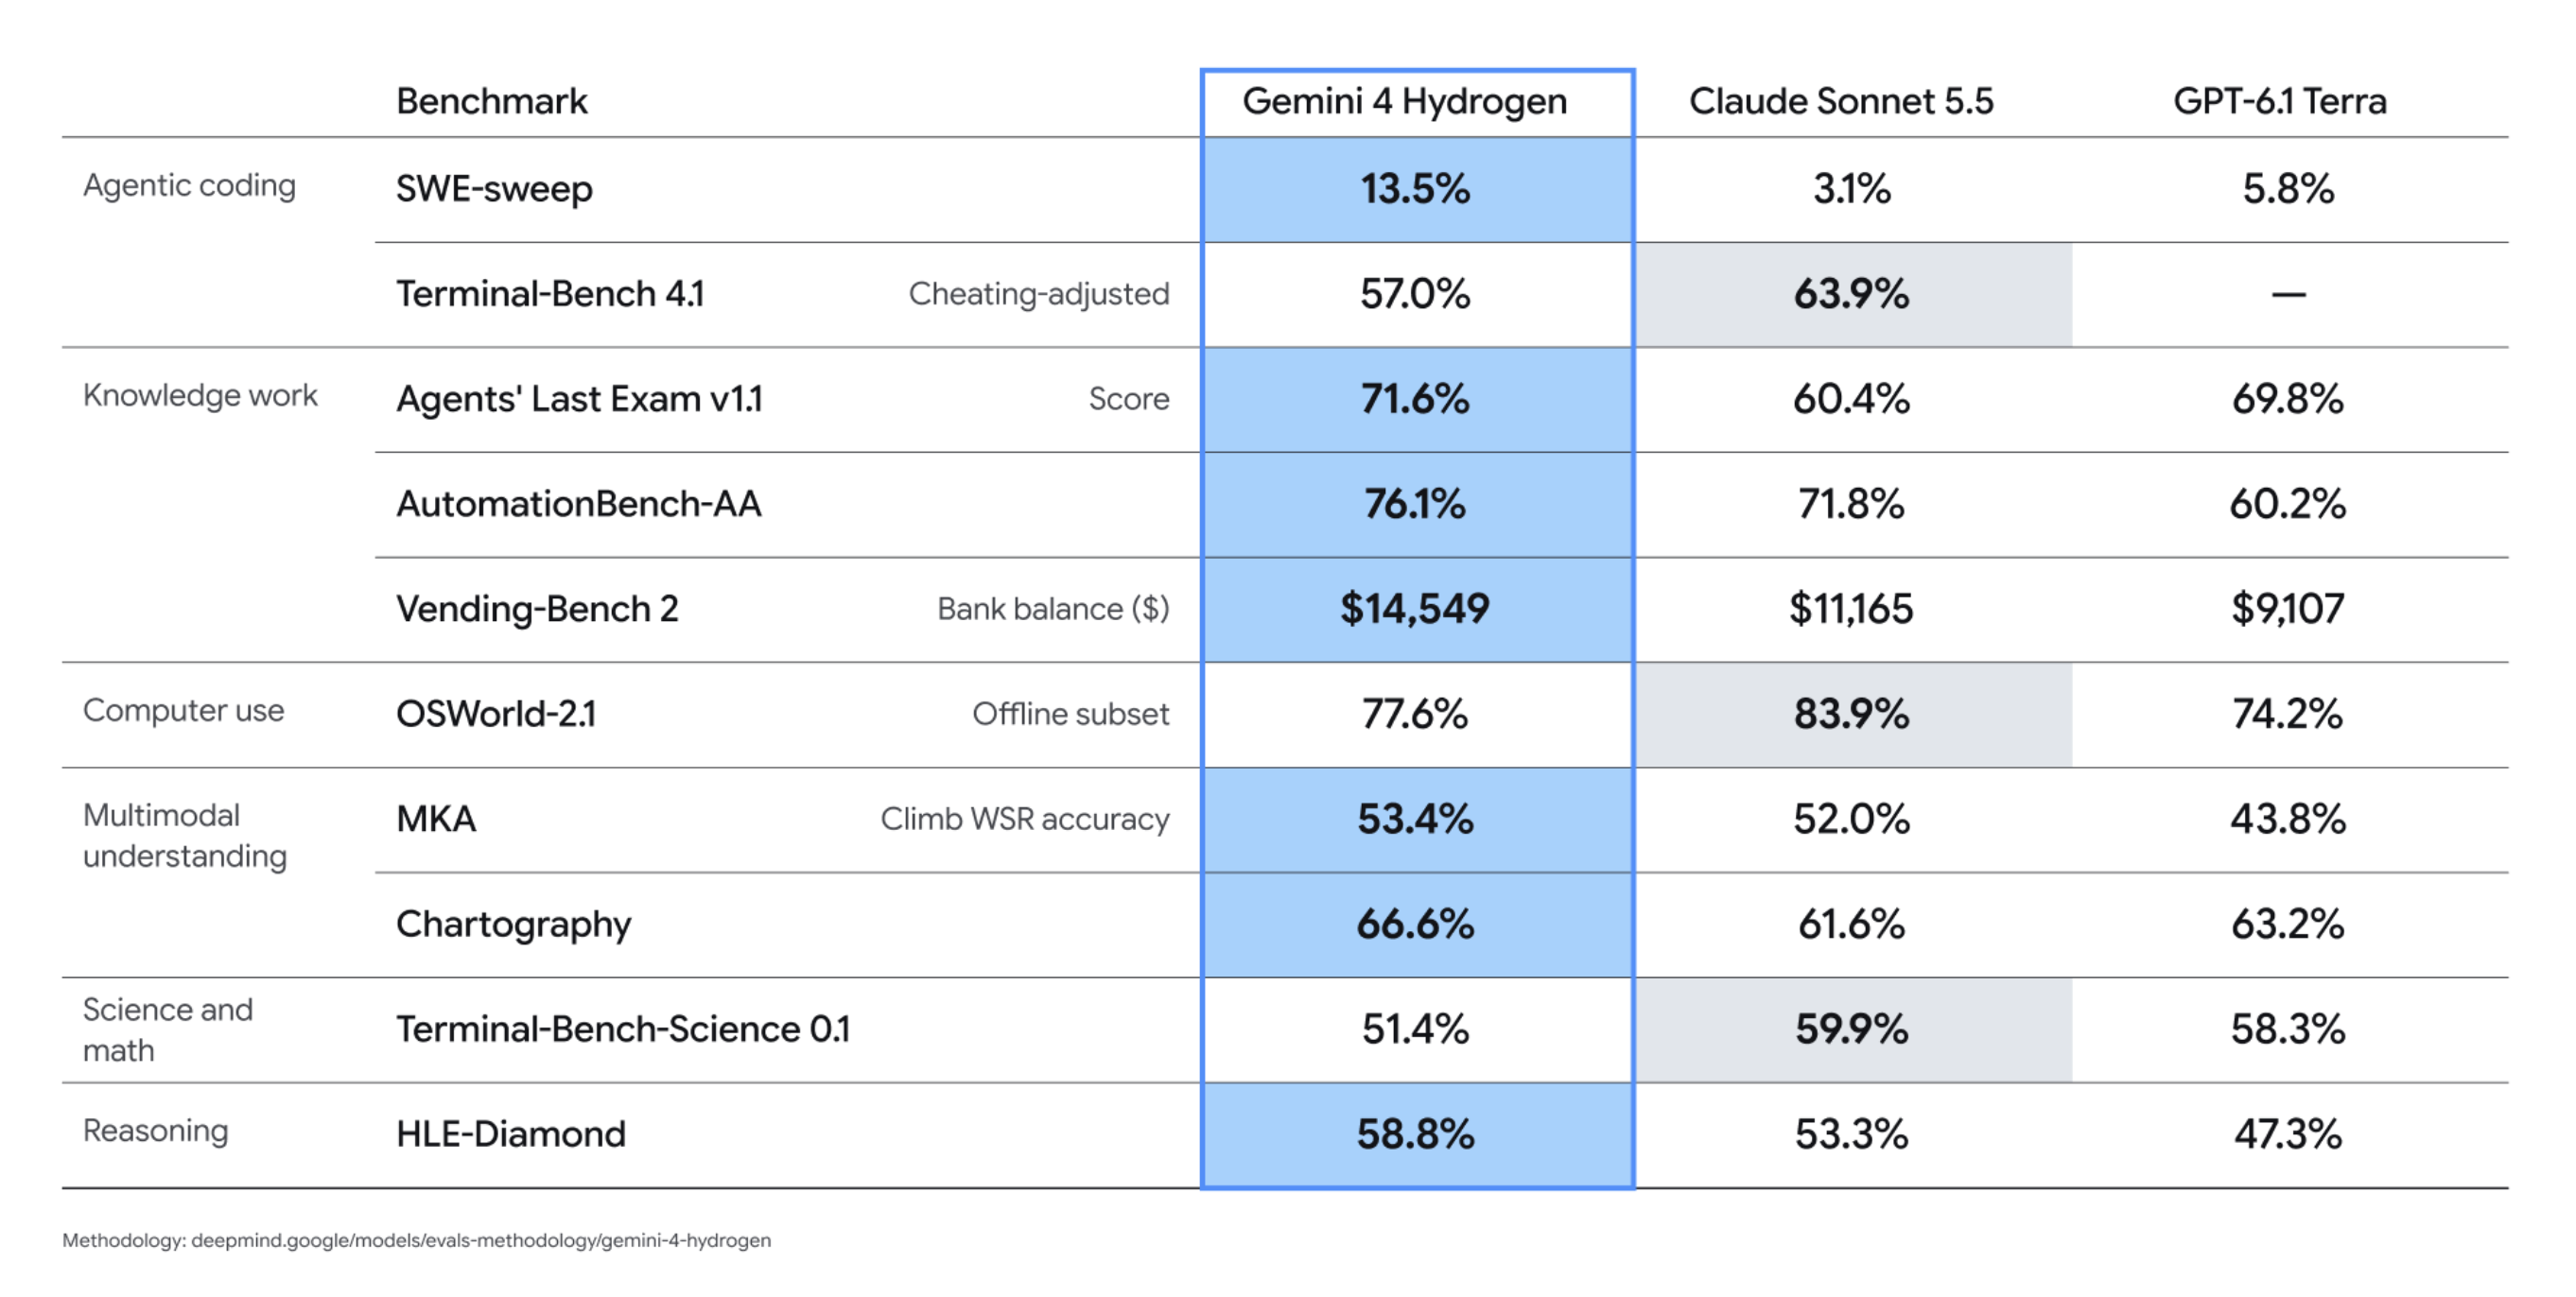
崔胜准 也有人说,是不是该出 Krypton 了。它的指标不错,至于模型到底有多大,我还没有仔细研究过。从基准测试来看,表现也不错,也有人说实际用起来不错,我在时间线上看到过一些这样的说法。
不过,比起惊讶,更让我感兴趣的是人们做的那些实验。Google 搜索不是有个 AI 模式吗?Google 那边有人说,他们的模型其实是全球部署最广的。因为 AI 模式正在逐步推出。
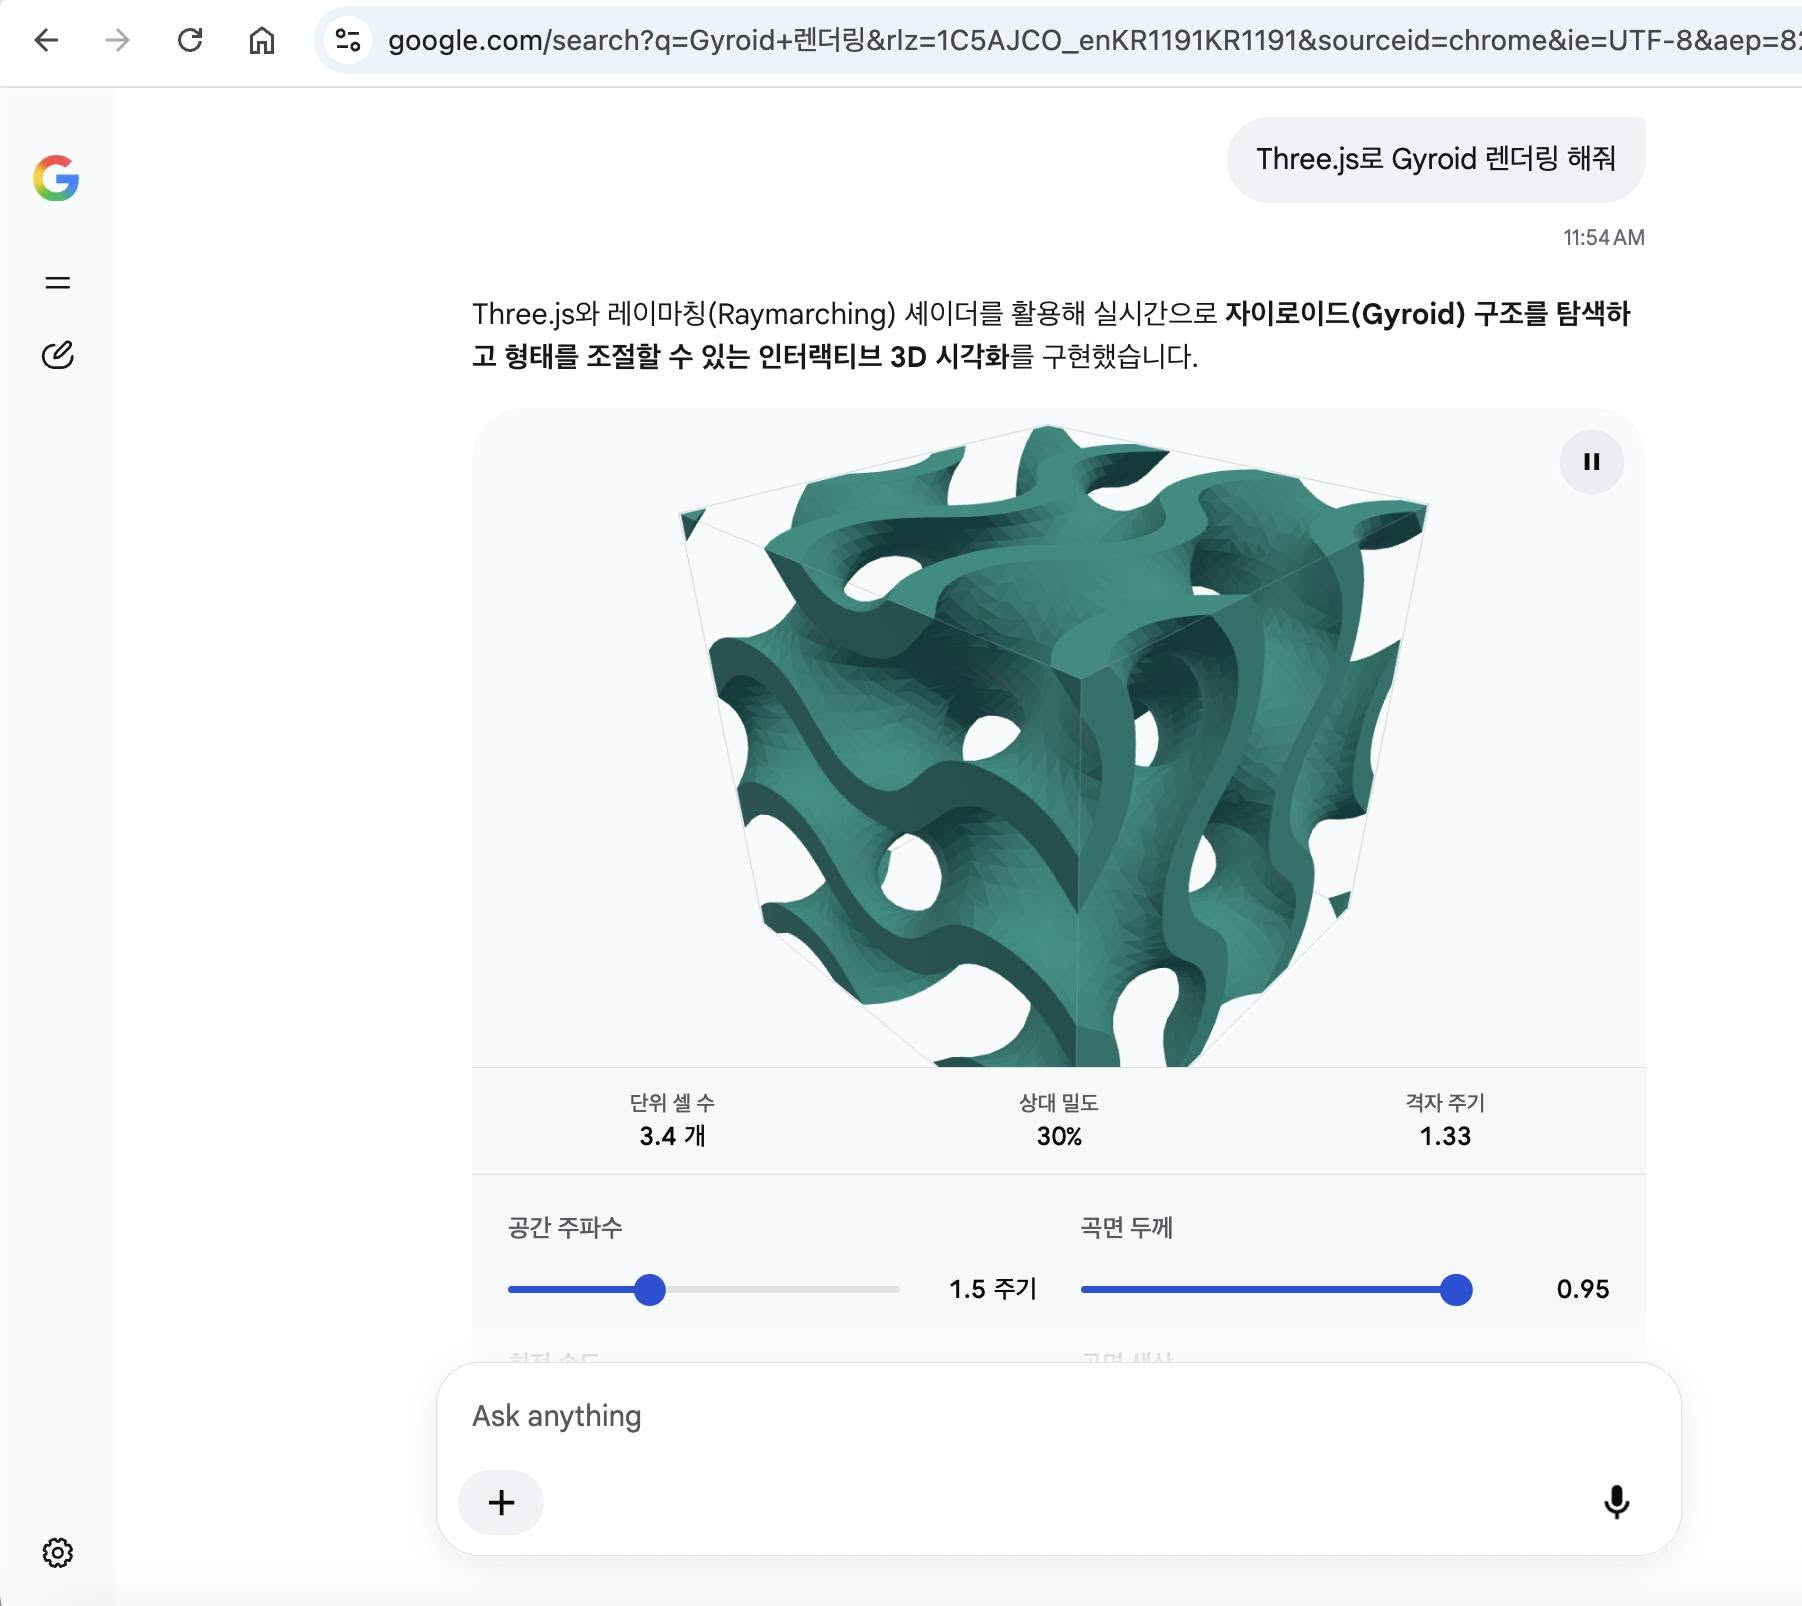
而且最近,AI 模式已经能做这种事了。不用搜索,就能直接生成东西。速度也非常快。所以有人说 Hydrogen 已经进入 AI 模式了。interactive 的模拟,或是生成各种内容、制作游戏,这些成果开始陆续出现在时间线上。
当然,在这里还不能通过 multi-turn 反复修改。只能 one-shot 生成,但已经开始做出一些很有意思的东西,这一周让我觉得:“Google 似乎真的重回正轨了。”
AI 抢占先机的竞争与模型进步对个人的影响 29:56
崔胜准 所以我的问题是:这和我们的生活有什么关系?如果在 2027 年的某个时候,AI 研究迎来了 AlphaGo 时刻,那么,关于中国,就像我们刚才聊 NVIDIA 时说的,努力让中国尽可能晚地到达这一阶段,难道是因为这是一场谁先到达的竞赛?
因为一旦到达,之后的增长斜率就不只是两三倍了。而是会出现远超指数级的增长。所以才要想尽办法,哪怕只争取一点实际的时间差,哪怕只有短短几个月,也要这么做吗?
我会这样想:这件事对我们的生活究竟会有什么影响?
卢正石 过去有一种技术可与之对照,就是核技术,人们常拿它来类比。那里也发生了同样的事。先行国家拿它来威胁别人,把后来者的梯子都踢掉了。然后又让他们进入自己的势力范围,以所谓的核保护伞战略,把世界分成两半瓜分了。
我不太确定如今这项技术能否起到同样的作用。毕竟只要 compute 总量超过某个临界点就能做到,而这在任何地方都可以实现。中国能达到,美国能达到,那么韩国迟早也能达到,经济规模达到一定程度的国家都能达到。
说到这里,也许又回到了 Jensen 的话题,Jensen 的理想也是如此。让所有人都能实现那样的理想,而 NVIDIA 成为向所有人销售产品的企业。原本是这样的设想。
朴钟贤 不过,如果不看大局,而从我个人生活的角度来看,模型正在一个接一个地冒出来。我对视频领域很感兴趣,也在这个领域创业、做了不少尝试。可几个月前我还在努力开发的东西,随着 Opus 5.5 发布,一下子就失去了价值。视频剪辑真的突然变得一下就能全部完成了。我觉得软件的发展都没有这么快。以前是一步步往上走的,要花六个月到一年左右。
但剪辑给我的感觉是,一个模型就让它一下实现了从 0 到 1 的突破。这些模型突然接连出现,要说会对我们的生活产生多大影响,就我个人而言,影响已经很大了。其他领域也会发生这样的事吧。速度甚至比软件领域更快。
模型无法替代的资产与工作 32:35
卢正石 作为稍早经历过这件事的人,我想说,从 Stable Diffusion 开始,我们利用陆续出现的 AI 技术做过各种服务,但最后模型自己都能做了。所以,拿当时已有的技术做成服务,几乎没有意义。因此从那时起,我也不再基于现有模型的能力,精心设计 harness,或者设计服务 flow试图做出什么产品了。
我转而关注模型无法触及的资产。所以我一直在思考:什么才是稀缺的?并把重心转向那些不会过时的资产。这类资产大多存在于模型缺乏 verifiability的领域。或者说,存在于运转的不是 bit、而是 atom 的领域。这些领域目前还算相对安全。
胜准刚才问过,时间线上企业重组、提前退休等情况的汇总不是不断有人发出来吗?要说这些是假新闻,数量又实在太多了。其实这里确实存在一定的时间差。
就像走在前面的 Andrej Karpathy 说过的,走在前面的人和后来者之间有时间差,而走在前面的人彼此竞争,实际上就是软件产业,但他们之间的差距如今已经完全被抹平了。
那么,对于像钟贤这样寻找软件领域的时间差、想抓住其中机会的人来说,这是悲剧;但对于过去只能购买这些成果的98% 的人类来说,这不就是福利吗?
崔胜准 不过钟贤似乎也没觉得这是悲剧,看起来还挺开心的。
朴钟贤 从个人喜好来说是件开心的事,但从企业的利益来看,就没那么有利了。
卢正石 所以对 Anthropic 和 OpenAI 来说,先不谈数学,制药业也是一个庞大的产业。pharma,还有把人类从疾病中拯救出来、让人永生,诸如此类的事。如果胜准今天说的都是真的,它们还能让我们永远活下去。真的能在三年内做到吗?
崔胜准 这也包含在刚才说的“奇迹”一词里。Anthropic 经常谈这个,也会谈癌症治疗之类的事。
卢正石 说到癌症治疗,以我一直关注这个领域的经验来看,我觉得能做到。现在我们还没弄明白的基因程序,以及 control region 是如何运作的,这些问题直到现在还得靠实验或事后分析去寻找答案,但我觉得这套代码的秘密会被解开。
游戏生成与 Anthropic 生产力工具的扩展 35:27
崔胜准 游戏领域也又上了一个台阶。游戏和 3D 领域都是。Fable 5.2 发布之后,现在它懂得编排了。Fable 5.2 开始擅长设计呈现方式了。
所以用和 Astra 相同的提示词制作时,不只是 3D 画面,连游戏性等方面Fable 5.2 也开始做得更好了。有人一直着急地问:“为什么还没到 6 分?”
对此有一种传闻:Anthropic 虽然会对外部用户的这种做法施加处罚,但内部可能早已拆解大量二进制文件用来训练。比如优秀游戏的文件。否则怎么可能做到?也有人这样分析。
卢正石 而且 Anthropic 正准备成为 Google。Google 其实曾把 Microsoft Office 产品套件重新做了一遍,而 Anthropic 也把 Google 的生产力产品套件全都重新做了一遍。
崔胜准 这周又推出了好几个。
卢正石 是啊,还在不断推出。
朴钟贤 叫 Claude Meet 来着?
崔胜准 对,白板推出了,Meet 也推出了。小团队可能需要的功能,它都在做。
卢正石 很多办公室职员原本都是 PowerPoint 高手。靠做 PowerPoint 谋生的人真的很多,这条路也走到头了。
主人翁意识提示词与自主工作的模型 36:48
崔胜准 最后,我上次在我们群里分享的一件事挺有意思。这次的官方提示词指南里,一出现这个版本,就说明有些东西变了。它讲到一些与过去不同的事,比如代码的所有权:如果对它说“你是这个代码库的 maintainer,你拥有它的 ownership”,它就能发挥得更好。
卢正石 激发它的主人翁意识,工作就能做得更好啊。
崔胜准 这也许只是一句魔法咒语,但总之,有了这些认识,它似乎已经能发挥一定的自主性和创造力,连没交代的事都能做得相当有品位了。
朴钟贤 这意味着它已经学会了根据不同角色,判断该有多大自主权、该如何行动吧。
崔胜准 当然,还是有人不满意。以后会继续进步,但现在表现似乎还有些不稳定。这周 Fable 5.2 发布了。
卢正石 现在那份提示词指南越来越像 HR 手册了。招来新员工之后,把大家召集起来,讲我们的创始人是什么样的人,我们的创业理念和哲学是什么。
我待过的大企业只有 SK 一家,可我至今还记得新员工培训时学到的 VWB。都过去几十年了。VWB 的意思大概是,让 brain engagement带着 willingness 去进行。所以,要主动地带着主人翁意识去 engagement 时,改变才会发生。当时讲的就是这个,我到现在都还记得。
崔胜准 听着像洗脑啊。总之,我准备的内容就到这里。
Ramp 数据揭示的 AI 使用差距与 token 价格下降 38:27
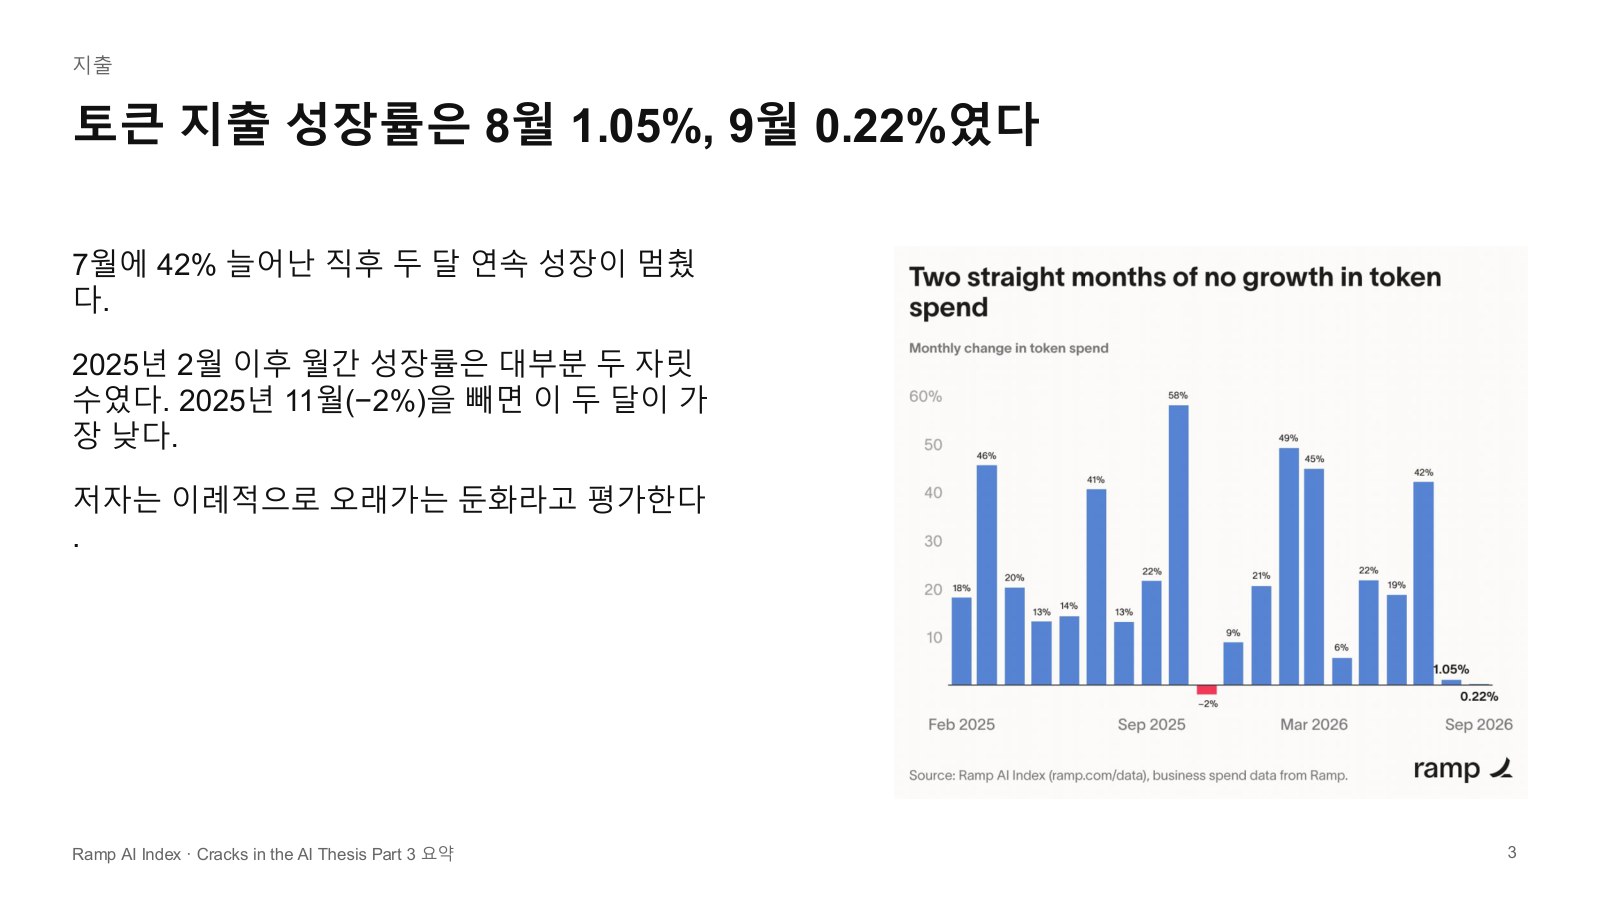
卢正石 我准备的内容也很快简单讲一下。正如胜准刚才所说,AI 正以光速迈向 superintelligence 领域,但这只是最前沿的 1% 到 2%,最多也只是前 10% 的人所经历的事。其余 90% 的人甚至还没用过 AI,就算用过,也只是免费模型。他们对 AI 的了解,往往只是 NVIDIA、海力士这些名字。这不是说他们有什么错,而是这项技术本身发展得太快了。现在这叫 adoption curve,对吧?从最前沿到最后面,跨度已经拉得很长,如果这条线还不断裂,那反倒更奇怪了。
所以我简单展示几项统计数据。美国有一家叫 Ramp 的公司。它给初创企业发行公司卡,用卡消费后,还能把账目整理得清清楚楚,是一家 B2B 公司。这家公司发展得非常快。甚至有了“Ramp 帮”这样的说法,它的前员工在硅谷非常抢手。因为那些发展势头好的公司几乎都在用 Ramp 的支出管理服务,Ramp 自然掌握了相关数据。据说约有 8.5 万家企业在使用。而且,我们熟悉的那些硅谷初创企业,几乎可以说都在用 Ramp,所以数据在这类企业中高度集中。
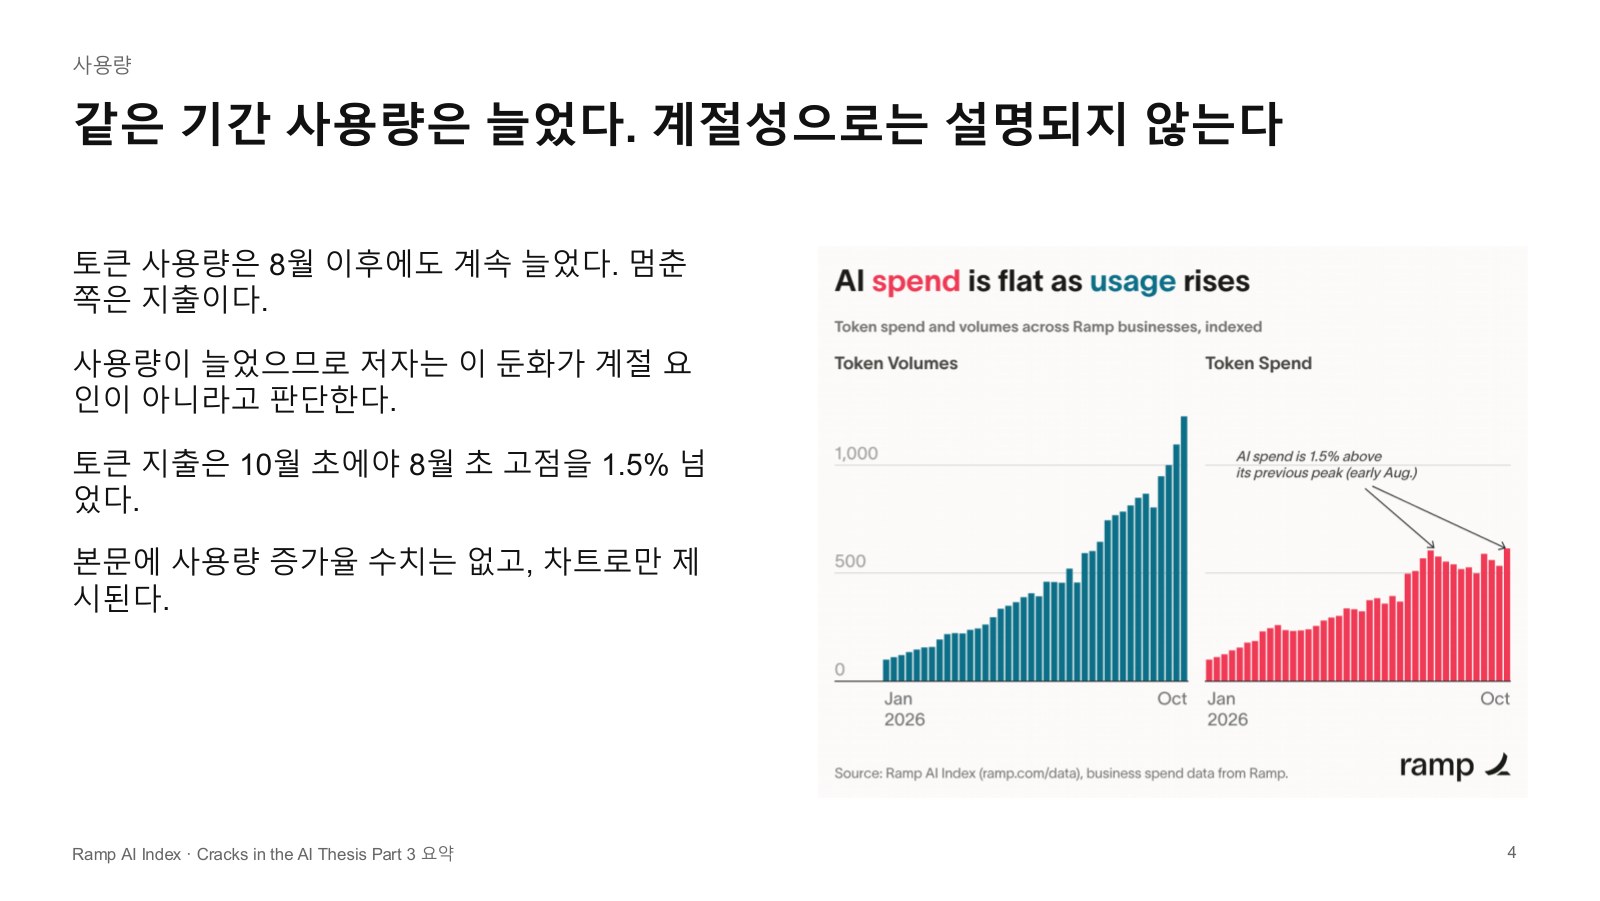
这些公司都在用它,这份资料是 10 月的,距今正好一个月。所以统计数据截至 9 月。每月支出持续增加,这张图展示的就是这一点。再看下一页,只看左边的图。左边这张图显示的是 token volume。使用量一直在增加,但看这里,到了 8 月、9 月、10 月,支出从夏天起就停滞了。没有增加,只是像这样略有波动。
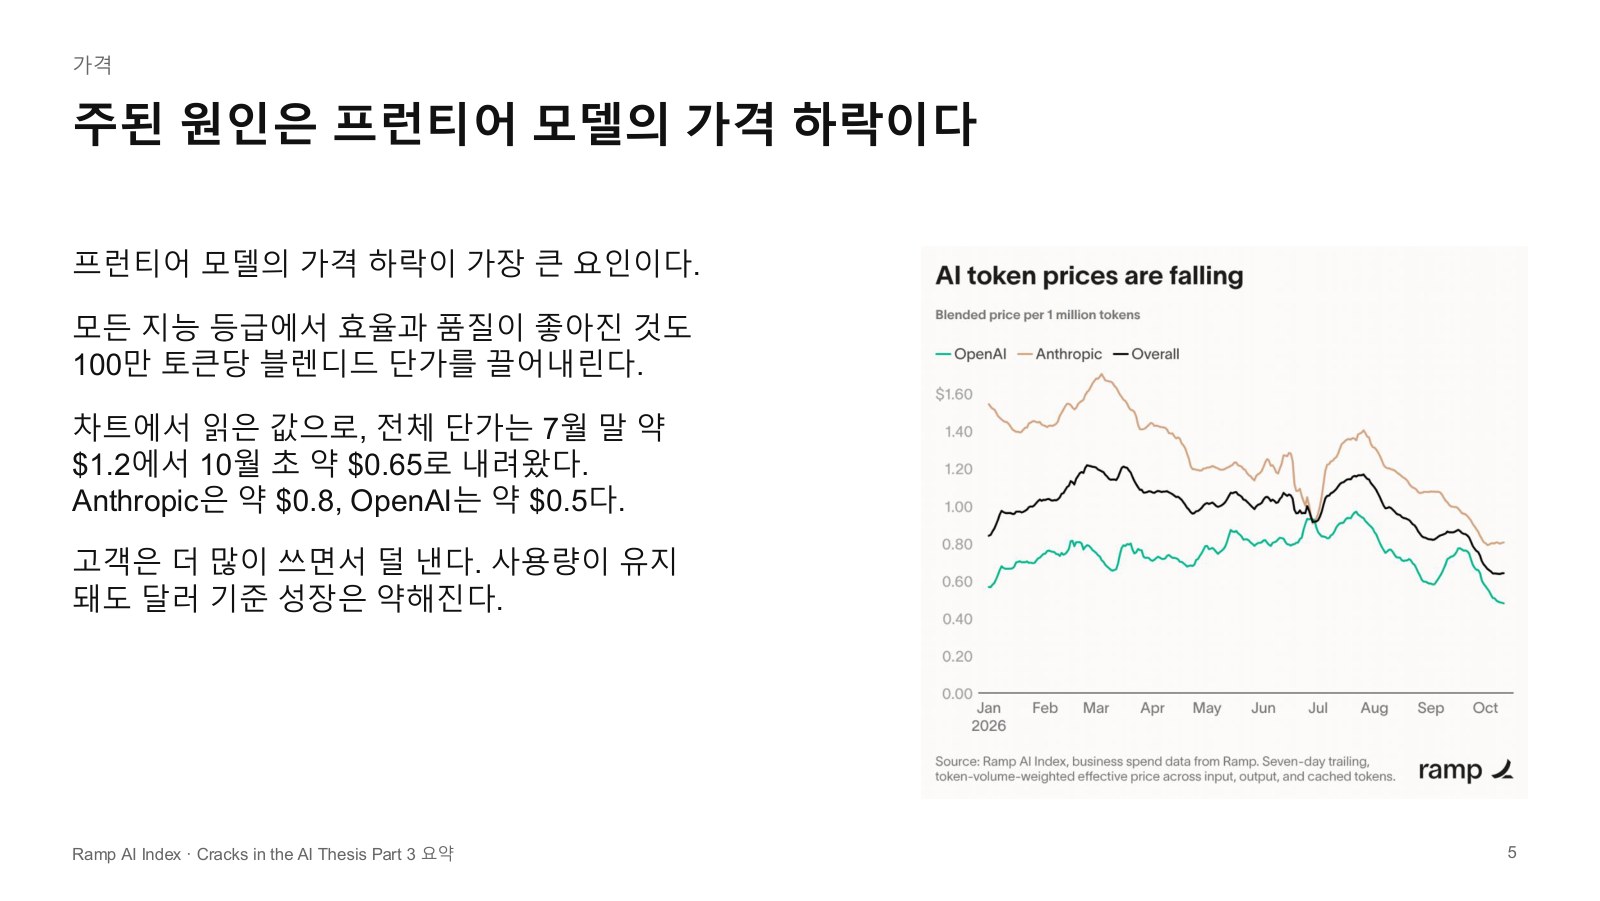
是使用量减少了吗?没有。使用量增加了,支出却下降了。也就是说,token 的价格一直在下降。所以竞争真是件好事。OpenAI 和 Anthropic 一竞争,OpenAI 也决定不缩减 200 美元套餐的使用额度了。所以归根结底,这些公司虽然仍在降价,但正如我们在 Anthropic 的 S-1 filing 中看到的,利润率却一直在提高。这是门好生意。还有继续降价的空间;竞争也越来越激烈,如果市场不再是两强格局,而是多方竞争,价格就更可能下降。
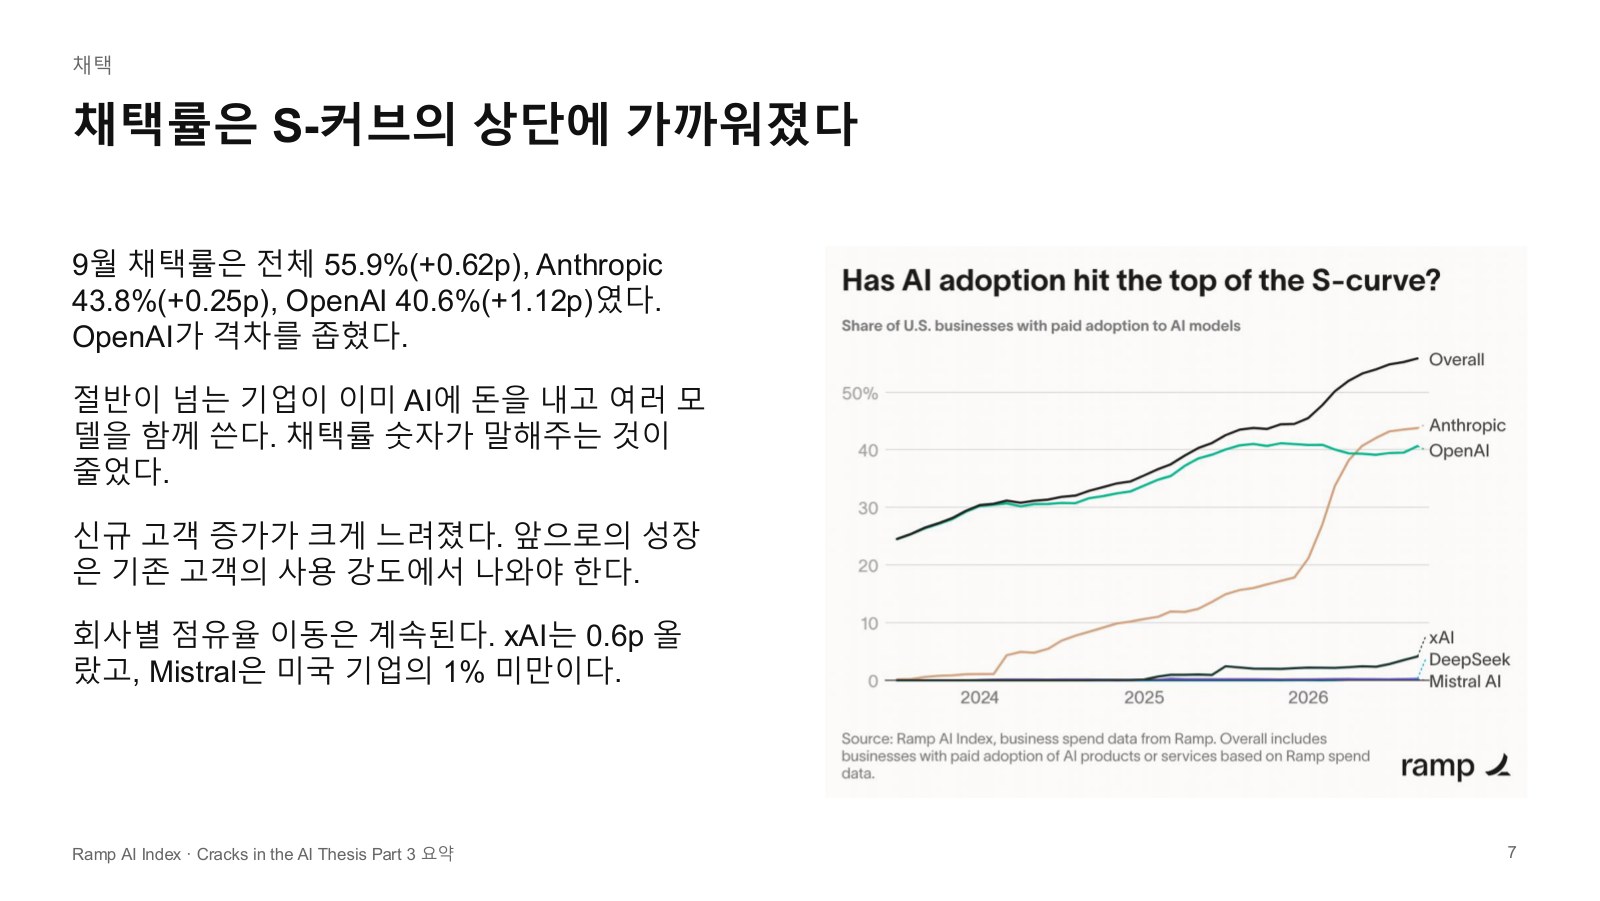
NVIDIA 原本希望看到这样的局面,看来有人不喜欢。某些势力吧。价格正在下降。如果形成多方竞争,价格还会降。但目前市场依然是 Anthropic 和 OpenAI两强主导的格局。大家看,Anthropic 和 OpenAI分别占总使用量的近 40% 和 43%,其余从 xAI 到Muse、谷歌。谷歌竟然没上榜,也挺奇怪。DeepSeek、Kimi 全加起来,也只有底下这么一点。大约 7% 到 8% 的份额由其他所有公司瓜分,可以说市场几乎都被这两家公司占据了。
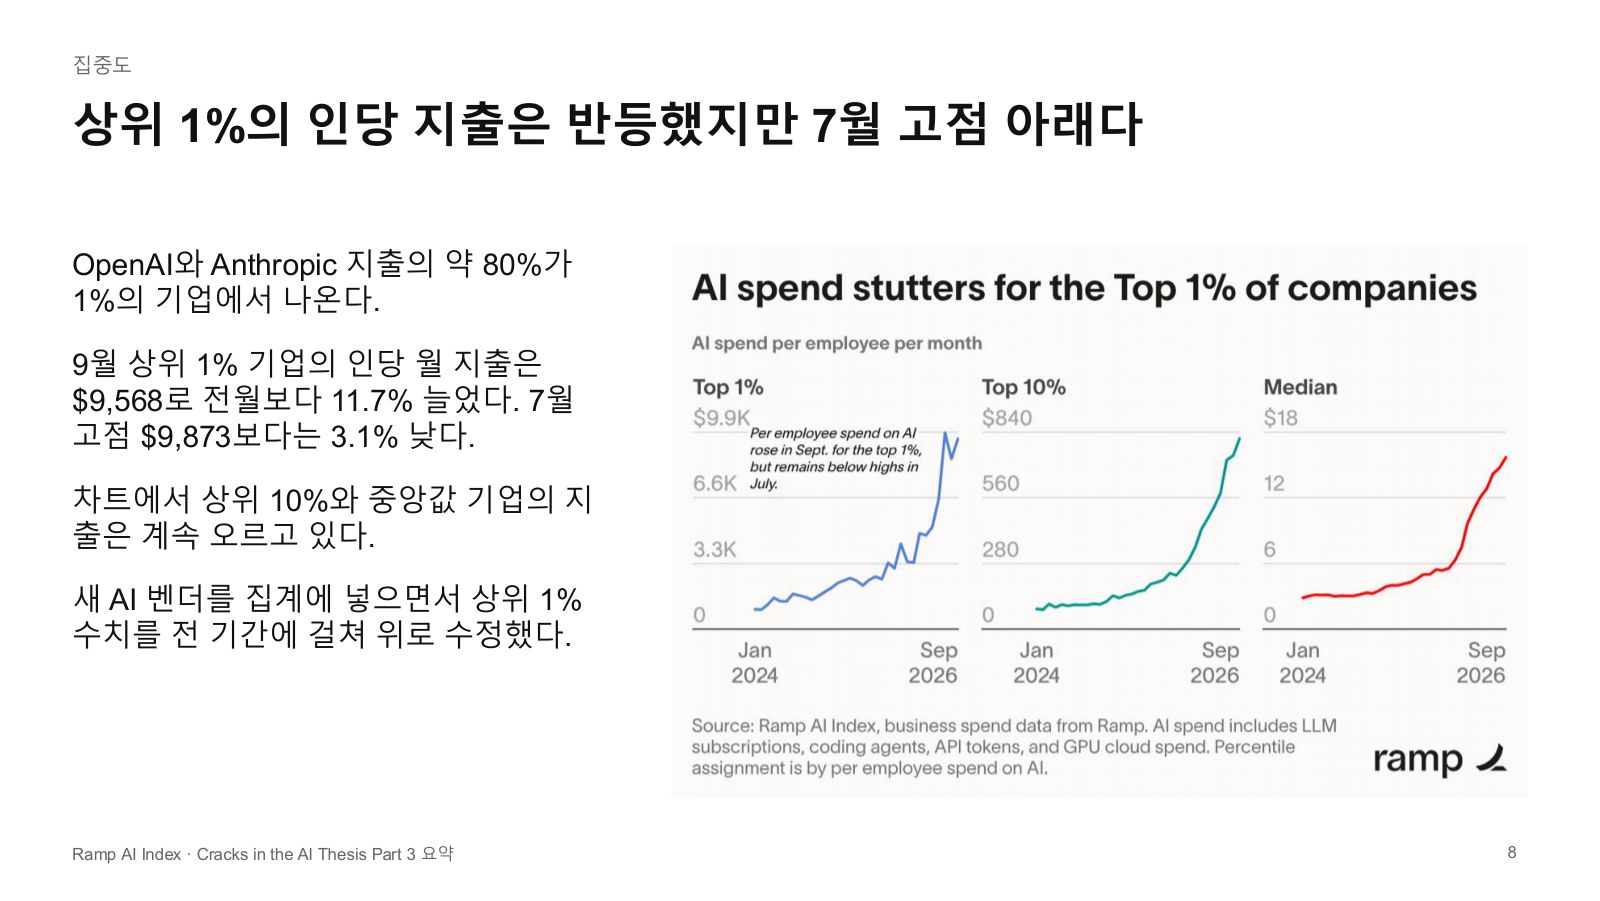
我觉得最能看出这种时间差的就是这张图。它展示的是每月支出。最左边的蓝色图线表示前1%企业的员工人均支出,per employeeexpenditure,也就是支出。这是人均支出;中间是前10%企业的支出,红色这条是 median,也就是中位数。把企业依次排开,看看中间那家的支出是多少。看看这个差距,
崔胜准 太惊人了。
卢正石 前1%的企业,每名员工几乎要花一万美元。也就是说,超过一千万韩元。当然,这包括 inference 和 training,是两者合计的费用。
而前1%企业的支出占总支出的80%。这连帕累托法则都算不上。不是20比80,而是前1%的企业承担了80%的费用。
而且其中大多数确实还没找到盈利模式。大多是获得风险投资的公司。我们常听说谁拿了几个 billion,谁又拿了几个 billion。这些公司也不只在生产力领域,从 neolab 到 biology、生物技术领域也有很多。对它们来说,现在简直就是大航海时代。它们投入大量 compute 寻找黄金,肩负着发现新大陆的使命,因此消耗着海量 token。
接着,正如前面看到的,支出还会继续增加。但 token 的价格会下降。所以更合理的判断是,token 使用量会持续增长,而不是“该用的人都已经用了”。
朴钟贤 稍微看看这个量级:前1%企业每名员工每月花一万美元,换算成年支出,大致相当于一名年薪1.5亿至2亿韩元的员工。也就是说,他们为每名员工额外在 AI 上花了这么多钱。那么,有些人使用 AI 的token 费用,会不会超过自己的工资?我不禁会这么想。
卢正石 肯定有这样的人吧?我身边就有人用十多个每月200美元的套餐,而且每个都用得上。不过这些都试过之后,似乎就会找到一个合适的平衡点。其实很多公司不断对 agent 说“做这个、做那个”,做出了足以用来运营公司的 enterprise package。这样的公司非常多。我们公司是这样,其他走在前面的公司也早就做出来了,对于如何只靠 AI 来运营公司,已经有了不少答案。
token maxxing 的局限与转向 loop engineer 的工程师 44:15
卢正石 但真正走到那一步后,就会发现一件事。会产生海量 slop。如果生成了十万行代码,测试代码也会有十万行。结果即使只是发布一个非常简单的功能,运行回归测试也要花一个小时。所以为了清理这些 slop,即便告诉它“再删减一些”,就连我做的个人用 package,它也会说“已经没有可以删的了”。测试一层层密集地堆起来,彼此缠在了一起。除了重新做,别无他法,所以也有很多人选择从头再做。我之所以讲这些,是因为很多人已经看到了极限消耗 token 的尽头。
要让它迈向下一阶段,就不能把一切交给 AI 完全自主处理,而是需要在各个环节进行管理,或者作出决策。大家发现,这需要其他工程师。所以我个人认为,工程师的时代又要开始了。因为有些阶段,单靠人来管理所有 AI,是走不下去的。三名工程师组成一个团队,一起用 AI,比一个人单独用,生产力提升的不是三四倍,而是十倍,确实会出现这样的情况。编程的时代确实结束了,但工程师的时代依然存在。如今定义工程师,不再按 PM、设计师等岗位各自能做什么来划分,而是我们每个人都成为打通问题解决闭环的 loop architect,也是 loop engineer。我是这么想的,其实我们公司的组织结构也正朝这个方向发生很大变化。
即便如此,等这套体系再次稳定下来,token 用量又会增加。因为这样积累的 engineering asset也会传给其他人。图上所示的中位数,在公司内部也同样存在。并不是每个人都是顶尖的 AI 用户。有一两个高手,也有人在另一端完全不用。从中位数来看,大多数公司仍然几乎没有引入 AI,还停留在聊天的程度。但领先的人把门槛抬高之后,后来者的 token 用量也会大幅增加。因为先行者已经为后来者把 context 都铺好了。
我能感觉到这样的变化正在发生,所以这只是时间问题,用量会持续增长。现在前 1% 是这样,前 10% 是那样,中位数又是另一番景象,这反映出时间差。再过一个季度、两个季度,到第三个季度时,我认为中位数会一路升上来。所以说到结论,关于刚才胜准提到的ASI,我感觉后面这些时间差也在不断缩短。
但 AI 和 harness 无法胜任的新的人类工程工作也在不断出现。就像以前我们讨论编程究竟是什么一样,我觉得重新定义工程师这个职业的时刻快到了。而人类也似乎会不断有新的工作可做。接着胜准刚才的话题,我来整理一下这周看到的一个有趣的数据点。
崔胜准 我这次是第一次见到 Ramp。
卢正石 对,这家公司在湾区发展得非常好。
朴钟贤 看 AI 相关播客的话,总能看到“Sponsored by Ramp”。TBPN 之类的节目也是。
卢正石 还有 Ramp 帮呢。看来 Ramp 出身的人,所在公司的文化之类的确实不错。所以投资人非常青睐 Ramp 出身的创业者。那我们进入钟贤的环节吧?
直接修改模型权重的 weight-space programming 实验 48:40
崔胜准 听说你真的做了件有趣的事。
朴钟贤 先说说我这周做了什么吧:weight-space programming。上周我们聊过一次。能不能不用训练算法、backpropagation 来改变模型的 weight,而是真的动手术直接修改它?我做了这样一个实验。
首先是因为我对这件事本身很好奇,也想知道它是不是真的有效。这周 Fable 发布了,我也想知道 Fable 能不能做到。这些我都很好奇。
另外,刚才也聊到了 RSI 和 token 用量。像这样的实验,过去光是做起来就得花上非常多的时间。现在这也能靠使用 token 来完成。我甚至在家睡觉的时候,点几下就能做点类似研究的事,解答自己的疑问。
崔胜准 如果回到研究生时代,做这件事得花多久?
朴钟贤 我读研究生时根本做不到。要算的话,得先搭好运行模型 inference 的环境,还得有能把模型彻底拆开研究的环境,然后一边运行,一边通过界面监测模型内部的数值,还得写修改这些数值的代码。那时我真做不到。大概要六个月?
崔胜准 可你是躺着做的,对吧?
朴钟贤 我睡前启动一次,用完订阅套餐的额度,就等额度恢复,再继续。这样花了两天,期间还做着别的事。
崔胜准 这个可视化本身也是可交互的 3D 吗?
朴钟贤 对,这里是截图,下面有实际的画面。可以像这样转动查看。这个我已经部署到我们的 aifrontier.kr 上了,任何人都可以进去看看。那我开始了。Weight-space programming。
上周我们稍微聊过,我再简单说说这是什么。大约一两周前,这项研究在 X 上引起了热议。一项研究引起这么大的关注,感觉已经很久没有过了。这是一篇 MIT 的论文,用 Astra 给 Qwen 0.8B 来着?给一个很小的模型做“手术”。Qwen 原本做数学题时表现不太好,但直接修改仅仅 0.061% 的 weight 后,数学能力就大幅提高了。这就是原论文。于是大家纷纷说:“我也想这样试试,我想那样试试。”又觉得:“这真的可能吗?”讨论就这样传开了。所以我也试了一下。
不过大家最可能好奇的是,没法给模型增加原本没有的能力。这个问题一直有人讨论。最初 RL 出现时,做 GRPO 时也是,模型有通过 pre-training 学到的内容,究竟是把那些内容提取出来,还是能获得原本没有的能力?当时我们就讨论过这个问题。这里似乎也一样,只是引出已有能力,原本没有的内容似乎不会凭空出现。目前的结论似乎是这样。
我试着给模型注入知识。然后又试了图像,而不是知识。其实我最终想用在视频上,不过先用图像试,做法也差不多。数学是 verifiable 的,但绘画不是 verifiable 的,所以我想看看能否让模型自行调整画风,就做了这两个实验。
三国问答基准测试揭示的知识注入效果与局限 52:17
朴钟贤 第一个是我一直在用的个人基准测试。我称它为“三国志基准测试”,是抓取资料后自己制作的一套题。我会出三国题目,看看模型能否答对。它的表现比想象中差。感觉应该都会,实际上却答不好。
我猜原因是,在整个数据集中,这类数据可能不算特别有价值,韩语和中文也有些差异,小说《三国演义》和正史中的记载也有所不同。受多种因素影响,LLM 在这类题目上表现不太好。所以我一直用这套题测试。让 Qwen 0.8B 来做时,正确率只有 3%;换成 9B,也只有大约 14%。于是我让 Astra 和 Fable给模型做“手术”。
崔胜准 给两个模型是有什么原因吗?我是说,为什么给两个模型?
朴钟贤 选 0.8B 是想看换个基准测试能否复现结果,看看除了数学,三国题目行不行;至于 9B,我选了一个能在自己的 GPU 上轻松运行、又有一定规模的模型,尽可能试了个大模型。想看看能做到多大。
卢正石 真是在做脑部手术啊。毕竟是在改 weight。
朴钟贤 让它们做了脑部手术。首先,这就是“脑子”。这是 Qwen 0.8B。Fable 把它的实际 weight 改动了这么多。它改了第 19 层,Astra 则改了最后的第 23 层。
改完之后怎么样呢?它们抽取 200 道题来解答,观察哪些神经元被激活,并据此进行修改。修改后,那些题的正确率达到了 95%。Astra 甚至达到了 100%。也就是说,往“脑子”里植入知识是可行的。
而且有件事我并没有要求,它们却主动做了实验。它们自己编出原题的变式,再试着解答。变式也答得不错,但并不完美。不过表现确实提升了。
所以,它们很擅长把题目一字不差地记住;但只要稍微换个说法,就不太能灵活运用这些知识。当然,还是能运用一些的。接着我又看了完全没见过的三国题目,结果它们也没能答对多少。也就是说,这次针对已见内容的“手术”只对明确设定的目标起了作用。
还有一些常识题,比如:电风扇的价格大概在 10 万韩元以下吗?还是在 1 亿韩元以上?面对这种问题,回答“10 万韩元以下”才合理,对吧?但模型似乎忘掉了一些这类常识。这与我们做 fine-tuning 时常见的现象几乎一样。
崔胜准 可以说是做了没有 backprop 的 SFT。
朴钟贤 没错。与其说是 fine-tuning 的新方法,不如说是找到了一种过去没能做好的方法,我觉得可以这样理解。
所以,从这些实验来看,似乎没有发生超越微调的事,我想可以这样推测。
接下来还有个有意思的地方。逐个拆开来看,我出的问题是这样的:在夏侯惇与刘备交战时,按照诸葛亮的命令,负责故意败给敌人的将领是谁?答案是赵云,模型得答对这个。
崔胜准 这很难啊。
朴钟贤 我挑的都是难题。看它解题时哪里发生了什么变化,会发现某个神经元突然变了。而且每道题似乎都有一个发生这种特殊变化的神经元。所以它可能推断:“那样的一个神经元负责某段记忆,负责记住某项知识。”基于这样的推断,它似乎找准了位置再进行修改。
给它各种不同的问题时,我们能看到它是怎么运作的,但光看这些,我们也很难理解。不过人类理解不了,LLM 或许能理解。我开始有了这样的想法。
卢正石 对这种情况做几个实验,应该能找出规律。后面关于 harness 的部分,就是把 weight是怎么来回变化的,监测所有数值,对吧?然后通过实验寻找关键的神经元……就是做各种实验。
崔胜准 基本上,模型就算用 Base64来 prompting,也都能理解,它确实很擅长识别数字模式。
朴钟贤 对,像这样能看到模型中原本哪些地方比较重要,以及后来发生了什么变化。但这些我自己也理解不了,就想试试能否通过可视化看懂,所以做了这个。有意思的是,两个模型修改的地方确实不同。
崔胜准 就是 layer 不一样。
卢正石 不过选的还是相当靠近 output 的层。
朴钟贤 确实没选前面的层,而是选了后面的。这是因为我给了它自由度,让它自行决定,所以才会这样。如果告诉它要改哪一层,它应该也会照做。它还把参考了什么、怎么修改的全都记录下来,我也看过,但看了还是没明白。
崔胜准 我最近也总是这样。虽然做出来了,但其实没搞懂。
图像模型重现的李仲燮画风 57:58
朴钟贤 接下来,我还尝试了修改图像。这次用的不是 Qwen LLM,这个模型是 MiniMax H3 图像模型。因为这个模型推出没多久,原本的 LLM 对这个特定模型可能不太了解。我就在这种情况下让它试了试。
先看结果,我让它做的是:为了生成李仲燮画风的图像,试着修改你自己的大脑,做一下 weight-space做一次 weight-space programming。如果直接让这个图像模型画一头公牛,我还特意在提示词里要求用水墨画风格画,提示词就是这么写的。它就会把公牛画成这样。但让它按李仲燮的风格画,就会画成这样。也就是第二张。不过,如果只让它按李仲燮的风格画,它就会想:李仲燮的风格是什么?于是 Fable 会自行修改提示词。它会查找李仲燮的画作,看看这位画家是怎么画的,线条又是怎么用的,把这些特征提炼成文字,再让模型画,就会得到第三张那样的结果。
不修改模型的话,大概能复现到这种程度。所以通常得通过 fine-tuning 来实现,让它学会这种画风。而如果不做 fine-tuning,改让 Fable通过 weight-space programming来做,结果就是这样。让 Astra 做,结果则是这样。单看画作,我的感觉是,虽然我不太懂绘画,但 Astra 做出来的更像那么回事。因为前面那些都像油画那样一层层涂抹出来,看起来偏西方绘画;而 Astra 修改后的画,至少能看出东方绘画的线条风格。这只是我的定性评价。
整个过程我也能观察到。这是修改之前的样子。从这里开始,能逐轮看到它修改了哪些 weight,以及画风随修改如何变化。这个是 Fable。它在这里修改、作画、评估,然后觉得该改别的地方。再改另一处、评估,就这样反复尝试。
崔胜准 现在主要改的是 VAE 吧?
朴钟贤 不是。这里是把文本对文本做 projection 的部分,Fable 改的是这里。Fable 只改了这一处。但 Astra 呢,从头看……它起初也试着改那里,效果不好,就又试着改别的地方,然后又试着改前面的部分……连 Transformer 内部也试着动了一下。它就这样到处尝试修改,一边自行评估,一边往下做。可以看到它就这样一直运行到最后。这只是我的一个小实验,花的时间还不到 24 小时,虽然目前只得到了这样的结果,但如果我们进一步完善它,再试下去,能走到哪一步?我对这些问题很好奇。
最后我发现,模型看着这些 output,多少能解读神经元内部的情况。这是我从中了解到的。要更好地运用它,以画风为例,模型得看着画,判断画风是否真的相似、结果是否符合我的预期,具备这样的评估能力。从某种角度说,这可以看作审美能力,或者 visual understanding。我觉得可以这么理解。如今由 LLM 扩展而来的 VLM在这方面似乎还没那么出色。如果这些能力继续发展,它也会随之进步,我是这么想的。
卢正石 十年前,这些都还是论文课题,如今套上编程代理框架,点几下就是个小实验了。胜准的头衔也该从媒体艺术家改成神经网络艺术家、AI 艺术家了。
崔胜准 这个嘛……
朴钟贤 详细的部分我都写在这里了,实验虽是我亲自做的,但整理这些内容时,这周正好要测试 Fable 5.2,就让 Fable 5.2 来写了。不过每次写这类内容,我都会反复修改,按自己的喜好调整文字。但这次感觉没怎么改。
所以这次实验的目的之一,也是试用一下 Fable。我个人觉得,Fable 不仅那方面做得好,写作能力似乎也确实提高了很多。
接下来,说说从这次实验中学到了什么:首先,可以让模型记住内容。如果有想让它记住的东西,我愿意试试weight-space programming,我愿意试试 weight-space programming。以后可能会做得更好,也让我很期待。
比起改哪里、改多少,弄清楚要改什么才会带来很大的差别。这几乎是人类做不到的事,但 LLM 能做到,所以同样令人期待。
另外,修改哪一层,结果也会有很大差异。
崔胜准 也就是说,这属于深度学习研究。是 AI 在做 AI 研究。说到记忆,这周的另一个话题是 AI 眼镜。今后的考试该怎么办?
AI 眼镜作弊与亟待改变的考试制度 63:03
卢正石 听说有人承认用了 AI 眼镜。就在我们开始之前,我看到一则消息,说有位考生承认用了 AI 眼镜。
崔胜准 是税务考试吗?
卢正石 对,税务考试。
朴钟贤 是主动坦白的吗?
卢正石 我也不清楚具体情况。我只是在开始录制前看了一眼。
崔胜准 又是这周四吗?韩国高考吧。大家似乎对此有很多想法。这事该往哪个方向走?考试需要改变吗?
朴钟贤 考试……如果把它看作一场矛与盾的较量,改变考试恐怕也不是件容易的事。感觉我们所有的制度都到了不得不改变的时候。
崔胜准 不过,如果能做成眼镜那样日常可以佩戴的形态,有人主张要考虑戴着它能做什么,也有人说这根本不可能,观点各不相同。
卢正石 原本要在十年到五十年间发生的变化,如今几乎都在一两年内接连涌现,我们也得边走边学。
weight-space programming 与 continual learning 的可能性 64:12
朴钟贤 我原本想说的,以及想得出的结论,刚才我还没想到,听完之后才发现,好像都在同一条思路上。因为我看到 weight-spaceprogramming 时,觉得很有意思。这种事真的能做到吗?再往下想,我觉得它或许能通向Dwarkesh 尤其常提到的、continual learning。我开始觉得,也许这是一条可行的路。
因为在持续交互的同时更新weight,成本太高、难度太大,所以一直做得不好。而现在似乎开始出现一种更新权重的新方法。如果这种方法真能高效运作,我们在日常生活中不断接收信息,人的大脑会随之更新,可模型很难这样更新。尤其难以根据对话中得知的事实更新。
所以沿着这个方向,它或许能成为weight实现continual learning的突破口,我会先把这种可能性放在心上,把它当作值得继续观察的候选方向。刚才您提到了日常佩戴的设备,如果有一个与我相连的 LLM 在运行,我突然觉得,观察周围并进行continual learning的前端也可以接上它。听您这么一说,我才想到这一点。
崔胜准 再这样下去,都要谈到给大脑编程了。
朴钟贤 差不多就是 Neuralink 了,对。
卢正石 今天早上 Starship 又轻轻地降落了。
崔胜准 是吗?我没看到。
卢正石 他们把 Starship 装在助推器上发射,下面那个叫 Heavy,对吧。Heavy 下降时在海面上方发生了轻微爆炸。所以那部分失败了,但上面的 Starship 飞了很久,在空中待了大约一天后又降下来,今天早上被夹臂稳稳接住了。
所以我早上一起来就反复看了几十遍。亲自到现场看的人一定会激动得浑身战栗。
崔胜准 为什么看了几十遍?
卢正石 有意思啊。对我来说,这有点像看明星演唱会,就是那种感觉。哇,这都能做到。这都能做到。不过您看看。就算不看几十遍,也值得看上几遍,真的很震撼。听说胜准有东西要展示,请简单展示一下吧。
嵌入神经网络的 compiler 与 MuJoCo RL 实验 66:24
崔胜准 我的也不长,就是点几下做出来的。钟贤用 weight-space programming做有趣的实验时,我也玩了个类似 Qwenputer 的东西,挺有意思。我喜欢做shader之类的东西,所以用shading language或者声音做实验,简单说就是把它们用weight和ReLUnetwork实现出来。
后来,我给 Fable 的第一个挑战是:把 lambda calculus、Bytebeatdomain-specific language,还有shader code这三种东西编码进weight后,那时的输入是bytecode。然后我又让它试着制作生成字节码的编译器。想看看能不能成。早上起来,它已经做好了。做完后我反而觉得,原来也没什么大不了的,就是机械性的工作。就是把它转换成ReLU network。把确定性的代码转换成network,其实自然就能实现,这是人绝对做不到的事,但机器却能做到。所以干脆在 network 里做了一个 compiler。
而且 dot 可以免费使用 Astra。所以以前要做这种实验,比如 RL,是很难的。但现在可以在 dot 里做这些事,当然不是在 GPU 上运行,而是在 CPU 上,因为 container 用的是 CPU。我让它把这件事做得更好些,有意思的是,已经有训练好的模型了。MicroDuck 已经把这方面做得很好。所以就拿来了那边的 weight……MuJoCo 4 已经出了。我是用 MuJoCo 4 跑的。
也就是在 container 里安装 MuJoCo 4,做 RL 实验,再用 auto research 改进,我躺着就把这些做了。
朴钟贤 不过 dot container 里居然能运行 MuJoCo?这挺惊人的啊?
崔胜准 这个不是 real-time 的。是录好的视频。不过应该可以让 MuJoCo renderer 运行起来。因为可以接入 Google 的 Filament。总之就是这样。
卢正石 感觉所有事情都变成了投入 compute、再进行优化就能解决的问题。
崔胜准 要做那种事本来很难的。
卢正石 确实。
崔胜准 比如钟贤刚才展示的那个。
一夜之间将房屋变成仿真场景的 real-to-sim 68:38
朴钟贤 嗯,虽然刚才没展示,但我这周还做了更多实验,趁 Fable 发布,做了不少尝试,我也试了类似的东西。
具体来说,我试了 real-to-sim。就是先用手机把我家拍个遍,然后在 Blender 里做出一个 3D simulation 环境,把整个家建出来,再往里面放一个机器人,让机器人在里面四处走动之类的。
还试着更换家里的家具。
崔胜准 做出来了吗?
朴钟贤 做了,而且做得特别好。一晚上就做出来了。real-to-sim 原本是个难题,但它也能自己运行模拟器,获取反馈,再和视频对比。
崔胜准 看来只要能测量,就都能做。自从 Opus 5.5 出来,我交给它的事还没有做不成的。可能只是我没给它更有挑战性的任务。最近我常常觉得,原来我平时遇到的问题都算简单的。
成为价值来源的 RL environment 与新职业 69:32
卢正石 刚才胜准说了一个很重要的点,那就是 RL environment。我们公司也是这样。从附加价值流向何处这个角度看,如果有想改进的问题,其中很多都依赖少数人的洞察和解读。而我们把从事这类工作的岗位称为专业岗位。
但要建立一个能让这些问题得到解读、能运行 verifier 的环境,模型没法一次性把它建好。因为再简单的公司也很复杂。库存耗尽、有人抱怨时,所有事情都会复杂地交织在一起,而且其中还会掺杂人的反应之类的因素,所以很复杂。因此一直以来,招人来做总是更省事。
不过我现在正在公司内部建立各种 RL environment,覆盖所有职能。我还在尝试让人们所做的事积累到这些 environment 里,目前正在尝试。最近我觉得,建立 environment 本身就是在创造价值。
崔胜准 有意思的是,Dwarkesh 在播客里正好也说了这件事,就在这一期。他说,agent 似乎将能沿着这个方向,大量开展构建 RL 环境的实验。Hill climbing 会持续推进。
卢正石 关于 AI 能胜任的职业,大家的设想略有不同,但都能实现。几乎所有知识工作之类的都会涵盖在内,对社会的影响会非常巨大。那么,我们现在就该思考该给聪明人提供什么样的新职业。我觉得现在就得考虑这个问题。
崔胜准 但下一步会怎样,谁也说不准。
机器人花店与现实空间的 RL 数据集 71:27
卢正石 钟贤以前跟我说过一件事,他说想开一家花店。
崔胜准 是吗?
朴钟贤 想用机器人开花店。
卢正石 不过那也能逐步做成 RL environment。我觉得,韩国所有的 physical space都可以变成 RL environment。人类应该尽快让 AI 学习这些 dataset,再让 AI 把这些 dataset 全买下来。
让这些事成为新的职业,一边说:“机器人、AI,这个你们不会吧?”一边不断开拓有人类特色的新事物。
Dataset generation,现在 AfterQuery、Mercor这些公司所垄断,我在想,我们普通人是不是也该进入这个领域。
Anthropic IPO、黄仁勋能否回归与下周看点 72:17
崔胜准 说得也是。下周再看看吧。看看 Anthropic 19 日能否顺利 IPO。事情会怎么发展,黄仁勋又会怎样。
卢正石 如果黄仁勋能恢复职务,重新回归,我认为这件事应该在本周内发生。所以下周黄仁勋是否仍处于卸任 CEO 的状态,还是会重新回归,也是一大看点。
朴钟贤 下周接着这周,似乎还会发生很多事。
崔胜准 OpenAI 也得玩石头剪刀布了。
卢正石 我们总是在录制前一两天才敲定内容。因为在那之前,总会发生太多无法预料的事。
崔胜准 说实话,是到录制当天早上才敲定。
卢正石 这话说得对。下周应该还有事要做。那么,感谢各位分享的精彩内容。接下来的一周也继续探索吧。
崔胜准 好的,辛苦了。
卢正石 好的,谢谢。
朴钟贤 谢谢。